3 一般原则
本章通过使用离散事件仿真(discrete-event simulation),为复杂系统的建模建立一个共同的框架。本章涵盖所有离散事件仿真模型的基本构件:实体(entity)与属性(attribute)、活动(activity)以及事件(event)。在离散事件仿真中,系统是依据其在每个时点的状态来建模的;依据流经系统的实体以及代表系统资源的实体来建模;依据引起系统状态改变的活动和事件来建模。对于那些系统状态仅在离散时间点上发生变化的系统,离散事件模型是适合的。
本章的讨论聚焦于仿真语言与仿真软件(统称为仿真软件包,simulation package)的离散事件概念与方法学。
本章介绍并解释所有离散事件仿真包所蕴含的基本概念与方法学。这些概念与方法学并不依附于任何特定的软件包。许多软件包使用的术语与本章所用的不同,而且大多数软件包都配备了若干高阶构件,以便在各自的应用领域中使建模更为简单直接。例如,本章讨论实体的基本抽象概念,但不涉及某些软件包中内置的、更为具体的实体实现(如机器、输送带和车辆),这些构件是为了便利制造、物料搬运或其他领域的建模而设置的。
第 1 节讨论离散事件仿真的一般原则与概念、事件调度/时间推进算法(event-scheduling/time-advance algorithm),以及三种流行的世界观(world view):事件调度(event scheduling)、过程交互(process interaction)和活动扫描(activity scanning)。第 2 节介绍列表处理(list processing)的一些概念,列表处理是离散事件仿真软件中更为重要的方法学之一。
1 离散事件仿真中的概念
本章专门讨论动态的、随机的(即涉及时间且包含随机成分的)并且以离散方式变化的系统。本节将展开讨论这些概念,并提出一个用于建立系统离散事件模型的框架。主要概念先给出简要定义,随后以示例加以说明:
系统(system) 一组随时间相互交互、从而实现一个或多个目标的实体(例如人和机器)的集合。
模型(model) 系统的一种抽象表示,通常包含用以状态、实体及其属性、集合、过程、事件、活动和延迟来描述系统的结构性、逻辑性或数学性关系。
系统状态(system state) 一组变量,包含了在任意时刻描述系统所需的全部信息。
实体(entity) 系统中需要在模型中显式表示的任何对象或构件(例如,一台服务台、一位顾客、一台机器)。
属性(attributes) 某一给定实体的性质(例如,等待顾客的优先级,某个工件在作业车间中的加工路线)。
列表(list) 一组(永久或临时)关联起来的实体,按某种逻辑方式排序(例如,当前所有处于排队线上的顾客,按"先到先服务"或按优先级排序)。
事件(event) 改变系统状态的一次瞬时发生(例如,一位新顾客的到达)。
事件通知(event notice) 一条关于将在当前或某个未来时刻发生的事件的记录,以及执行该事件所需的一切相关数据;该记录至少应包括事件类型和事件时间。
事件列表(event list) 未来事件的事件通知所组成的列表,按发生时间排序;也称为未来事件列表(future event list, FEL)。
活动(activity) 一段规定长度的时间(例如服务时间或到达间隔时间),其长度在开始时即已知(尽管它可能是以统计分布的形式定义的)。
延迟(delay) 一段长度不确定、无法预先确定的时间,在其结束之前无法知道其长度(例如,顾客在后进先出排队线中的延迟,在延迟开始时还取决于未来的到达)。
时钟(clock) 表示仿真时间的变量,在后续示例中称之为 CLOCK。
不同的仿真软件包对相同或相似的概念使用不同的术语——例如,列表有时被称为集合(set)、队列(queue)或链(chain)。集合或列表用于保存实体和事件通知。列表中的实体总是按某种规则排序,例如先入先出或后入先出,或者按某种实体属性(如优先级或到期日)排名。未来事件列表则总是按事件通知中记录的事件时间排名。第 2 节讨论处理列表的若干方法,并介绍一些对有序集合或列表进行高效处理的方法学。
活动通常代表服务时间、到达间隔时间,或其他任何持续时间已经由建模者刻画并定义的处理时间。活动持续时间的指定方式有若干种:
a. 确定性——例如,总是恰好 5 分钟;
b. 统计性——例如,以等概率从集合 2、5、7 中随机抽取;
c. 依赖于系统变量和/或实体属性的函数——例如,一艘铁矿石船的装载时间是该船允许载重量与每小时装载吨位装载率的函数。
无论以何种方式刻画,活动持续时间在其开始的那一瞬间都可由其规定算出。其持续时间不受其他事件发生的影响(除非如某些仿真软件包所允许的那样,模型中包含取消或推迟正在进行的活动的逻辑)。为跟踪活动及其预计完成时间,在仿真时刻某一活动持续时间开始时,生成一条事件通知,其事件时间等于该活动的完成时间。例如,若当前仿真时间为 CLOCK 100 分钟,且一项恰好 5 分钟的检验时间刚刚开始,则生成一条事件通知,规定事件类型(检验结束事件)与事件时间(100 + 5 = 105 分钟)。
与活动相反,延迟的持续时间并非由建模者预先指定,而是由系统状况决定。延迟的持续时间常常需要测量,并且是模型运行所期望的输出之一。通常,延迟在某组逻辑条件成立或一个或多个其他事件发生时结束。例如,顾客在排队线中的延迟可能取决于排在前面其他顾客的人数与服务持续时间,也可能取决于服务台与设备的可用性。
延迟有时称为条件等待,活动称为无条件等待。活动的完成是一个事件,常称为主事件(primary event),通过在 FEL 上放置一条事件通知来管理。与之相对,延迟则通过把相关实体放置到另一个列表(或许代表一条排队线)上来管理,直至系统状况允许处理该实体为止。延迟的完成有时称为条件事件或次事件(conditional or secondary event),但这类事件并不用事件通知表示,也不会出现在 FEL 上。
这里所考虑的系统都是动态的,即随时间变化的。因此,系统状态、实体属性与在活动实体数、集合的内容,以及当前正在进行中的活动和延迟,都是时间的函数,并随时间不断变化。时间本身由一个称为 CLOCK 的变量表示。
例 1:呼叫中心,再度审视
考虑《电子表格中的仿真示例》一章例 6 中的 Able–Baker 呼叫中心系统。一个离散事件模型具有以下构件:
系统状态 ,时刻 正在等待接受服务的呼叫者数量;,取 0 或 1,指示时刻 Able 是空闲还是忙碌;,取 0 或 1,指示时刻 Baker 是空闲还是忙碌。
实体 除非希望得到某些呼叫者的平均值(参见例 4 和例 5),否则呼叫者和服务台都不需要显式表示,只能通过状态变量来体现。
事件 到达事件; Able 的服务完成; Baker 的服务完成。
活动 到达间隔时间,定义见《电子表格中的仿真示例》一章的表 12; Able 的服务时间,定义见《电子表格中的仿真示例》一章的表 13; Baker 的服务时间,定义见《电子表格中的仿真示例》一章的表 14。
延迟 呼叫者在队列中等待,直到 Able 或 Baker 空闲下来。
模型构件的定义给出了模型的静态描述。此外,还需要对这些构件之间的动态关系与交互作用加以描述。需要得到回答的问题包括:
每个事件如何影响系统状态、实体属性和集合内容?
活动是如何定义的(即,确定性的、概率性的,还是某个其他数学方程)?什么事件标志着每项活动的开始或结束?该活动能否不受系统状态限制就开始,还是它的开始以系统处于某种状态为条件?(例如,一项机加工"活动"只有在机床空闲、未发生故障且不在维修之中的情况下才能开始。)
哪些事件触发每类延迟的开始(与结束)?延迟在什么条件下开始或结束?
时刻 0 的系统状态是什么?应当在时刻 0 生成哪些事件来"预热"模型——也就是使仿真得以启动?
离散事件仿真,是对这样一个系统随时间进行的建模:该系统的全部状态变化都发生在离散的时间点上——即事件发生的那些时点。离散事件仿真(下文简称仿真)通过产生一系列系统快照(system snapshot,或称系统映像)来推进,这些快照表示系统随时间的演化。给定时刻的一个快照(CLOCK t)不仅包含时刻 t 的系统状态,还包含当前正在进行的所有活动及其各自结束时刻的列表(FEL)、所有实体的状态与所有集合的当前成员,以及用于在仿真结束时计算汇总统计量的累积统计量与计数器的当前值。图 1 给出了一个原型系统快照。(并非所有模型都会包含图 1 中所展示的每一个要素。本章各示例中提供了进一步的说明。)
| CLOCK | 系统状态 | 实体与属性 | 集合 1 | 集合 2 | … | 未来事件列表(FEL) | 累积统计量与计数器 |
|---|---|---|---|---|---|---|---|
| t | (x,y,z,…) | (3,t1)- 时刻 t1 发生的 3 型事件;(1,t2)- 时刻 t2 发生的 1 型事件;. . . | . . . |
图 1 仿真时刻 t 的原型系统快照。
1.1 事件调度/时间推进算法
推进仿真时间、并保证所有事件按正确的时序发生的机制,建立在未来事件列表(future event list, FEL)的基础之上。该列表包含所有已安排在未来某个时刻发生的事件的事件通知。安排一个未来事件,意味着在某一活动开始的那一刻计算其持续时间,或从某个统计分布中抽取一个样本;并把该活动结束事件连同其事件时间一起放到未来事件列表上。在现实世界中,大多数未来事件并非事先安排,而只是偶然发生——例如随机故障或随机到达。在模型中,这类随机事件由某项活动的结束来表示,而活动的结束又由一个统计分布来表示。
在任一给定时刻 t,FEL 包含所有先前已安排的未来事件及其相应的事件时间(在图 1 中记作 )。FEL 按事件时间排序,意味着事件按时间先后排列——即各事件时间满足
时刻 t 是 CLOCK 的值,即当前仿真时间。与时刻 对应的事件称为即时事件(imminent event);也就是说,它是接下来将要发生的事件。在仿真时刻 CLOCK t 的系统快照更新之后,CLOCK 被推进到仿真时刻 ,即时事件的事件通知从 FEL 中被移除,然后执行该事件。执行即时事件意味着:基于时刻 t 的旧快照以及即时事件的性质,为时刻 生成一个新的系统快照。在时刻 ,可能会生成新的未来事件,也可能不会;但只要生成了,就要通过创建事件通知并把其放入 FEL 上的适当位置来加以安排。在时刻 的新系统快照更新之后,时钟被推进到新的即时事件发生的时刻,并执行该事件。这一过程不断重复,直至仿真结束。仿真器(或仿真语言)为推进时钟并构建新系统快照而必须执行的一系列动作,称为事件调度/时间推进算法,其步骤列于图 2(并在其后加以解释)。
随着仿真的推进,FEL 的长度与内容不断变化,因此在仿真软件包中对其进行高效管理,将对模型的计算机运行时间产生重大影响。对一个列表的管理称为列表处理(list processing)。在 FEL 上执行的主要列表处理操作是移除即时事件、向列表中添加新事件,以及偶尔移除某个事件(称为事件的取消)。由于即时事件通常位于列表的顶部,移除它的效率是最高的。添加新事件(以及取消旧事件)则需要搜索该列表。这一搜索的效率取决于列表的逻辑组织方式以及搜索的实施方式。除 FEL 之外,模型中的所有集合也按某种逻辑顺序维护,向集合中添加和移除实体同样需要高效的列表处理技术。第 2 节将简要介绍仿真中的列表处理。
FEL 中事件的移除与添加在图 2 中得到说明。事件时间为 的事件 3,比如说是服务台 3 的一个服务完成事件。由于它是时刻 t 的即时事件,因此它在事件调度/时间推进算法的第 1 步(图 2)中被从 FEL 移除。当事件 4(比如一个到达事件)在第 4 步被生成、其事件时间为 时,确定其在 FEL 上正确位置的一种可能做法是进行自顶向下的搜索:
(在图 2 中,假定 位于 与 之间。)另一种做法是进行自底向上的搜索。维护 FEL 效率最低的方式是把它留作一个无序列表(新增项任意放置在顶部或底部),这将要求在图 2 的第 1 步中,在每次推进时钟之前对整个列表进行完整搜索以找出即时事件。(即时事件是 FEL 上事件时间最低的那个事件。)
时刻 0 的系统快照由初始条件以及所谓外生事件(exogenous event)的生成所确定。所指定的初始条件确定了时刻 0 的系统状态。例如,在图 2 中,若 ,则状态 (5, 1, 6) 可以代表系统中三个不同位置上初始的顾客数。外生事件(exogenous event)是"发生在系统之外"、并对系统产生影响的一次发生。一个重要的例子是到达排队系统的事件。在时刻 0,生成第一个到达事件并将其安排到 FEL 上(也就是说,把其事件通知放到 FEL 上)。到达间隔时间是活动的一个例子。当时钟最终被推进到这一首次到达的时刻时,生成第二个到达事件。首先,生成一个到达间隔时间,记为
时刻 t 的旧系统快照
| CLOCK | 系统状态 | 未来事件列表 | ||
|---|---|---|---|---|
| (5, 1, 6) |
事件调度/时间推进算法
第 1 步. 从 FEL 中移除即时事件的事件通知(事件 3,时刻 。
第 2 步. 把 CLOCK 推进到即时事件时刻(即把 CLOCK 从 t 推进到 )。
第 3 步. 执行即时事件:更新系统状态,按需改变实体属性与集合成员关系。
第 4 步. 生成未来事件(若有必要),并把其事件通知按事件时间排序后放到 FEL 上。(例如:在时刻 发生的事件 4,其中 。
第 5 步. 更新累积统计量与计数器。
时刻 的新系统快照
| CLOCK | 系统状态 | 未来事件列表 | ||
|---|---|---|---|---|
| (5, 1, 5) |
图 2 推进仿真时间并更新系统映像。
并把它加到当前时间上, 由此得到的(未来)事件时间 用于确定新的到达事件通知在 FEL 上的位置。这种生成外部到达流的方法称为自举(bootstrapping);它给出了事件调度/时间推进算法第 4 步中如何生成未来事件的一个例子。自举过程在图 3 中得到说明。
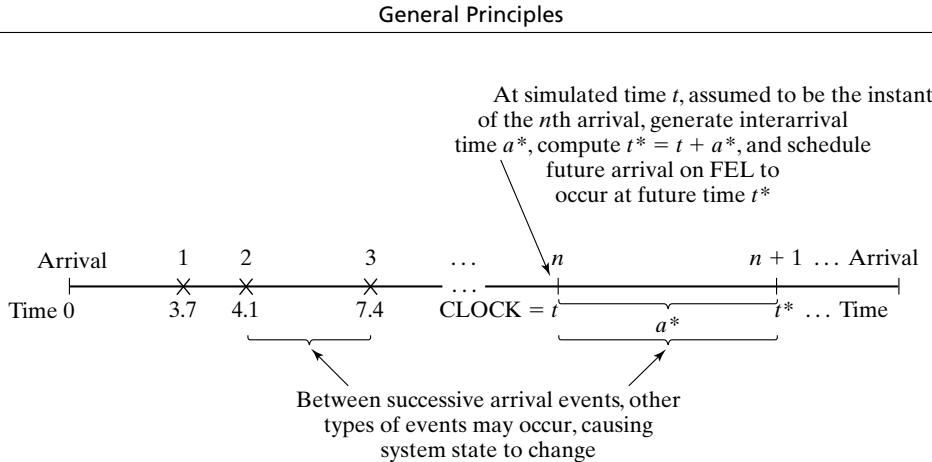
图 3 通过自举生成外部到达流。
生成的前三个到达间隔时间为 3.7、0.4 和 3.3 个时间单位。到达间隔区间的结束是主事件的一个例子。
未来事件如何生成(图 2 第 4 步)的第二个例子,是排队仿真中的服务完成事件。当一位顾客在当前时刻 完成服务时,若下一位顾客已在,则要为下一位顾客生成一个新的服务时间 。下一个服务完成事件将被安排在未来时刻 发生,做法是在 FEL 上放入一条新的、类型为服务完成、事件时间为 t∗ 的事件通知。此外,若在到达事件发生的时刻,服务台组中至少有一台空闲的服务台,则也将生成一个服务完成事件并加以安排。服务时间是活动的一个例子。开始服务是条件事件(conditional event),因为其发生仅在"有顾客在场且有服务台空闲"这一条件下才被触发。服务完成是主事件的一个例子。注意,像开始服务这样的条件事件,是由某个主事件的发生以及系统中盛行的某些条件共同触发的。只有主事件才会出现在 FEL 上。
未来事件如何生成的第三个重要例子,是一台可能发生故障的机器其运行时长与停机时长的交替生成。在时刻 0,生成第一个运行时长,并安排一个运行时长结束事件。每当运行时长结束事件发生时,生成一个停机时长,并在 FEL 上安排一个停机时长结束事件。当 CLOCK 最终被推进到这一停机时长结束事件的时刻时,生成一个运行时长,并在 FEL 上安排一个运行时长结束事件。以此方式,运行时长与停机时长在整个仿真过程中不断交替。运行时长和停机时长是活动的例子,而运行时长结束和停机时长结束是主事件。
每一个仿真都必须有一个停止事件,在此称为 E,它规定了仿真将运行多长时间。停止仿真通常有两种方式:
在时刻 0,把一个停止仿真事件安排在某个指定的未来时刻 。这样,在仿真之前就知道仿真将在时间区间 上运行。例如:仿真一个作业车间, 小时。
运行长度 由仿真本身决定。一般而言, 是某个指定事件 E 的发生时刻。例如: 可以是某个服务中心第 100 次服务完成的时刻; 可以是一个复杂系统发生故障的时刻; 可以是战斗仿真中脱离接触或彻底毁伤(以先发生者为准)的时刻; 可以是配送中心把某一天订单中的最后一个纸箱发运出去的时刻。
在第 2 种情形下, 事先是不知道的。事实上,它完全可能就是仿真所要产生的主要统计量之一。
1.2 世界观
在使用仿真软件包时,甚至在做手工仿真时,建模者都会采取某种世界观或视角来开发模型。最为盛行的世界观是上一节讨论过的事件调度世界观、过程交互世界观和活动扫描世界观。即便某个特定的软件包并不直接支持其中一种或多种世界观,理解这些不同的方法仍可为某一给定系统的建模提供其他思路。
概括前面的讨论,在采用事件调度方法时,仿真分析人员关注的是事件及其对系统状态的影响。第 1.3 节的手工仿真将说明这一世界观。
在使用支持过程交互方法的软件包时,仿真分析人员以过程(process)的思维来思考问题。分析人员用实体或对象及其在流经系统过程中的生命期来定义仿真模型,这些实体或对象会要求资源并排队等待资源。更确切地说,一个过程就是一个实体的生命期。这一生命期由各种事件、活动构成。有些活动可能需要使用一项或多项容量有限的资源。正是这类资源约束和其他约束导致了过程之间的交互,最简单的例子就是:某个实体因其所需要的资源正被另一实体占用,而被迫在队列中(在一个列表上)等待。过程交互方法之所以流行,是因为它具有直观上的吸引力,而且实现该方法的仿真软件包允许分析人员用高层的模块或网络构件来描述过程流,而过程之间的交互则由软件自动处理。
更确切地说,一个过程是一个按时间顺序排列的事件、活动和延迟的列表(其中包含对资源的需求),它定义了一个实体在系统内移动时的生命期。图 4 给出了一个"顾客过程"的例子。在该图中,可以看到两个顾客过程之间的交互:顾客 n + 1 被延迟,直至前一位顾客的"服务结束事件"发生。通常,一个模型中会有许多过程同时处于活动状态,过程之间的交互可能相当复杂。
在仿真软件包中实现过程交互方法的基础(但通常对建模者不可见)是:事件被安排到未来事件列表上,实体在遇到延迟时被放到各个列表上,从而使一个过程暂时挂起其执行,而其他过程继续推进。建模者对相关概念有基本理解、并对所用仿真软件包中内置但隐藏的运行规则有详细理解,是十分重要的。Schriber 与 Brunner [2003] 对这方面提供了阐释。
事件调度方法与过程交互方法都采用可变时间推进——也就是说,当某一仿真时刻的所有事件与系统状态变化都已发生之后,仿真时钟被推进到 FEL 上下一个即时事件的时刻。与之相反,活动扫描方法采用固定时间增量,并用一套基于规则的方法来决定在每个仿真时点上是否有活动可以开始。
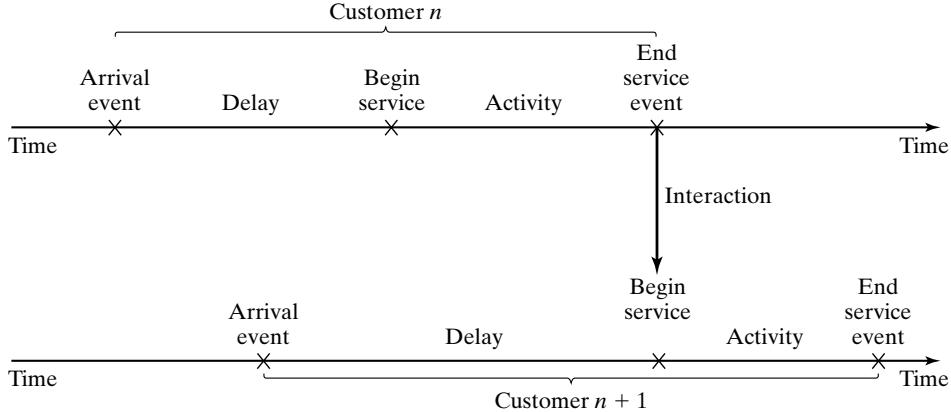
图 4 单服务台队列中两个相互作用的顾客过程。
在活动扫描方法下,建模者关注模型中的各项活动,以及那些使某项活动得以开始的条件(无论简单还是复杂)。在每次时钟推进时,检查每项活动的条件,若条件成立,则相应的活动开始。该方法的倡导者认为活动扫描方法概念简单,并能产生模块化的模型,这类模型日后更易于被其他分析人员维护、理解和修改。然而他们也承认,为查明某项活动能否开始而进行的反复扫描,会导致计算机上的运行速度缓慢。因此,纯活动扫描方法被所谓的三阶段方法(three-phase approach)加以修改(并在概念上变得略微复杂一些);该方法把事件调度的若干特征与活动扫描结合起来,从而既允许可变时间推进,又能在不必要的时候避免扫描,同时保留活动扫描方法的主要优点。
在三阶段方法中,事件被视为持续时间为零个时间单位的活动。按照这一定义,活动被分为两类,称为 B 类和 C 类。
B 类活动 必然要发生的活动;即所有主事件和无条件活动。
C 类活动 以某些条件成立为前提的活动或事件。
B 类活动与事件可以像在事件调度方法中那样预先安排。这就允许了可变时间推进。FEL 中只包含 B 类事件。为查明是否有 C 类活动可以开始或 C 类事件发生而进行的扫描,只在每次时间推进结束、全部 B 类事件完成之后才进行。总之,在三阶段方法下,仿真通过反复执行以下 3 个阶段而推进,直至仿真完成:
阶段 A 从 FEL 中移除即时事件,并把时钟推进到其事件时刻。把 FEL 中所有具有相同事件时间的其他事件也一并移除。
阶段 B 执行所有从 FEL 中移除的 B 类事件。(这可能释放若干资源,或以其他方式改变系统状态。)
阶段 C 检查触发各项 C 类活动的条件,并激活其中条件已满足者。反复扫描,直至没有更多的 C 类活动可以开始、也没有事件发生。
三阶段方法提高了活动扫描方法的执行效率。此外,该方法的倡导者认为,活动扫描方法与三阶段方法特别擅长处理复杂的资源问题——在这些问题中,完成不同任务需要资源的各种不同组合。这两种方法保证:给定仿真时刻被释放的所有资源,都将在任何可用资源被重新分配给新任务之前得到释放。
例 2:呼叫中心,再度登场
对于例 1 中的呼叫中心,若采用面向活动扫描世界观的三阶段方法,则阶段 C 中各项活动的开始条件如下:
| 活动 | 条件 |
|---|---|
| Able 的服务时间 | 有呼叫者在队列中,且 Able 空闲 |
| Baker 的服务时间 | 有呼叫者在队列中,Baker 空闲且 Able 忙碌 |
若采取过程交互世界观,则应从一位呼叫者及其"生命期"的视角来看待该模型。若认为生命期始于到达,则一个顾客过程如图 4 所示。
总之,过程交互方法已被美国最为流行的仿真软件包所采用。另一方面,若干活动扫描软件包则在英国和欧洲颇受欢迎。有些软件包允许模型的一部分采用基于事件调度的形式(若该视角更方便),再与过程交互方法混合使用。最后,还有一些软件包以流程图、框图或网络结构为基础,而仔细考察之下会发现,它们其实是过程交互概念的一种具体实现。
1.3 使用事件调度进行手工仿真
在进行事件调度仿真的过程中,需要使用一张仿真表(simulation table),以记录时间推进过程中的各个相继系统快照。
例 3:单通道队列
考虑《电子表格中的仿真示例》一章例 5 中以某种特殊方法仿真的、只有一个收银台的杂货店。系统由排队线上的顾客加上正在结账的那一位(若有)构成。本例设定停止时刻为 60 分钟。模型具有以下构件:
系统状态 (LQ(t), LS(t)),其中 LQ(t) 是排队线上的顾客数,LS(t) 是时刻 t 正在接受服务的顾客数(0 或 1)。
实体 除通过状态变量体现外,服务台和顾客都不作显式建模。
事件
到达(A); 离开(D); 停止事件(E),安排在时刻 60 发生。
事件通知
(A, t),表示将在未来时刻 t 发生的到达事件; (D, t),表示将在未来时刻 t 发生的顾客离开事件; (E, 60),表示将在未来时刻 60 发生的仿真停止事件。
活动
到达间隔时间,定义见《电子表格中的仿真示例》一章的表 9; 服务时间,定义见《电子表格中的仿真示例》一章的表 10。
延迟 顾客在排队线中花费的时间。
事件通知写作(事件类型, 事件时间)。在本模型中,FEL 将始终包含两条或三条事件通知。到达事件与离开事件的执行效果在图 5 和图 6 中有详细说明。
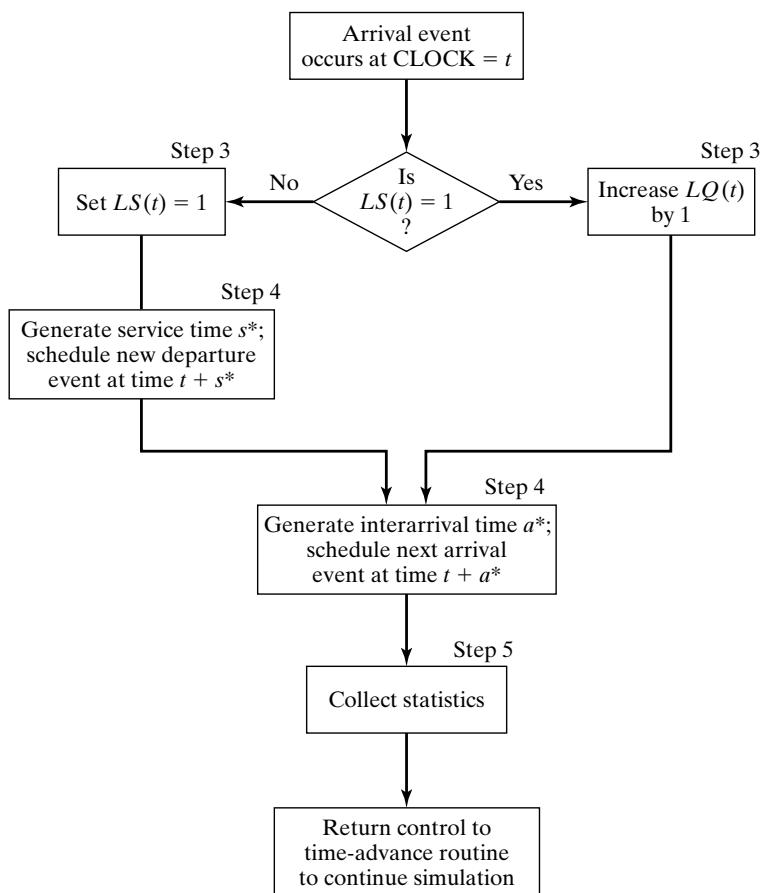
图 5 到达事件的执行。
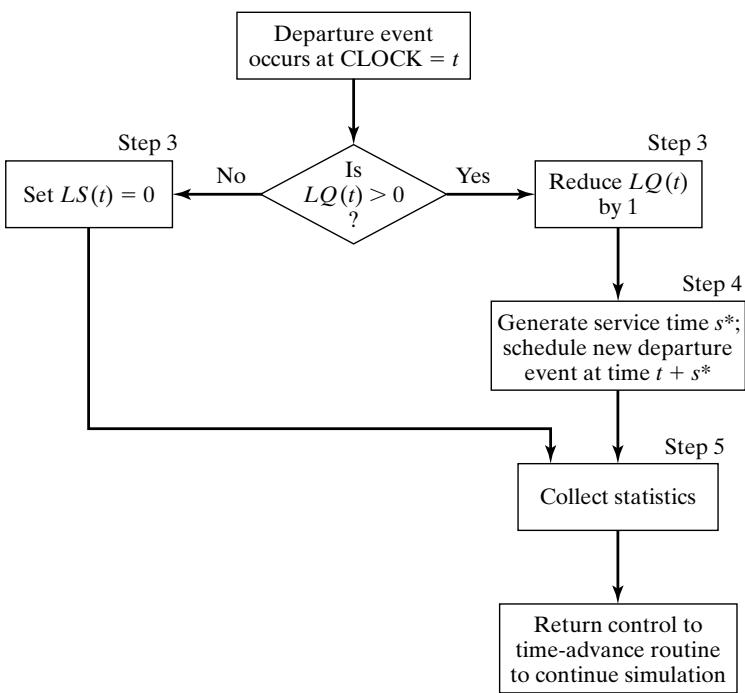
图 6 离开事件的执行。
收银台的仿真表见表 1。读者应遮住除一个之外的所有系统快照(从第一个开始),并尝试根据前一个快照以及图 5 和图 6 中的事件逻辑构建出下一个快照。
| 到达间隔时间 | 1 | 1 | 6 | 3 | 7 | 5 | 2 | 4 | 1··· |
|---|---|---|---|---|---|---|---|---|---|
| 服务时间 | 4 | 2 | 5 | 4 | 1 | 5 | 4 | 1 | 4··· |
初始条件为:第一位顾客在时刻 0 到达并开始接受服务。这一点在表 1 中体现为时刻零 的系统快照,其中 ,且 FEL 上有一个离开事件和一个到达事件。此外,仿真安排在时刻 60 停止。只收集两项统计量:服务台利用率和最大队列长度。服务台利用率定义为服务台总忙碌时间(B)除以总时间 。总忙碌时间 B 与最大队列长度 MQ 将随着仿真的推进而累积。表中另设"备注"一栏以帮助读者( 和 分别是生成的到达间隔时间与服务时间)。
时刻 CLOCK 0 的系统快照一完成,仿真即开始。在时刻 0,即时事件为 。CLOCK 被推进到时刻 1, 从 FEL 中移除。由于 对 ,服务台忙碌了 1 分钟),累积忙碌时间由 增加到 。依据图 6 中的事件逻辑,置 (服务台变为忙碌)。FEL 中还剩三个未来事件,(A, 2)、(D, 4) 和 (E, 60)。仿真 CLOCK 接着被推进到时刻 2,并执行一个到达事件。表 1 剩余部分的解读留给读者完成。
表 1 中的仿真覆盖了时间区间 [0,23]。在仿真时刻 23,系统清空,但下一次到达也发生在时刻 23。在所仿真的 23 个时间单位中,服务台忙碌了 21 个,最大队列长度为 2。当然,这次仿真太短,无法得出任何可靠的结论。注意,仿真表给出的是所有时刻的系统状态,而不仅是所列出的那些时刻。例如,从时刻 11 到时刻 15,有一位顾客正在接受服务,另有一位在排队线中。
当事件调度算法在仿真软件中实现时,软件只维护一套系统状态和其他属性值,也就是说,只维护一个快照(当前的或部分更新的那个)。若打算在 Java 或其他通用语言中实现事件调度,则应遵循如下规则:新的快照只能由此前的快照、新生成的随机变量以及事件逻辑(图 5 和图 6)导出。在推进时钟时,应当忽略以往的快照。当前快照必须包含继续仿真所需的全部信息。
表 1 收银台的仿真表
| CLOCK | 系统状态 | 未来事件列表 | 备注 | 累积统计量 | ||
|---|---|---|---|---|---|---|
| B | MQ | |||||
| 0 | 0 | 1 | (A, 1) (D, 4) (E, 60) | 首次 A 发生 安排下一个 A 安排第一个 D | 0 | 0 |
| 1 | 1 | 1 | (A, 2) (D, 4) (E, 60) | 第二次 A 发生:(A, 1) 安排下一个 A(顾客延迟) | 1 | 1 |
| 2 | 2 | 1 | (D, 4) (A, 8) (E, 60) | 第三次 A 发生:(A, 2) 安排下一个 A(两位顾客延迟) | 2 | 2 |
| 4 | 1 | 1 | (D, 6) (A, 8) (E, 60) | 第一次 D 发生:(D, 4) 安排下一个 D(顾客延迟) | 4 | 2 |
| 6 | 0 | 1 | (A, 8) (D, 11) (E, 60) | 第二次 D 发生:(D, 6) 安排下一个 D | 6 | 2 |
| 8 | 1 | 1 | (D, 11) (A, 11) (E, 60) | 第四次 A 发生:(A, 8) 安排下一个 A(顾客延迟) | 8 | 2 |
| 11 | 1 | 1 | (D, 15) (A, 18) (E, 60) | 第五次 A 发生:(A, 11) 安排下一个 A第三次 D 发生:(D, 11) 安排下一个 D(顾客延迟) | 11 | 2 |
| 15 | 0 | 1 | (D, 16) (A, 18) (E, 60) | 第四次 D 发生:(D, 15) 安排下一个 D | 15 | 2 |
| 16 | 0 | 0 | (A, 18) (E, 60) | 第五次 D 发生:(D, 16) | 16 | 2 |
| 18 | 0 | 1 | (D, 23) (A, 23) (E, 60) | 第六次 A 发生 安排下一个 A 安排下一个 D | 16 | 2 |
| 23 | 0 | 1 | (A, 25) (D, 27) (E, 60) | 第七次 A 发生:(A, 23) 安排下一个到达第六次 D 发生:(D, 23) | 21 | 2 |
例 4:收银台仿真(续)
假设在例 3 的收银台仿真中,仿真分析人员希望估计平均响应时间,以及在系统中停留 5 分钟或更久的顾客所占的平均比例。响应时间是指一位顾客在系统中停留的时间长度。为了估计这些顾客平均值,必须扩展例 3 中的模型,以显式表示各个顾客。此外,为了能够在某位顾客离开时计算其响应时间,还必须知道该顾客的到达时间。因此,将在例 3 的模型构件列表中增加一个以到达时间为属性的顾客实体。这些顾客实体将存放在一个称为"CHECKOUT LINE"的列表中;它们将被记为 C1、C2、C3、. . .。最后,FEL 上的事件通知将被扩展,以指明受影响的顾客是哪一位。例如,(D,4,C1) 表示顾客 C1 将在时刻 4 离开。新增的模型构件如下:
实体
(Ci, t),表示在时刻 t 到达的顾客 Ci。
事件通知
(A, t, Ci),顾客 Ci 在未来时刻 t 到达; (D, t, Cj),顾客 Cj 在未来时刻 t 离开。
集合
“CHECKOUT LINE”,当前在收银台处的所有顾客(正在接受服务或等待接受服务),按到达时间排序。
将收集三项新的累积统计量:S,即截至当前时刻已离开的所有顾客的响应时间之和;F,即在收银台停留 5 分钟或更久的顾客总数;以及 ,即截至当前仿真时刻的离开总次数。这三项累积统计量将在离开事件每次发生时更新;收集这些统计量的逻辑应并入图 6 中离开事件的第 5 步。
表 2 例 4 的仿真表
| CLOCK | 系统状态 | CHECKOUT LINE | 未来事件列表 | 累积统计量 | |||
|---|---|---|---|---|---|---|---|
| S | F | ||||||
| 0 | 0 | 1 | (C1,0) | (A,1,C2) (D,4,C1) (E,60) | 0 | 0 | 0 |
| 1 | 1 | 1 | (C1,0) (C2,1) | (A,2,C3) (D,4,C1) (E,60) | 0 | 0 | 0 |
| 2 | 2 | 1 | (C1,0) (C2,1) (C3,2) | (D,4,C1) (A,8,C4) (E,60) | 0 | 0 | 0 |
| 4 | 1 | 1 | (C2,1) (C3,2) | (D,6,C2) (A,8,C4) (E,60) | 4 | 1 | 0 |
| 6 | 0 | 1 | (C3,2) | (A,8,C4) (D,11,C3) (E,60) | 9 | 2 | 1 |
| 8 | 1 | 1 | (C3,2) (C4,8) | (D,11,C3) (A,11,C5) (E,60) | 9 | 2 | 1 |
| 11 | 1 | 1 | (C4,8) (C5,11) | (D,15,C4) (A,18,C6) (E,60) | 18 | 3 | 2 |
| 15 | 0 | 1 | (C5,11) | (D,16,C5) (A,18,C6) (E,60) | 25 | 4 | 3 |
| 16 | 0 | 0 | (A,18,C6) (E,60) | 30 | 5 | 4 | |
| 18 | 0 | 1 | (C6,18) | (D,23,C6) (A,23,C7) (E,60) | 30 | 5 | 4 |
| 23 | 0 | 1 | (C7,23) | (A,25,C8) (D,27,C7) (E,60) | 35 | 6 | 5 |
例 4 的仿真表见表 2。这里再次使用相同的到达间隔时间与服务时间数据;因此表 2 基本上重复了表 1,只不过加进了新的构件(并删去了备注列)。这些新构件是计算累积统计量 S、F 和 所必需的。例如,在时刻 4,顾客 C1 的离开事件发生。顾客实体 C1 从称为"CHECKOUT LINE"的列表中移除;其属性"到达时间"记为 0,因此这位顾客的响应时间为 4 分钟。于是 S 增加 4 分钟。 增加一位顾客,但 F 不增加,因为其在系统中的时间不足 5 分钟。类似地,在时刻 23,当离开事件 (D, 23, C6) 被执行时,顾客 C6 的响应时间按下式计算:
然后 S 增加 5 分钟,F 和 各增加一位顾客。
对于 23 分钟的仿真运行长度,平均响应时间为 分钟,而观察到的在系统中停留 5 分钟或更久的顾客比例为 。同样,这次仿真远为太短,不足以把这些估计值视为具有任何精度。不过,例 4 的目的正是要说明这样一个观念:在许多仿真模型中,仿真所要提供的信息(例如统计量 和 )在一定程度上决定了模型的结构。
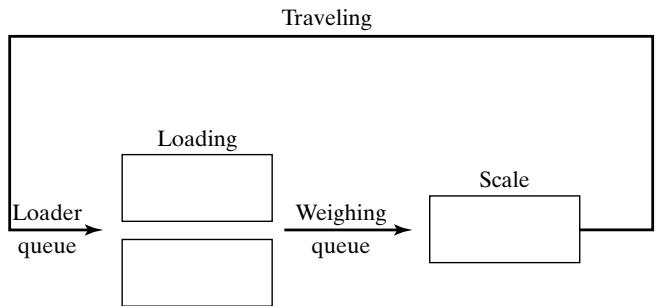
图 7 自卸卡车问题。
例 5:自卸卡车问题
使用六辆自卸卡车把煤炭从一座小矿的入口运到铁路。图 7 给出了自卸卡车作业的示意图。每辆卡车由两台装载机之一装货。装货之后,卡车立即驶往地磅,尽可能快地称重。装载机和地磅都有一条先到先服务的排队线(或队列)供卡车等待。从装载机到地磅的行驶时间认为可以忽略。称重之后,卡车开始一段行驶时间(在这段时间内卡车卸货),随后返回装载机队列。
装载时间、称重时间和行驶时间的分布分别见表 3、表 4 和表 5。这些活动时间的生成方式与《电子表格中的仿真示例》一章第 1.5 节例 2 中服务时间的生成方式完全相同,即利用累积概率把单位区间划分为若干子区间,其长度对应于各个取值的概率。随机数取自附录中的表 A.1,或 Excel 的某个随机数发生器。抽取一个随机数,它落入的区间决定了下一个随机的活动时间。
仿真的目的是估计装载机和地磅的利用率(忙碌时间所占百分比)。模型具有以下构件:
系统状态
[LQ(t), L(t), WQ(t), W(t)],其中
LQ(t) 装载机队列中的卡车数; L(t) 正在装货的卡车数(0、1 或 2); WQ(t) = 地磅队列中的卡车数; W(t) 正在称重的卡车数(0 或 1),均为仿真时刻 t 的取值。
实体
六辆自卸卡车(DT1, . . . , DT6)。
事件通知
(ALQ, t, DTi),DTi 在时刻 t 到达装载机队列(ALQ); (EL, t, DTi),DTi 在时刻 t 结束装载(EL); (EW, t, DTi),DTi 在时刻 t 结束称重(EW)。
表 3 自卸卡车装载时间的分布
| 装载时间 | 概率 | 累积概率 | 随机数区间 |
|---|---|---|---|
| 5 | 0.30 | 0.30 | |
| 10 | 0.50 | 0.80 | |
| 15 | 0.20 | 1.00 |
表 4 自卸卡车称重时间的分布
| 称重时间 | 概率 | 累积概率 | 随机数区间 |
|---|---|---|---|
| 12 | 0.70 | 0.70 | |
| 16 | 0.30 | 1.00 |
表 5 自卸卡车行驶时间的分布
| 行驶时间 | 概率 | 累积概率 | 随机数区间 |
|---|---|---|---|
| 40 | 0.40 | 0.40 | |
| 60 | 0.30 | 0.70 | |
| 80 | 0.20 | 0.90 | |
| 100 | 0.10 | 1.00 |
列表
装载机队列,所有等待开始装载的卡车,按先到先服务排序; 地磅队列,所有等待称重的卡车,按先到先服务排序。
活动
装载时间、称重时间和行驶时间。
延迟
在装载机队列的延迟,以及在地磅的延迟。
仿真表见表 6。为初始化该表的第一行,假定在时刻 0 有五辆卡车在装载机处、一辆卡车在地磅处。为简化起见,按需要从下面的列表中取用(随机生成的)活动时间:
| 装载时间 | 10 | 5 | 5 | 10 | 15 | 10 | 10 |
|---|---|---|---|---|---|---|---|
| 称重时间 | 12 | 12 | 12 | 16 | 12 | 16 | |
| 行驶时间 | 60 | 100 | 40 | 40 | 80 |
当结束装载(EL)事件发生时,比如说是自卸卡车 j 在时刻 t 发生该事件,则可能触发其他事件。若地磅空闲 ,则自卸卡车 j 开始称重,并在 FEL 上安排一个结束称重事件(EW);否则,自卸卡车 j 加入地磅队列。若此时另有一辆卡车在等待装载机,则它将从装载机队列中移除,并通过在 FEL 上安排一个结束装载事件(EL)开始装载。结束装载事件的发生逻辑,以及另外两个事件的相应逻辑,都应当绘制成事件图,正如例 3 中的图 5 和图 6。这些事件逻辑图的构造留给读者作为练习(练习 2)。
作为对读者的帮助,在表 6 中,每当安排一个新事件时,其事件时间写作"t(活动时间)"。例如,在时刻 0,即时事件是事件时间为 5 的 EL 事件。时钟被推进到时刻 ,自卸卡车 3 加入地磅队列(因为地磅被占用),自卸卡车 4 开始装货。于是为卡车 4 安排一个在未来时刻 10 发生的 EL 事件,由(当前时间)+(装载时间) 计算而得。为了估计装载机和地磅的利用率,维护两项累积统计量:
B 两台装载机从时刻 0 到时刻 t 的总忙碌时间
两台装载机从时刻 0 到时刻 一直忙碌,因此在时刻 t 20 有 ——但从时刻 20 到时刻 24,只有一台装载机忙碌;因此在时间区间 [20, 24] 上 仅增加 4 分钟。类似地,从时刻 25 到时刻 36,两台装载机都空闲 ,故 不发生变化。对于表 6 中这次相对较短的仿真,利用率估计如下:
这些估计值不能视为装载机和地磅长期"稳态"利用率的准确估计;要得到准确的估计值,需要一次长得多的仿真,以减小时刻 0 所设条件(六辆卡车中有五辆在装载机处)的影响。另一方面,若分析人员感兴趣的是系统在短时间(比如 1 或 2 小时)内的所谓暂态(transient)行为,在给定初始条件的前提下,那么表 6 中的结果可以视为该暂态行为的代表性结果(或构成其一个样本)。通过进行更多仿真可以获得更多样本,每次仿真具有相同的初始条件,但使用不同的随机数流来生成活动时间。
表 6(自卸卡车作业的仿真表)本可以作一些简化,即不把自卸卡车显式建模为实体——事件通知可以写作 等等,状态变量仅用于跟踪系统中各部分的卡车数,而不管具体是哪些卡车参与了。在这种表示方式下,同样可以收集相同的利用率统计量。另一方面,若要估计"系统"的平均响应时间,或在"系统"中停留超过 30 分钟的卡车所占比例,其中"系统"指装载机队列与装载机以及地磅队列与地磅,那么自卸卡车实体(DTi)连同一个等于到达装载机队列时间的属性就是不可或缺的。每当一辆卡车离开地磅时,该卡车的响应时间即可用当前仿真时间(t)减去到达时间属性来计算。这个新的响应时间将用于更新累积统计量:S,即所有经过"系统"的卡车的总响应时间;F,即响应时间超过 30 分钟的卡车数量。这个例子再次说明:模型在一定程度上的复杂度,取决于所要估计的性能度量。
表 6 自卸卡车作业的仿真表
| CLOCK | 系统状态 | 列表 | 未来事件列表 | 累积统计量 | |||||
|---|---|---|---|---|---|---|---|---|---|
| 装载机队列 | 地磅队列 | ||||||||
| LQ(t) | L(t) | WQ(t) | W(t) | ||||||
| 0 | 3 | 2 | 0 | 1 | DT4DT5DT6 | (EL, 5, DT3)(EL, 10, DT2)(EW, 12, DT1) | 0 | 0 | |
| 5 | 2 | 2 | 1 | 1 | DT5DT6 | DT3 | (EL, 10, DT2)(EL, 5 + 5, DT4)(EW, 12, DT1) | 10 | 5 |
| 10 | 1 | 2 | 2 | 1 | DT6 | DT3DT2 | (EL, 10, DT4)(EW, 12, DT1)(EL, 10 + 10, DT5) | 20 | 10 |
| 10 | 0 | 2 | 3 | 1 | DT3DT2DT4 | (EW, 12, DT1)(EL, 20, DT5)(EL, 10 + 15, DT6) | 20 | 10 | |
| 12 | 0 | 2 | 2 | 1 | DT2DT4 | (EL, 20, DT5)(EW, 12 + 12, DT3)(EL, 25, DT6)(ALQ, 12 + 60, DT1) | 24 | 12 | |
| 20 | 0 | 1 | 3 | 1 | DT2DT4DT5 | (EW, 24, DT3)(EL, 25, DT6)(ALQ, 72, DT1) | 40 | 20 | |
| 24 | 0 | 1 | 2 | 1 | DT4DT5 | (EL, 25, DT6)(EW, 24 + 12, DT2)(ALQ, 72, DT1)(ALQ, 24 + 100, DT3) | 44 | 24 | |
| 25 | 0 | 0 | 3 | 1 | DT4DT5DT6 | (EW, 36, DT2)(ALQ, 72, DT1)(ALQ, 124, DT3) | 45 | 25 | |
| 36 | 0 | 0 | 2 | 1 | DT5DT6 | (EW, 36 + 16, DT4)(ALQ, 72, DT1)(ALQ, 36 + 40, DT2)(ALQ, 124, DT3) | 45 | 36 | |
| 52 | 0 | 0 | 1 | 1 | DT6 | (EW, 52 + 12, DT5)(ALQ, 72, DT1)(ALQ, 76, DT2)(ALQ, 52 + 40, DT4)(ALQ, 124, DT3) | 45 | 52 | |
| 64 | 0 | 0 | 0 | 1 | (ALQ, 72, DT1)(ALQ, 76, DT2)(EW, 64 + 16, DT6)(ALQ, 92, DT4)(ALQ, 124, DT3)(ALQ, 64 + 80, DT5) | 45 | 64 | ||
| 72 | 0 | 1 | 0 | 1 | (ALQ, 76, DT2)(EW, 80, DT6)(EL, 72 + 10, DT1)(ALQ, 92, DT4)(ALQ, 124, DT3)(ALQ, 144, DT5) | 45 | 72 | ||
| 76 | 0 | 2 | 0 | 1 | (EW, 80, DT6)(EL, 82, DT1)(EL, 76 + 10, DT2)(ALQ, 92, DT4)(ALQ, 124, DT3)(ALQ, 144, DT5) | 49 | 76 |
例 6:自卸卡车问题(再访)
对于例 5 中的自卸卡车问题,若采用活动扫描方法,则各项活动的开始条件如下:
| 活动 | 条件 |
|---|---|
| 装载时间 | 卡车位于装载机队列的队首,且至少有一台装载机空闲 |
| 称重时间 | 卡车位于地磅队列的队首,且地磅空闲。 |
| 行驶时间 | 卡车刚刚完成称重。 |
若采取过程交互世界观,则应从一辆自卸卡车及其"生命期"的视角来看待该模型。若认为生命期始于装载机队列,则一个自卸卡车过程可如图 8 所示。
自卸卡车过程
| 延迟 | 装载 | 延迟 | 称重 | 行驶时间 | |
|---|---|---|---|---|---|
| ALQ | EL | EW | ALQ |
图 8 自卸卡车过程。
2 列表处理
列表处理讨论的是处理实体列表和未来事件列表的方法。仿真软件包既显式地(供分析人员使用)、又隐式地(在语言背后的仿真机制中)为分析人员或模型本身提供使用列表并执行列表基本操作的功能。
第 2.1 节描述列表的基本性质和在其上执行的操作。第 2.2 节讨论用数组处理列表,以及用数组下标创建链表;相较于第 2.3 节讨论的、更一般化的动态分配链表,数组是一种描述这些基本操作的更简单机制。最后,第 2.4 节简要介绍若干更为高级的列表管理技术。
本节关于列表处理的讨论,其目的并非让读者准备好在 Visual Basic、C、C++ 或 Java 之类通用语言中实现列表及其处理,而是增进读者对列表及其内在概念和操作的理解。
2.1 列表的基本性质和在其上执行的操作
如前所述,列表是一组有序的或经过排名的记录。在仿真中,每条记录代表一个实体或一条事件通知。
列表是有排名的,因此它们有一个顶部或表头(列表上的第一项)、某种遍历列表的方式(用以找到列表上的第二项、第三项等等),以及一个底部或表尾(列表上的最后一项)。头指针(head pointer)是指向或指示列表顶部记录的变量。有些列表的实现还带有尾指针(tail pointer),它指向列表底部的项。
为便于讨论,将一个实体连同其属性、或一条事件通知,统称为一条记录(record)。实体标识符及其属性是实体记录中的字段;事件类型、事件时间以及其他任何与事件相关的数据则是事件通知记录中的字段。列表上的每条记录还会有一个存放"后继指针"(next pointer)的字段,该指针指向列表上的下一条记录,从而提供了遍历列表的方式。有些列表还需要一个"前驱指针"(previous pointer),以便从底部向顶部遍历列表。
无论哪一种类型的列表,列表处理的主要活动都是向列表添加一条记录和从列表移除一条记录。更具体地说,列表上的主要操作如下:
a. 从列表顶部移除一条记录;
b. 从列表上的任意位置移除一条记录;
c. 向列表顶部或底部添加一条记录;
d. 在列表的任意位置添加一条记录,该位置由排名规则指定。
第一和第三种操作,即在列表顶部或底部移除或添加记录,只需调整两个记录指针以及头指针或尾指针,即可用最少的时间完成;另两种操作则至少需要对列表进行部分搜索。使这两种操作高效,正是列表处理技术所要达到的目标。
在事件调度方法中,当时间被推进、即时事件即将被执行时,首先执行的是移除操作——即把 FEL 顶部的事件从 FEL 中移除。如果要取消某个任意事件,或者要基于实体的某些属性(例如其优先级和到期日)把某个实体从列表中移除以开始某项活动,则执行的是第二种移除操作。当一个实体加入以列表实现的先入先出队列的队尾时,执行的是第三种操作,即把实体添加到列表底部。最后,若某队列的排名规则是"最早到期日优先",那么实体到达该队列时,就必须被添加到列表中由到期日排名规则所确定的位置,而不是顶部或底部。
在计算机上进行仿真时,无论是通过通用语言(如 Visual Basic、C、C++ 或 Java)还是通过仿真软件包,每条实体记录和事件通知都存放在计算机内存的某个物理位置。有两种基本可能:(a) 所有记录都存放在数组中。数组在计算机内存的连续位置中存放相继的记录,因此可以通过数组下标来引用它们,该下标可以理解为矩阵中的行号。(b) 所有实体和事件通知都用结构体(如 C 中)或类(如 Java 中)来表示,按需从内存中分配,并通过指向某条记录或结构体的指针来跟踪。
大多数仿真软件包使用动态分配的记录和指针来跟踪项目列表;由于数组在概念上更为简单,第 2.2 节先通过数组和数组下标解释链表的概念,第 2.3 节再将其应用于动态分配的记录和指针。
2.2 用数组进行列表处理
数组式的列表存储可以实现为一个记录数组;也就是说,每个数组元素是一条记录,它包含用于跟踪事件通知或列表中条目属性所需的字段。为方便起见,我们用记号 R(i) 来表示数组中的第 i 条记录,无论它实际存储在所用的哪种语言中。大多数现代仿真软件包不用数组存储列表,而是使用动态分配的记录——即在首次需要时创建、在不再需要时随之销毁的记录。
数组的优点在于,任何指定的记录(比如第 i 条)都能迅速取出,无须搜索,只需引用 R(i) 即可。数组的缺点在于,当项目被添加到列表中部或列表必须重新排列时,就会出现问题。此外,数组的大小通常是固定的,在编译期确定,或在程序首次开始执行时的初始分配中确定。在仿真中,任何一个列表的最大记录数都可能很难(或根本不可能)预测,而且列表中记录的当前数量在仿真运行过程中可能变化很大。更糟的是,大多数仿真需要不止一个列表;若把它们保存在各自独立的数组中,每个数组都得按该列表可能达到的最大规模来定维,这可能会占用过多的计算机内存。
在使用数组存储列表时,追踪列表中记录排名有两种基本方法。一种方法是把第一条记录存入 R(1),第二条存入 R(2),依此类推,最后一条存入 R(tailptr),其中 tailptr 用来引用列表中的最后一项。该方法概念简单、易于理解,但除极短的列表(不到五条左右的记录)之外,效率极低;例如,要在一个含 100 项的列表的第 41 个位置添加一项,就必须把最后 60 条记录在数组中物理下移一个位置,以腾出空间存放新记录。即便该列表是先入先出列表,从列表顶部移除首项也是低效的,因为其余所有项都必须在数组中物理上移一个位置。管理列表的物理重排方法在此不再进一步讨论。所需要的是一种能够追踪并重排列表中项目逻辑顺序的方法,而不必在计算机内存中物理移动记录。
在第二种方法中,一个称为头指针(名为 headptr)的变量指向列表顶部的记录。例如,若位置 R(11) 中的记录是列表顶部的记录,则 headptr 的取值为 11。此外,每条记录都有一个字段,存放列表中下一条记录的索引或指针。为方便起见,令 R(i, next) 表示下一个索引字段。
例 7:地磅队列中自卸卡车的列表
在例 5 的自卸卡车问题中,假设在表 6 的 CLOCK 时刻 10,地磅队列上恰好出现了三辆自卸卡车在等待,具体为依次排列的 DT3、DT2 和 DT4。再假设模型跟踪每辆自卸卡车的一个属性:它到达地磅队列的时间,该属性在每次到达时更新。最后,假设这些实体被存放在一个下标从 1 到 的数组中的记录里,每辆自卸卡车一条记录。每个实体由一条含 3 个字段的记录表示:第一个是实体标识符;第二个是到达地磅队列的时间;最后一个是指针字段,用于"指向"表示地磅队列的列表中的下一条记录(若有),如下:
[DTi, 到达地磅队列的时间, 下一索引]
在首次到达地磅队列之前、在被加入地磅队列列表之前,自卸卡车的第二、第三个字段是没有意义的。在时刻 0,各记录将初始化如下:
然后,在表 6 仿真的 CLOCK 时刻 10,地磅队列中的实体列表定义为:
要遍历该列表,先从头指针出发,转到该记录,取出该记录的后继指针,再继续下去,从而按逻辑顺序得到列表——例如:
R(4) 中后继指针的零值以及 tailptr 4,表明 DT4 位于列表的末端。
对本例中地磅队列这样的先入先出列表使用后继指针,使得随自卸卡车加入和离开地磅队列而添加和移除实体记录的操作变得特别简单。在 CLOCK 时刻 12,自卸卡车 DT3 开始称重,因而离开地磅队列。要把 DT3 实体记录从列表顶部移除,只需更新头指针,把它置为列表顶部记录的后继指针值:
在本例中,我们得到
这意味着 R(2) 中的自卸卡车 DT2 现在位于列表顶部。
类似地,在 CLOCK 时刻 20,自卸卡车 DT5 到达地磅队列并加入队尾。要把 DT5 实体记录添加到列表底部,需要采取以下步骤:
R(tailptr, next) 5(更新此前最后一项的后继指针字段)
tailptr 5(更新尾指针的值)
R(tailptr, next) 0(对新的尾部项,将其后继指针字段置零)
当列表是一个排名列表时,例如未来事件列表,或按实体属性排名的实体列表,上述做法会变得略为复杂。对于排名列表,要在与表头或表尾不同的任何位置添加或移除项目,通常都需要搜索。参见例 8。
注意,在自卸卡车问题中,装载机队列也可以用同样的六条记录、同一个数组来实现为列表,因为每个自卸卡车实体最多只会出现在这两个列表中的一个上,而在装载、称重或行驶期间,自卸卡车两个列表都不在。
2.3 使用动态分配与链表
在 C 和 Java 之类的过程式语言中,以及在大多数仿真语言中,实体记录在实体被创建时动态创建,事件通知记录则在未来事件列表上安排事件时动态创建。语言本身(或它们所运行的操作系统)维护着一条由空闲内存块组成的链表,并在收到请求时,向运行中的程序分配一块所需大小的内存块。(链表的又一个用途!)当一个实体"死亡"——即退出被仿真的系统——以及在一个事件发生、其事件通知不再需要之后,相应的记录被释放,从而使那块内存可供日后重用;语言或操作系统把该内存块加入空闲内存链表。
本书不关心分配和释放计算机内存的细节,因此我们假定所需的操作会按需要发生。采用动态分配时,记录通过指针而非数组下标来引用。当一条记录在 C 或 Java 中被分配时,分配例程返回一个指向所分配记录的指针,该指针必须存入某个变量或另一条记录的字段中,以备后用。指向记录的指针,可以理解为该记录在计算机内存中的物理地址或逻辑地址。
在我们的示例中,将采用与上一节(2.2 节)相同的记录记号:
实体:[ID, 属性, 后继指针]
事件通知:[事件类型, 事件时间, 其他数据, 后继指针]
但我们不再像前面那样用 R(i) 的数组记号来引用它们,因为那会造成误导。若出于某种原因我们想要列表上的第三项,就必须遍历列表、逐项计数,直到到达第三条记录。与数组不同,链表没有办法直接取出第 i 条记录,因为实际的记录可能存放在计算机内存中的任意位置,并不像数组那样连续存放。
例 8:未来事件列表与自卸卡车问题
从表 6 出发,例 5 自卸卡车问题中的事件通知被扩展为包含一个指向未来事件列表中下一条事件通知的指针,可表示为:
[事件类型, 事件时间, DTi, nextptr],
例如,
[EL, 10, DT3, nextptr]
其中 EL 是自卸卡车 DT3 在未来时刻 10 发生的结束装载事件,而字段 nextptr 指向 FEL 上的下一条记录。请记住,这些记录可能存放在计算机内存中的任意位置,特别是不一定连续存放。图 9 表示了取自表 6 的 CLOCK 时刻 10 的未来事件列表。每条记录的第四个字段都是指向未来事件列表中下一条记录的指针值。
C 和 Java 语言以及其他通用语言,在引用指针变量中的数据时使用不同的记号。为便于讨论,若 R 是指向某条记录的指针,则
分别是 R 所指向的那条事件通知的事件类型、事件时间和下一条记录。例如,若在 CLOCK 时刻 10 把 R 置为 FEL 的头指针,则
R next 是指向 FEL 上第二条事件通知的指针,
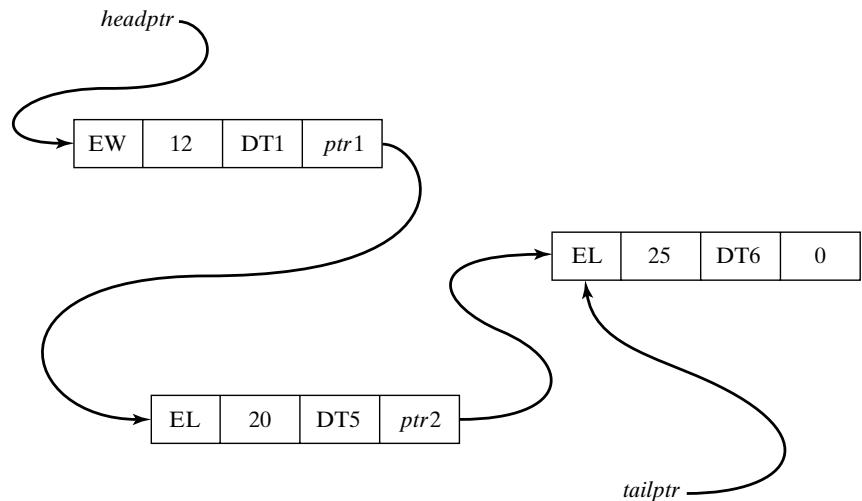
图 9 作为链表的自卸卡车未来事件列表。
因此
R next eventtype = EL
R next eventtime = 20
R next next 是指向 FEL 上第三条事件通知的指针
若某个指针字段为零(或 null),则该记录是列表中的最后一项,而指针变量 tailptr 指向这最后一条记录,如图 9 所示。
我们上面所描述的这些结构称为单链表(singly-linked list),因为从链表表头到表尾只有单向的链接。尾指针主要是为方便和效率而保留的,对于那些在列表底部添加项目的列表尤其如此。当然,尾指针并非严格必需,因为最后一项总可以通过遍历列表找到,但它确实使某些操作更加高效。
出于某些目的,除表头之外,还希望能够从表尾出发遍历或搜索列表。为此可以使用双向链表(doubly-linked list)。双向链表上的记录有两个指针字段,一个指向下一条记录,另一个指向前一条记录。讨论数组、单链表与双向链表以及列表的搜索与遍历的优秀参考书是 Cormen 等人 [2001] 和 Sedgewick [1998]。
2.4 高级技术
许多现代仿真软件包使用比在双向链表中搜索更高效的列表技术与表示方式。这些主题中大多数对本书而言过于高级。本节的目的只是简要介绍其中较为高级的思想。
加速双向链表处理的一种思路,是在头指针和尾指针之外再使用一个中间指针。采用特殊技术,中间指针将始终指向列表的近似中点。这样,当一条新记录被添加到列表时,算法先检查中间那条记录,以决定是从列表头部开始搜索还是从列表中部开始搜索。从理论上说,除了维护中间指针所带来的少量额外开销之外,这一技术应当能把搜索时间缩短一半。若干更高级的技术使用一个或多个中间指针,具体取决于列表的长度。
一些高级算法使用双向链表之外的列表表示方式,例如堆或树。这些主题超出了本书的范围。优秀的参考书是 Cormen 等人 [2001] 和 Sedgewick [1998]。
3 小结
本章介绍了仿真中的主要概念与基本构件,其中最重要的是实体与属性、事件以及活动。本章讨论了三种主要的世界观——事件调度、过程交互、活动扫描。最后,为理解最重要的底层方法学之一,第 2 节介绍了列表处理的一些基本概念。
参考文献
CORMEN, T. H., C. E. LEISEROON,AND R. L. RIVEST [2001], Introduction toAlgorithms, 2nd ed., McGraw-Hill, New York.
SCHRIBER, T. J., AND D. T. BRUNNER [2003], “Inside Simulation Software: How it Works and Why it Matters,” Proceedings of the 2003 Winter Simulation Conference, S. Chick, P. J. S´anchez, D. Ferrin, and D. J. Morrice, eds., New Orleans, LA, Dec. 7–10, pp. 113–123.
SEDGEWICK, R. [1998], Algorithms in C , 3d ed., Addison-Wesley, Reading, MA.
习题
给读者的说明:对于大多数习题,读者应先通过显式定义以下各项来构建模型:
系统状态;
系统实体及其属性;
集合,以及可能被放入这些集合的实体;
事件与活动;事件通知;
收集累积统计量所需的变量。
其次,读者要么(1)开发事件逻辑(正如例 3 的图 5 和图 6),以便使用事件调度方法,要么(2)开发系统过程(正如图 4),以便使用过程交互方法。
大多数问题都包含在区间 [a, b] 上均匀分布的活动。在进行手工仿真时,假定 是仅有的可能取值;也就是说,活动时间是离散随机变量。离散性假设将使手工仿真得到简化。
(a) 使用事件调度方法,继续例 3 表 1 中的(手工)收银台仿真。使用此前生成并使用的、来自《电子表格中的仿真示例》一章表 11(例 5 的仿真表)中的相同到达间隔时间与服务时间。(这指的是表 11 的 C 列和 E 列。)一直继续到所有到达的顾客都接受完服务为止。使用完最后一个到达间隔时间之后,假定不再有新的到达。
(b) 重新做一遍习题 1(a),并加入估计平均响应时间和在系统中停留 5 分钟或更久的顾客比例所需的模型构件。[提示:参见例 4,表 2。]
(c) 就手工仿真与计算机仿真各自的相对优点发表评论。
为例 5 的自卸卡车问题构建事件逻辑图。
在例 5 的自卸卡车问题中,希望估计平均响应时间以及大于 30 分钟的响应时间所占的比例。一辆卡车的响应时间始于该卡车到达装载机队列之时,止于该卡车完成称重之时。加入估计这两项系统性能度量所需的模型构件和累积统计量。仿真 8 小时。
按表 2 的形式制作一张表,直到 CLOCK 到达时刻 15,使用下面给出的到达间隔时间与服务时间,顺序如示。停止事件发生在时刻 30。
| 到达间隔时间: | 1 | 5 | 6 | 3 | 8 |
|---|---|---|---|---|---|
| 服务时间: | 3 | 5 | 4 | 1 | 5 |
继续表 2,直到呼叫者 C7 离开。
表 2 的数据改为如下:
| 到达间隔时间: | 4 | 5 | 2 | 8 | 3 | 7 |
|---|---|---|---|---|---|---|
| 服务时间: | 5 | 3 | 4 | 6 | 2 | 7 |
按表 2 的形式制作一张表,停止事件设在时刻 25。
用事件调度方法,通过手工仿真重做《电子表格中的仿真示例》一章的例 6(Able–Baker 呼叫中心问题)。
用事件调度方法,通过手工仿真重做《电子表格中的仿真示例》一章的例 8((M, N) 库存系统)。
用事件调度方法,通过手工仿真重做《电子表格中的仿真示例》一章的例 9(轴承更换问题)。
重做例 5,但使用下列数据:
| 装载时间: | 10 | 5 | 10 | 10 | 5 | 10 | 5 |
|---|---|---|---|---|---|---|---|
| 称重时间: | 12 | 16 | 12 | 12 | 16 | 12 | 12 |
| 行驶时间: | 40 | 60 | 40 | 80 | 100 | 40 |