4 仿真软件
本章首先讨论仿真软件的历史,并对其未来作一些推测。仿真软件的历史才刚刚进入中年期。本章所依据的历史,主要来自我们共同的经验、Richard Nance 教授所写的文章、历届冬季仿真会议(Winter Simulation Conference)上的专题小组讨论,以及本书合著者之一近期撰写的一篇文章。
接下来,我们讨论仿真软件的功能与属性。如果你正准备购买仿真软件,你会关心什么?是价格、易学性、易用性,还是对与你所关注的那类系统建模的能力?抑或是动画功能?在讨论完这些功能之后,我们再讨论与仿真软件选择有关的其他问题与顾虑。
用于开发仿真模型的软件可以分为三类。第一类是通用程序设计语言(general-purpose programming languages),例如 C、C++ 和 Java。第二类是仿真程序设计语言(simulation programming languages),例如 GPSS/H 和 SIMAN V®。第三类是仿真环境(simulation environments)。这一类包含许多产品,它们或以价格、或以应用领域、或以动画类型等各具特色,但具有一些共同的特征,例如图形用户界面,以及支持仿真研究全部(或大部分)方面的环境。许多仿真环境内含一种仿真程序设计语言,但也有一些采用类似于过程流程图(process-flow diagram)的图形化方法。
在第一类中,我们讨论用 Java 进行的仿真。Java 是一种通用程序设计语言,并非专为仿真用途而设计。之所以选择 Java,是因为它使用广泛且易于获得。今天,编写离散事件仿真模型的读者中,单独使用程序设计语言的人已经很少;不过在某些应用领域,也有人使用基于 Java 或其他通用语言构造的软件包。了解如何用通用语言开发模型,有助于理解基本概念与算法是如何实现的。
在第二类中,我们讨论 GPSS/H,这是一门高度结构化的过程交互(process-interaction)仿真语言。GPSS 最初是为较方便地仿真排队系统(如作业车间)而设计的,但后来也被用于仿真极为复杂的系统。它最初由 IBM 推出;如今 GPSS 有多种实现版本,其中 GPSS/H 是使用最为广泛的一种。
在第三类中,我们挑选若干仿真软件包进行讨论。目前可供选择的仿真软件包很多;我们选取了少数几个历经多年而依然存续并发展壮大的产品,用以代表建模的不同思路。
仿真环境的重要组成部分之一是输出分析器(output analyzer),它用于开展实验并辅助分析。为展示各项优良特性的范围,我们来看若干仿真环境中所包含的四类工具。这些统计分析工具通常用于计算汇总统计量(summary statistics)、置信区间(confidence intervals)以及其他统计度量。有些还支持预热期判定(warmup determination)、实验设计(design of experiments)和敏感性分析(sensitivity analyses)。如今许多软件包还提供基于遗传算法(genetic algorithms)、进化策略(evolutionary strategies)、禁忌搜索(tabu search)、分散搜索(scatter search)以及其他新近发展起来的启发式方法的优化技术。除了支持统计分析与优化之外,仿真环境还提供数据管理、方案定义(scenario definition)和运行管理(run management)。数据管理为分析与仿真相关的全部输入、输出数据的管理提供支持。
1 仿真软件的历史
我们对仿真软件历史的讨论依据 Nance [1995],他把 1955 年至 1986 年划分为五个时期。补充的历史信息取自 1992 年冬季仿真会议题为「Perspectives of the Founding Fathers」[Wilson et al., 1992] 的专题小组讨论,其中八位早期仿真用户介绍了各自的历史视角。我们补充上第六个、也是最近的一个时期,然后对未来作一些推测:
- 1955–1960 探索时期(The Period of Search)
- 1961–1965 萌芽时期(The Advent)
- 1966–1970 成形时期(The Formative Period)
- 1971–1978 扩展时期(The Expansion Period)
- 1979–1986 巩固与再生时期(The Period of Consolidation and Regeneration)
- 1987–2008 集成环境时期(The Period of Integrated Environments)
- 2009–2011 未来(The Future)
下面各小节简要介绍这段历史。如 Nance [1995] 所指出的,截至 1981 年已有报告的仿真程序设计语言至少有 137 种,此后又有更多。本书这段简要历史远非完整。我们提到的这些语言与软件包,或经受住了时间考验而延续至今,或曾是现今仍在使用的某个软件包的历史前身。
1.1 探索时期(1955–1960)
在早期年代,仿真是在 FORTRAN 或其他通用程序设计语言中进行的,没有仿真专用例程(routines)的支持。在第一个时期,人们投入了大量精力去探索统一的概念,并开发可复用的例程以便利仿真。K.D. Tocher 与 D.G. Owen [1960] 的通用仿真程序(General Simulation Program)被认为是第一次「语言方面的努力」。Tocher 识别并开发出可以在后续仿真项目中重复使用的例程。
1.2 萌芽时期(1961–1965)
今天仍在使用的仿真程序设计语言(simulation programming languages, SPLs)的前身,出现于 1961–1965 年。正如 Harold Hixson 在 Wilson et al. [1992] 中所说,「一开始只有 FORTRAN、ALGOL 和 GPSS」——也就是说,当时有基于 FORTRAN 的软件包(如 SIMSCRIPT 与 GASP)、ALGOL 的衍生语言 SIMULA,以及 GPSS。
第一个过程交互式 SPL——GPSS——由 IBM 的 Geoffrey Gordon 开发,约于 1961 年问世。Gordon 开发 GPSS(General Purpose Simulation System)是为了快速仿真通信系统与计算机系统,但其易用性很快使它流行开来,并蔓延到其他应用领域。GPSS 基于方块图表示(block-diagram representation,类似过程流程图),适用于各种类型的排队模型。如 Reitman 在 Wilson et al. [1992] 中所报道,早在 1965 年,GPSS 就已与一台可中断运行并显示中间结果的交互显示终端相连接——这预示了当今的交互式仿真,但在当时价格过于昂贵,未能广泛普及。
Harry Markowitz(后来因其组合理论(portfolio theory)方面的工作而获得诺贝尔奖)为 SIMSCRIPT 提供了主要的概念指导,该语言最初出现于 1963 年。RAND Corporation 在美国空军的资助下开发了这种语言。SIMSCRIPT 最初深受 FORTRAN 影响,但在后来的版本中,其开发者摆脱了 FORTRAN 的基础,创立了自己的 SPL。最初的几个版本是基于事件调度的。
United States Steel Corporation 应用研究实验室(Applied Research Laboratory)的 Phillip J. Kiviat 于 1961 年开始开发 GASP(General Activity Simulation Program)。它最初基于通用程序设计语言 ALGOL,但后来决定改以 FORTRAN 为基础。GASP 与 GPSS 一样,采用工程师所熟悉的流程图符号。它并非一门真正意义上的语言,而是一组 FORTRAN 例程的集合,用于在 FORTRAN 中便利地开展仿真。
在这一时期还开发了许多其他 SPL。其中值得注意的有:在挪威开发、在欧洲广泛使用的 ALGOL 扩展语言 SIMULA,以及采用活动扫描(activity-scanning)方法的控制与仿真语言(Control and Simulation Language, CSL)。
1.3 成形时期(1966–1970)
在这一时期,人们对各种概念进行审视与提炼,以促成各语言「世界观」更加一致的表达。主要的 SPL 日趋成熟并得到更广泛的使用。
硬件的迅速进步与用户的需求,迫使一些语言(尤其是 GPSS)经历重大修订。GPSS/360 连同对早期 GPSS 版本的扩展,面向 IBM 360 计算机问世。它的流行促使至少六家其他硬件厂商以及其他团体开发出各自的 GPSS 实现或类似产品。
SIMSCRIPT II 代表了 SPL 的一次重大进步。在其自由格式的类英语语言和「宽容」的编译器中,人们试图在语言设计上给予用户充分的考虑。
CSL 的衍生语言 ECSL 得到开发,并在英国广受欢迎。在欧洲,SIMULA 加入了类与继承的概念,从而成为现代面向对象程序设计语言的先驱。
1.4 扩展时期(1971–1978)
这一时期 GPSS 的主要进展来自 IBM 之外。Norden Systems 的 Julian Reitman 主持了 GPSS/NORDEN 的开发,这是一项开创性的工作,提供了交互式、可视化的在线环境。Wolverine Software 的 James O. Henriksen 开发了 GPSS/H,1977 年首先在 IBM 大型机上发布,随后登陆小型计算机与 PC。它以采用编译方式、据称比标准 GPSS 快 5 至 30 倍而著称。随着交互式调试器等新特性的加入,它已成为当今使用最广的 GPSS 版本。
Purdue 大学的 Alan Pritsker 对 GASP 作了重大改动,GASP IV 于 1974 年问世。它在时间事件之外还引入了状态事件(state events),因而在事件调度世界观之外,又增加了对活动扫描世界观的支持。
这一时期人们曾努力简化建模过程。利用 SIMULA,人们尝试从高层用户视角出发开发一种系统定义,并可自动翻译为可执行模型。类似的工作还包括交互式程序生成器、「按问卷编程」(Programming by Questionnaire)、自然语言接口,以及向所选语言的自动映射。正如早期对自动程序设计的过分乐观的信念一样,这些努力在「可建模内容之普遍性」上遭遇了严重的限制——也就是说,它们碰到了真实世界系统不可避免的复杂性。尽管如此,简化仿真建模的努力仍在继续,其中最为成功的见于面向狭窄领域应用而设计的仿真系统。
1.5 巩固与再生时期(1979–1986)
第五个时期见证了为桌面计算机和微型计算机编写、或加以改造的 SPL 的开端。在这一时期,主要的 SPL 在保持其基本结构的同时,把其实现扩展到了许多计算机和微处理器上。
GASP 衍生出两个重要后继:SLAM II 与 SIMAN。由 Pritsker and Associates, Inc. 推出的替代建模仿真语言(Simulation Language for Alternative Modeling, SLAM)力求提供多种建模视角与组合建模能力 [Pritsker and Pegden, 1979]——也就是说,它既有一个基于 GASP 的事件调度视角,有一个网络世界观(过程交互视角的一个变种),还有一个连续部分。借助 SLAM,你可以选择某一种世界观,或把三者混合使用。
SIMAN(SIMulation ANalysis)拥有 GASP IV 等 SPL 所具备的一般建模能力,同时还具有在某些方面类似 SLAM 和 GPSS 的方块图部分。C. Dennis Pegden 用大约两年时间、作为个人的教师科研项目开发了 SIMAN;他后来创办了 Systems Modeling Corporation 来推广 SIMAN。SIMAN 是第一种可以在 IBM PC 上运行、并按 MS-DOS 的约束条件设计的主要仿真语言。与 GASP 类似,SIMAN 允许采用事件调度方法(通过用 FORTRAN 编程并配以一组给定的 FORTRAN 例程)、方块图方法(过程交互世界观的另一个变种,在某些方面与 GPSS 和 SLAM 类似),以及一个连续部分。
1.6 集成环境时期(1987–2008)
这一时期的特点是 SPL 在个人计算机上的成长,以及带有图形用户界面、动画和其他可视化工具的仿真环境的出现。AutoMod 与 Extend 是最早提供集成式仿真环境的两个软件包之一。今天,几乎所有仿真软件包都带有把建模、模型调试、动画与模型的交互式运行整合在一起的环境。这些环境中有很多还包含输入数据分析器与输出分析器。有些软件包试图借助过程流程图或方块图,以及「填空式」(fill-in-the-blank)窗口来简化建模过程,从而免去学习程序设计语法的必要。动画的表现形式从示意图式的表示一直延伸到二维与三维的比例图。
基于网络的仿真方面近来已有进展。仿真已被认为在供应链管理中能够发挥作用。仿真与模拟(emulation)的结合显示出前景。(模拟是指对某种装置的模仿,例如 www.demo3d.com 中所示的那些物料搬运设备。)
1.7 未来(2009–2011)
在 ICS Newsletter 的一篇文章 [Banks, 2008] 中,本书的一位合著者向一个仿真专家小组(其中包括业内知名的权威人士)询问了他们对离散事件仿真未来发展的意见或最佳猜测。第一个问题是:「在不久的将来——比如说三年之内——我们将在仿真软件中看到哪些非凡的成果?」
被提及最多的未来发展方向(包括更多地使用虚拟现实)有:改进的用户界面、更好的动画,以及一次范式转移,例如在离散事件建模中大规模采用基于智能体的建模(agent-based modeling)。尽管迄今为止,基于智能体的建模已被广泛用于对群体行为(社会动乱、战争,甚至判定是哪些要素引发了起立鼓掌)和社会现象(季节性迁徙、污染、疾病传播、有性繁殖等)建模,但它在工业与商业仿真中的应用才刚刚开始。
基于智能体的建模是一种方法,用于仿真网络中自主个体(即智能体)的行为与交互,目的是评估它们对整个系统的影响。智能体可以是人、动物或其他具有能动性(agency)的实体;所谓能动性,是指它们并非被动的,而是主动作出决策、保留对以往情形与决策的记忆,并表现出学习能力。概括地说,智能体是主动的,并可能表现出认知、记忆与学习。它们可以有目标,也可以没有目标。
每个智能体的行为由一组局部规则支配;也就是说,智能体会以规定的方式对局部的、近旁条件作出反应。人们关注的是由智能体群体涌现出来的行为模式,称为涌现行为(emergent behavior)。
一个有趣且广为人知的例子是「群鸟」(boids,即在给定二维或三维区域内飞行的模拟鸟群),其中群集行为会涌现出来。(在互联网上可以找到许多群鸟模型的例子,它们各自基于相似但并不完全相同的假设或规则。可参见 www.navgen.com/3d boids。)群集行为既非脚本编排,也非显式编程,而是从一组相当简单的规则中自然涌现(而且颇为出人意料)。基本规则是:若一只群鸟靠近了一只或多只其他群鸟,它就会调整自己的方向与速度以与那些群鸟保持一致。在互联网上找到的大多数群鸟仿真中,群鸟并非目标导向的;也就是说,它们没有目的地,只是飞行而已。至少有一个群鸟仿真例子中,群鸟确实有目标:那里有两群或更多群鸟,其中一群的成员会攻击并杀死其他群的成员。
用于基于智能体的建模的软件包与工具包包括:
- AnyLogic(www.xjtek.com),见 7.1 节;
- Ascape(www.nutechsolutions.com);
- MASON(cs.gmu.edu/%7Eeclab/projects/mason);
- NetLogo(ccl.northwestern.edu/netlogo);
- StarLogo(education.mit.edu/starlogo);
- Swarm(www.swarm.org);
- RePast(www.repast.sourceforge.net),
仅举此数种。
关于各类软件包的信息见第 7 节,其中也给出了各厂商的网址。从这些网址可以得到当前仿真软件发展动态的一个视图。
2 仿真软件的选择
本章简要介绍了若干仿真软件包。每两年,期刊 OR/MS Today 会刊登一份仿真软件调查 [Swain, 2007]。2007 年那一期共收录 48 种产品,其中包括输入数据分析器之类的仿真支持包。
选择仿真软件时有许多值得关注的功能 [Banks, 1996]。表 1 至表 5 给出了其中一些功能及其简要说明。在评估和选择仿真软件时,我们提出如下建议:
- 不要只关注单一问题,例如易用性。应当考虑可达到的精度与细节水平、易学性、厂商支持,以及对你的应用是否适用。
- 执行速度很重要。不要只从「夜间和周末进行实验运行」的角度来思考问题。速度会影响开发时间。在调试过程中,分析师可能不得不反复等待模型运行到仿真时间中出错的那一点,才能发现错误。
- 对广告宣传与演示要保持警惕。许多广告只利用软件的正面特性。同样,演示程序把测试问题解决得很好,但未必是你自己的问题。
- 请厂商解决你的问题的一个小型版本。
表 1 模型构建特性(Model-Building Features)
| 特性 | 说明 |
|---|---|
| 建模世界观 | 依需要选择过程交互、事件视角与连续建模 |
| 输入数据分析能力 | 从原始数据估计经验分布或统计分布 |
| 图形化建模 | 过程流程、方块图或网络方法 |
| 条件路由 | 依据规定的条件或属性为实体选择路径 |
| 仿真程序设计 | 通过高级而强大的仿真语言添加过程逻辑的能力 |
| 语法 | 易于理解、一致、无歧义、类英语 |
| 输入灵活性 | 接受来自外部文件、数据库、电子表格的数据,或以交互方式输入数据 |
| 建模简洁性 | 功能强大的动作、模块或节点 |
| 随机性 | 常用各分布的随机变量生成器,例如指数分布、三角分布、均匀分布、正态分布 |
| 专用构件与模板 | 物料搬运:车辆、输送带、桥式起重机、AS/RS 等;液体与散装物料的处理;通信系统;计算机系统;呼叫中心;其他 |
| 用户自定义对象 | 可复用的对象、模板与子模型 |
| 连续流 | 储罐与管道,或散料输送带 |
| 与通用程序设计语言的接口 | 链接以 C、C++、Java 或其他通用程序设计语言编写的代码 |
表 2 运行环境(Runtime Environment)
| 特性 | 说明 |
|---|---|
| 执行速度 | 方案与重复实验都需要大量运行。既影响开发,也影响实验 |
| 模型规模;变量与属性数量 | 不应有任何内建限制 |
| 交互式调试器 | 在仿真推进过程中细致地监视仿真。能够中断、捕获、运行至指定点、单步执行;显示状态、属性与变量等 |
| 模型状态与统计量 | 在仿真过程中的任何时刻显示 |
| 运行许可证 | 能够修改参数并运行模型(但不能修改逻辑或构建新模型) |
- 对那些只有「是」和「否」两种条目的「检查表」要保持警惕。例如,许多软件包都声称具有输送带实体。然而,各家实现的差异相当大,保真度也参差不齐。真正重要的是实现与能力。再举一个例子,大多数软件包都提供运行许可证,但它们在价格与功能上差异很大。
表 3 动画与布局特性(Animation and Layout Features)
| 特性 | 说明 |
|---|---|
| 动画类型 | 忠于比例或图标式(如过程流程图) |
| 导入图形与对象文件 | 来自 CAD(矢量格式)图形,或图标(位图或光栅图形) |
| 维数 | 二维、带透视的二维、三维 |
| 运动 | 实体或状态指示器的移动 |
| 运动质量 | 平滑或跳跃 |
| 常用对象库 | 大量预先绘制的图形 |
| 导航 | 平移、缩放、旋转 |
| 视图 | 用户定义并命名 |
| 显示步长 | 对动画速度的控制 |
| 可选择对象 | 选中后显示动态状态与统计量 |
| 硬件要求 | 标准显卡或专用显卡 |
表 4 输出特性(Output Features)
| 特性 | 说明 |
|---|---|
| 方案管理器 | 创建用户自定义的待仿真方案 |
| 运行管理器 | 执行所有运行(方案与重复实验)并保存结果以供日后分析 |
| 预热能力 | 用于稳态分析 |
| 独立重复实验 | 使用不同的随机数集合 |
| 优化 | 遗传算法、禁忌搜索等 |
| 标准化报告 | 含平均值、计数、最小值与最大值等的汇总报告 |
| 定制报告 | 面向管理人员的量身定制的展示 |
| 统计分析 | 置信区间、实验设计等 |
| 商务图表 | 条形图、饼图、时间线等 |
| 成本模块 | 内含基于活动的成本核算 |
| 文件导出 | 输出至电子表格或数据库,以便定制处理与分析 |
| 数据库维护 | 以有组织的方式存储输出 |
表 5 厂商支持与产品文档(Vendor Support and Product Documentation)
| 特性 | 说明 |
|---|---|
| 培训 | 定期开设的高质量课程 |
| 文档 | 质量、完整性、在线可查 |
| 帮助系统 | 通用帮助或上下文相关帮助 |
| 教程 | 用于学习软件包或特定功能 |
| 支持 | 电话、电子邮件、Web |
| 升级与维护 | 新版本与维护版本的发布规律,且能回应客户需求 |
| 历史记录 | 稳定性、历史、与客户的关系 |
仿真用户常问:仿真模型能否链接并使用以外部语言(如 C、C++ 或 Java)编写的代码或例程?这是一项很好的特性,尤其当这些外部例程已经存在且适合当前用途时。但更重要的问题是:仿真软件包及其语言是否足够强大,从而使人无须在任何外部语言中编写逻辑。
图形化建模环境与基于仿真语言的软件包之间可能存在重大的取舍。图形化建模消除了因语言语法而产生的学习曲线,但它并未消除在大多数真实世界模型中对过程逻辑的需要,也并未消除为了把它写对而进行的调试。除非该软件包与你的问题领域几乎完全契合,或者可以用所给的模块、节点或过程流程图完成程序设计(即定制化的过程逻辑)——只有在这种情况下,「无需程序设计」的说法才成立;而此时「无需程序设计」指的仅仅是语法,而非过程逻辑的开发。
3 一个仿真实例
例 1:收银台——一个典型的单服务台队列
该系统是一个杂货店收银台,被建模为单服务台队列。仿真将一直运行到 1000 位顾客得到服务为止。此外,假定顾客的到达间隔时间服从均值为 4.5 分钟的指数分布,服务时间(近似地)服从均值为 3.2 分钟、标准差为 0.6 分钟的正态分布。(这个近似之处在于服务时间总是为正。)当收银员忙碌时,就形成排队,且没有顾客被劝离。本例曾采用事件调度(event-scheduling)的观点手工仿真过。模型包含两个事件:到达事件与离开事件。
接下来的三节分别用 Java、GPSS/H 和 SSF(Scalable Simulation Framework,可扩展仿真框架)说明这个单服务台队列的仿真。虽然本例要比研究复杂系统时出现的模型简单得多,但其仿真包含了所有离散事件仿真的基本组成部分。
4 用 Java 进行仿真
Java 是一种广泛可得、并在仿真中得到广泛使用的程序设计语言。然而它并未提供任何直接面向仿真分析师的设施,因此分析师必须自行编程实现事件调度/时间推进算法的全部细节、统计量收集功能、从指定概率分布中生成样本的功能,以及报告生成器。尽管如此,其运行时类库确实提供了一个随机数发生器(random-number generator)。与 FORTRAN 或 C 不同,Java 的面向对象特性确实支持大型模型的模块化构造。就大部分情况而言,专用仿真语言会隐藏事件调度的细节,而在 Java 中所有细节都必须显式地编程实现。不过在一定程度上,诸如 SSF [Cowie, 1999] 这样的仿真类库确实减轻了开发负担:它们提供了对标准化仿真功能的访问,并隐藏了底层调度的琐碎细节。
学习 Java 有许多在线资源;我们假定读者已具备该语言的工作知识。任何用 Java 编写的离散事件仿真模型都包含第 3 节讨论过的组成部分:系统状态、实体与属性、集合、事件、活动与延迟,以及下面列出的组成部分。为便于开发和调试,最好用方法来把 Java 模型组织成模块化的形式。以下组成部分几乎在所有用 Java 编写的模型中都会出现:
时钟(Clock):定义仿真时间的变量。
初始化方法(Initialization method):定义时刻 0 系统状态的方法。
最小时刻事件方法(Min-time event method):识别即时事件(imminent event)的方法,即未来事件列表(FutureEventList)中时间戳最小的元素。
事件方法(Event methods):对每一种事件类型,配备一个在该事件发生时更新系统状态(以及累积统计量)的方法。
随机变量生成器(Random-variate generators):用于从所需概率分布中生成样本的方法。
主程序(Main program):用于维持对事件调度算法的总体控制。
报告生成器(Report generator):根据累积统计量计算汇总统计量,并在仿真结束时打印报告的方法。
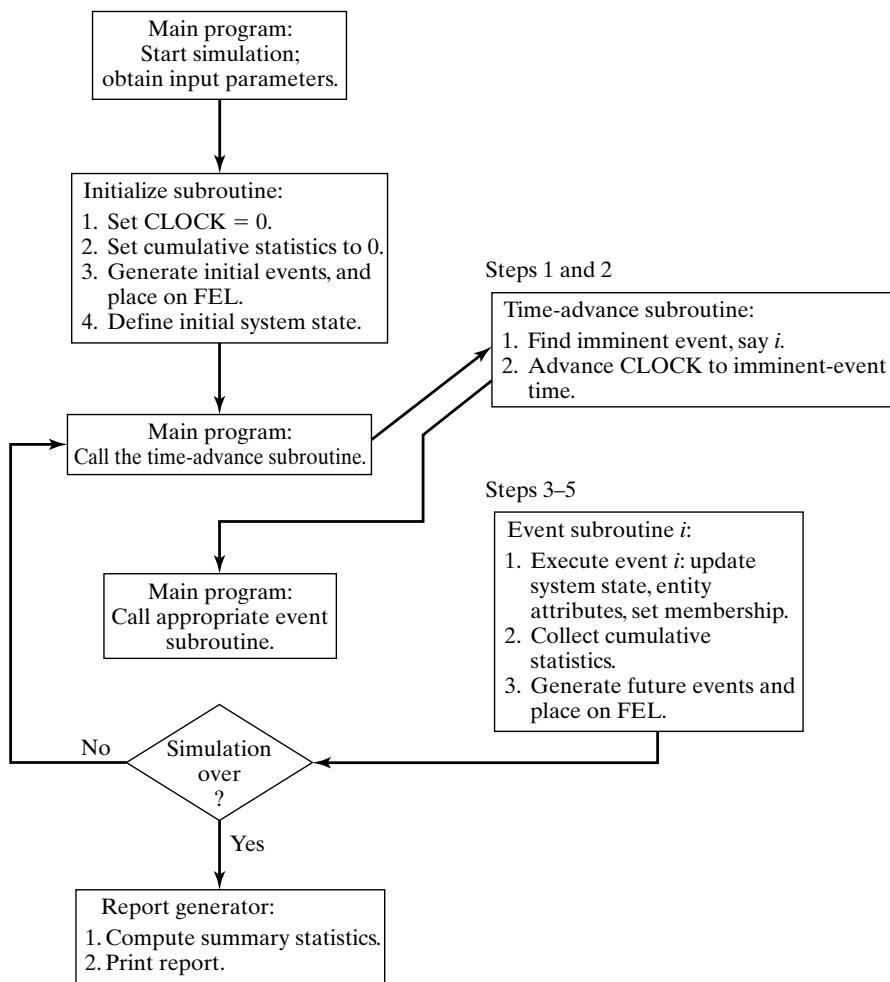
图 1 事件调度仿真程序的总体结构。
Java 仿真程序的总体结构如图 1 所示。
仿真开始时,把仿真时钟置零,把累积统计量初始化为零,生成所有初始事件(总会至少有一个),把它们放入 FutureEventList,并定义时刻 0 的系统状态。随后仿真程序进入循环,反复把当前时间最早的事件传递给相应的事件方法,直到仿真结束。在每一步中,找到即时事件之后、调用事件方法之前,仿真时钟被推进到即时事件发生的时刻。(回顾一下:在两个相继事件发生之间的仿真时间内,系统状态与实体属性的取值并不改变。事实上,这正是离散事件仿真的定义:系统状态仅在事件发生时才改变。)接着,调用相应的事件方法来执行即时事件、更新累积统计量并生成未来事件(放入 FutureEventList)。执行即时事件意味着改变系统状态、实体属性和集合的成员关系,以反映该事件已经发生这一事实。注意,事件方法中的所有动作都发生在仿真的同一瞬间。变量 Clock 的取值在事件方法中并不改变。若仿真尚未结束,控制权再次转回时间推进方法,再转到相应的事件方法,如此继续。当仿真结束时,控制权转给报告生成器,由它根据收集到的累积统计量计算所需的汇总统计量并打印报告。
一个仿真模型在计算机运行时间上的效率,在很大程度上取决于操作 FutureEventList 及其他集合所采用的技术。如第 3 节早先所述,对 FutureEventList 执行的主要操作是从中移除即时事件与添加新事件。Java 提供了通用的、高效的搜索与优先列表数据结构;通常的做法是为这些结构构建定制的接口以适应具体应用。在下面这个例子中,我们用定制的接口来实现事件列表与等待顾客列表。其底层的优先队列组织是高效的,因为其访问代价仅随列表中元素个数的对数而增长。
例 2:用 Java 仿真单服务台队列
例 1 中详细定义的杂货店收银台,现用 Java 进行仿真。
类 Event 表示一个事件。它保存事件类型(到达或离开)的代码以及事件时间戳。它带有若干相关方法(函数),用于创建事件和访问其数据。它还带有一个相关方法 compareTo,把该事件与另一个(作为参数传入的)事件进行比较,并报告前者应被视为比参数事件小、相等还是大。本模型的方法与控制流程如图 2 所示,该图是图 1 针对本问题的改编。表 6 列出了用于系统状态、实体属性与集合、活动持续时间、累积统计量与汇总统计量的变量;用于从指数分布与正态分布中生成样本的函数;以及所需的全部其他方法。
表 6 单服务台队列 Java 模型中变量、函数与方法的定义
| 变量 | 说明 |
|---|---|
| 系统状态 | |
| QueueLength | 当前仿真时刻处于排队中(但未接受服务)的顾客数 |
| NumberInService | 当前仿真时刻正在接受服务的顾客数 |
| 实体属性与集合 | |
| Customers | 系统中顾客的 FCFS 队列 |
| 未来事件列表 | |
| FutureEventList | 按优先级排序的待处理事件列表 |
| 活动持续时间 | |
| MeanInterArrivalTime | 前一位顾客到达与下一次到达之间的到达间隔时间 |
| MeanServiceTime | 最近一位开始接受服务的顾客的服务时间 |
| 输入参数 | |
| MeanInterarrivalTime | 平均到达间隔时间(4.5 分钟) |
| MeanServiceTime | 平均服务时间(3.2 分钟) |
| SIGMA | 服务时间的标准差(0.6 分钟) |
| TotalCustomers | 停止准则——要服务的顾客数(1000) |
| 仿真变量 | |
| Clock | 仿真时间的当前值 |
| 统计量累加器 | |
| LastEventTime | 最后一个事件的发生时刻 |
| TotalBusy | 服务台(迄今)的总忙碌时间 |
| MaxQueueLength | 排队线(迄今)的最大长度 |
| SumResponseTime | 所有已离开顾客(迄今)的顾客响应时间之和 |
| NumberOfDepartures | 离开次数(迄今) |
| LongService | 在收银台停留 4 分钟及以上的顾客数(迄今) |
| 汇总统计量 | |
| RHO =BusyTime/Clock | 服务台忙碌的时间比例(此处 Clock 的值为仿真时间的最终值) |
| AVGR | 平均响应时间(等于 SumResponseTime/TotalCustomers) |
| PC4 | 在收银台停留 4 分钟及以上的顾客所占比例 |
| 函数 | 说明 |
| exponential(mu) | 用于从均值为 mu 的指数分布中生成样本的函数 |
| normal(xmu, SIGMA) | 用于从均值为 xmu、标准差为 SIGMA 的正态分布中生成样本的函数 |
| 方法 | 说明 |
| Initialization | 初始化方法 |
| ProcessArrival | 执行到达事件的事件方法 |
| ProcessDeparture | 执行离开事件的事件方法 |
| ReportGeneration | 报告生成器 |
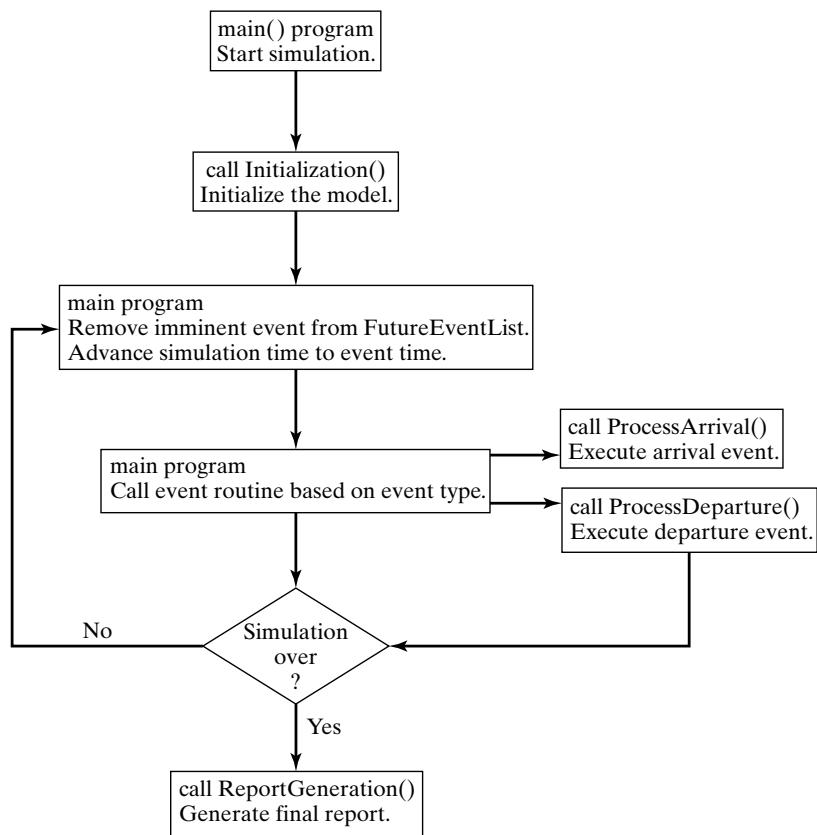
图 2 单服务台队列 Java 仿真的总体结构。
图 3 单服务台队列仿真的 Java 主程序。
程序的入口以及控制逻辑所在之处是类 Sim,如图 3 所示。类 EventList 与 Queue 的变量被声明为外部类;由于这些类对 Sim 之外的程序同样有用,按照 Java 规则,它们的声明置于其他文件中。同时还声明了 Java 内建类 Random 的一个变量;该类的实例提供随机数流。主方法控制着事件调度/时间推进算法的总体流程。
图 4 单服务台队列仿真的 Java 初始化方法。
主程序方法首先给描述模型参数的变量赋值;它创建随机数发生器、事件列表和顾客队列的实例;然后调用方法 Initialization 来初始化其他变量,例如收集统计量的变量。随后控制进入一个循环,只有在 TotalCustomers 位顾客都接受了服务之后才退出该循环。循环内部,通过调用优先队列的 getMin 方法得到即时事件的一份副本,再通过调用 dequeue 把该事件从事件列表中移除。全局仿真时间 Clock 被设为即时事件中所含的时间戳,然后根据事件类型调用 ProcessArrival 或 ProcessDeparture。仿真最终结束时,调用方法 ReportGeneration 来生成并打印最终报告。
类 Sim 方法 Initialization 的清单见图 4。仿真时钟、系统状态和其他变量在此被初始化。注意,第一个到达事件是通过生成一个局部 Event 变量而创建的,其构造函数接受事件类型与时间。事件时间戳由调用类 Sim 方法 exponential 随机生成,该方法把随机数流与指数分布的均值一起使用以进行抽样。事件通过调用方法 enqueue 插入未来事件列表。这一逻辑假定在仿真时刻 Clock 为 0 时系统是空的,因此没有离开事件需要被调度。若要适应其他初始条件,只需按需向 FutureEventList 与 Customers 中添加事件,代码的修改十分直接。
图 5 给出了类 Sim 方法 ProcessArrival 的清单,该方法用于处理每一个到达事件。单服务台队列到达事件的基本逻辑如下(其中 LQ 对应 QueueLength,LS 对应 NumberInService)。首先,把新到达者加入系统中顾客的队列 Customers。接着,若服务台空闲(NumberInService 为 0),则新顾客立即进入服务,因此调用类 Sim 方法 ScheduleDeparture 来完成这一调度。到达空闲队列不会更新累积统计量,但最大队列长度可能除外。到达忙碌队列不会导致离开事件的调度,但会使总忙碌时间增加「当前事件与紧邻其前一个事件之间」的仿真时间长度(因为若服务台此刻忙碌,那么在处理前一个事件结束之前,服务台必定至少已有一位顾客在接受服务)。无论哪种情况,新到达者都负责为未来某个随机的到达间隔时间之后的下一次到达进行调度。到达事件的仿真时间取当前 Clock 值加上一个指数增量生成,该事件被插入未来事件列表,记录已处理事件时刻的变量 LastEventTime 被设为当前时刻,控制权返回类 Sim 的主方法。
图 5 单服务台队列仿真的 Java 到达事件方法。
执行离开事件的类 Sim 方法 ProcessDeparture 列于图 6 中,方法 ScheduleDeparture 也一并列出。把事件从全体顾客的队列中移除之后,要检查正在接受服务的人数。若有顾客在等待,则为下一位进入服务的顾客调度其离开事件。随后更新记录所有响应时间之和、忙碌时间之和、使用服务时间超过 4 分钟的顾客数以及离开次数的累积统计量。(注意,发生离开事件时最大队列长度的取值不可能改变。)注意,顾客是按 FIFO 顺序从 Customers 中移除的;因此,离队顾客的响应时间可以用当前仿真时间减去离开服务的作业的到达时间(该到达时间由从 Customers 队列中移除的到达事件副本获得)来计算。在离开总数递增并保存本事件时刻之后,控制权返回主程序。
图 6 还给出了方法 ScheduleDeparture 的逻辑,该方法由 ProcessArrival 和 ProcessDeparture 共同调用,用以让下一位顾客进入服务。类 Sim 方法 normal 用于生成服从正态分布的服务时间,它被反复调用直到产生一个非负样本为止。一个类型为 departure 的新事件被创建,其事件时间等于当前仿真时间加上刚刚抽样得到的服务时间。该事件被压入 FutureEventList,
图 6 单服务台队列仿真的 Java 离开事件方法。
正在服务的人数被置为 1,等待人数(QueueLength)减 1,以反映进入服务的顾客不再处于等待状态这一事实。
报告生成器,即类 Sim 方法 ReportGeneration,列于图 7。汇总统计量 RHO、AVGR 和 PC4 由表 6 中的公式计算得出;随后先打印输入参数,再打印汇总统计量。在仿真结束时打印输入参数是个好主意,这样可以核实这些参数的取值是否正确,以及是否在无意中被改动过。
图 8 给出了用于生成随机变量的类 Sim 方法 exponential 与 normal 的清单。这两个函数都调用方法 nextDouble,该方法为 Java 内建类 Random 所定义,生成一个在 (0,1) 区间上均匀分布的随机数。这里使用 Random 仅为简化讲解;更优的随机数发生器是可以自行构造的。生成指数分布与正态分布随机变量的技术,都是以先生成一个 U(0,1) 随机数为基础的。
杂货店收银台仿真的输出如图 9 所示。必须强调,输出统计量是包含随机误差的估计值。所显示的数值受以下因素影响:恰好被用到的那组特定随机数、时刻 0 的初始条件,以及运行长度(此处为 1000 次离开)。
图 7 单服务台队列仿真的 Java 报告生成器。
在某些仿真中,希望在经过一段固定长度的时间后停止仿真,比如 TE 为 12 小时即 720 分钟。在这种情况下,要定义一种额外的事件类型——停止事件(stop event),并通过在仿真初始化时调度一个停止事件来安排它发生。当停止事件真的发生时,累积统计量将被更新,并调用报告生成器。主程序和方法 Initialization 只需做少量修改。习题 1 要求读者完成这些修改。习题 2 考虑再加一项修改:在仿真时刻 Clock 等于 TE 时仍在收银台的顾客应当获准离店,但 TE 之后不再允许新的到达。
图 8 单服务台队列仿真的随机变量生成器。
图 9 Java 单服务台队列仿真的输出。
5 用 GPSS 进行仿真
GPSS 是一门高度结构化的、专用的仿真程序设计语言,它基于过程交互方法,面向排队系统。方块图提供了一条方便的途径来描述被仿真的系统。GPSS 中有 40 多个标准模块。称为事务(transactions)的实体,可以看作在方块图中流动。模块代表影响事务流动的事件、延迟以及其他动作。因此,GPSS 可以用来建模任何这样的情形:事务(实体、顾客、交通流量单位)流经一个系统(例如,一个排队网络,其中各队列位于稀缺资源之前)。方块图被转换为模块语句,再加入控制语句,其结果就是一个 GPSS 模型。
GPSS 的第一个版本由 IBM 于 1961 年发布。它是第一个过程交互式仿真语言,并广受欢迎;自 1961 年以来,许多方面对它重新实现并加以改进,其中 GPSS/H 是今天使用最广的版本。例 3 基于 GPSS/H。
GPSS/H 是 Wolverine Software Corporation 的产品,网址为 www.wolverinesoftware.com [Banks, Carson, and Sy, 1995; Henriksen, 1999]。它是一件灵活而强大的仿真工具。与最初的 IBM 实现不同,GPSS/H 内含文件与屏幕 I/O,允许把算术表达式用作模块操作数,并提供交互式调试器、更快的执行速度、扩展的控制语句、普通变量与数组、浮点时钟、内建数学函数以及内建随机变量生成器。
GPSS/H 的动画工具是 ProofAnimation™,它是 Wolverine Software Corporation 的另一款产品 [Henriksen, 1999]。ProofAnimation 提供二维或三维动画,通常基于比例图。它可以以后处理模式(仿真运行结束之后)运行,也可以与仿真并行运行。在后处理模式下,动画由两个文件驱动:提供静态背景的布局文件,以及包含使对象移动并产生其他动态事件之命令的跟踪文件。它可以与任何能够写出 ASCII 跟踪文件的仿真软件包配合使用。或者,它也可以通过把跟踪文件命令作为消息发送而与仿真并行运行,还可以直接使用它的 DLL(动态链接库)版本来控制。
例 3:用 GPSS/H 仿真单服务台队列
图 10 给出方块图,图 11 给出例 2 中所描述的杂货店收银台模型的 GPSS 程序。注意,程序(图 11)是方块图的翻译,并附加了定义语句与控制语句。(在下面的讨论中,所有非保留字均以斜体表示。)
在图 10 中,GENERATE 模块代表到达事件,其到达间隔时间由 RVEXPO(1,&IAT) 指定。RVEXPO 表示「随机变量,服从指数分布」,其中的 1 表示要使用的随机数流,而 &IAT 表示指数分布的均值时间取自所谓的安培变量(ampervariable)&IAT。安培变量的名字以「&」字符开头;Wolverine 之所以在 GPSS 中引入安培变量,是因为最初的 IBM 实现对普通全局变量的支持很有限,用户在命名它们方面毫无自由。
下一个模块是一个名为 SYSTIME 的 QUEUE 模块。需要指出的是,在 GPSS 中,队列或排队线的形成并不需要 QUEUE 模块。QUEUE 模块的真正目的是与 DEPART 模块配合使用,以收集队列或任何其他子系统的数据。在例 3 中,我们要测量系统响应时间——也就是事务在系统中所耗费的时间。在事务进入系统之处放置一个 QUEUE 模块,并在事务完成处理之处放置与之配对的 DEPART 模块,响应时间就会被自动收集起来。DEPART 模块的用途是标示对单个事务的数据收集结束。QUEUE 与 DEPART 模块的组合对于排队建模并非必需,它只用于统计数据的收集。
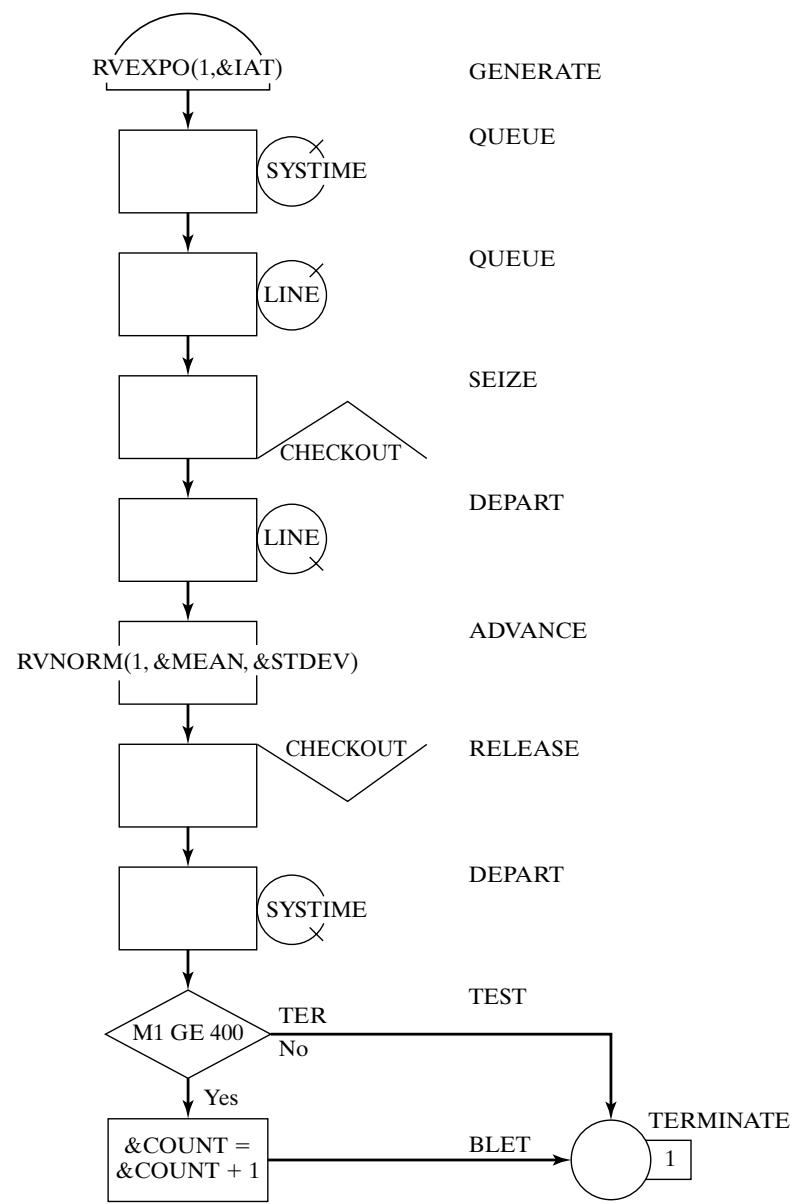
图 10 单服务台队列仿真的 GPSS 方块图。
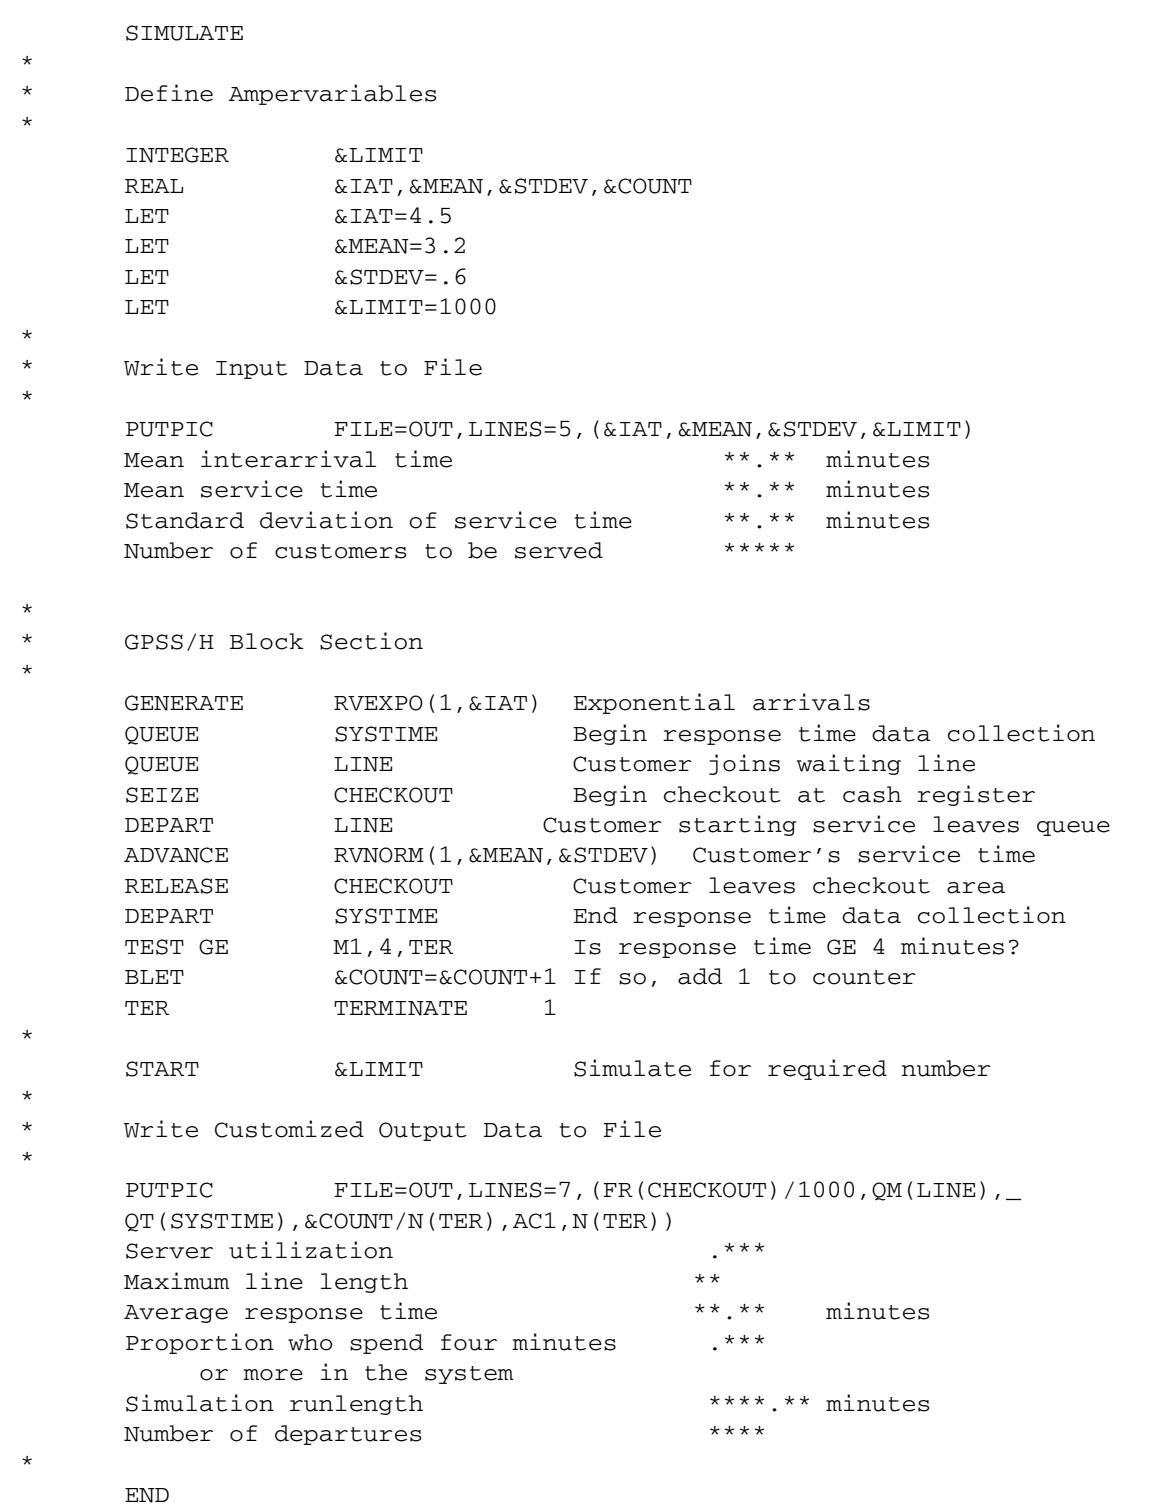
图 11 单服务台队列仿真的 GPSS/H 程序。
下一个 QUEUE 模块(队列名为 LINE)开始为收银员前的排队线收集数据。顾客可能需要等待收银员,也可能不需要。当顾客到达一个空闲的收银台,或在排队线中前进到队首时,该顾客就「占用」收银员,这由资源名为 CHECKOUT 的 SEIZE 模块表示。一旦代表顾客的事务占用了由资源 CHECKOUT 表示的收银员,排队线统计的数据收集即告结束,这由队列名为 LINE 的 DEPART 模块表示。事务在收银员处的服务时间由一个 ADVANCE 模块表示。RVNORM 表示「随机变量,服从正态分布」。这里同样使用随机数流 1,正态分布的均值时间由安培变量 &MEAN 给出,其标准差由安培变量 &STDEV 给出。接下来,顾客通过一个 RELEASE 模块放弃对设施 CHECKOUT 的使用。响应时间数据收集的结束,由队列 SYSTIME 的 DEPART 模块标示。
接下来是一个 TEST 模块,用来检验在系统中的时间 M1 是否大于或等于 4 分钟。(注意,M1 是 GPSS/H 中的保留字;它自动跟踪事务在系统中的总时间。)在 GPSS/H 中,其语义是「若为真,则顺序通过」。因此,若顾客已在系统中停留了 4 分钟或更久,接下来的 BLET 模块(代表 LET 模块)就使计数器 &COUNT 增加 1。若条件不成立,转出的路径通向标号为 TER 的模块。该标号出现在 TERMINATE 模块之前,后者的用途是把事务从系统中移除。TERMINATE 模块的值为「1」,表示向限额值(或称「尚待处理的事务数」)再计入一个事务。
本例中的控制语句,就是图 11 中位于模块段之前或之后的那些行。(模型中从 GENERATE 模块到 TERMINATE 模块共有十一个模块。)以「*」开头的控制语句是注释,其中有些仅用于排版留白。控制语句 SIMULATE 指示 GPSS/H 开展一次仿真;若省略它,GPSS/H 只会编译模型并检查错误。安培变量由 INTEGER 与 REAL 控制语句定义为整数型或实型。安培变量 &COUNT 似乎应当定义为整数;然而,它稍后要除以一个实数值。若它是整数型,则整数除以实数的结果是截断,这在本例中并非所愿。四条赋值语句(LET)为仿真提供数据。这四个值本可直接写入程序;然而,更可取的做法是把它们放在程序顶部的安培变量中,以便于更方便地修改,或者把模型改为从数据文件读取它们。
为确保模型数据正确,也为了管理所仿真的不同方案,把输入数据回显出来是一种良好的做法。这通过 PUTPIC(意为「put picture」)控制语句来完成。PUTPIC 之后的五行提供格式信息,其中的星号是标记(称为图片格式),PUTPIC 执行时四个安培变量的取值就替换掉这些星号。因此,「**.**」表示该值在小数点后可有两位数字、小数点前最多可有两位数字。
| 平均到达间隔时间 | 4.50 分钟 |
|---|---|
| 平均服务时间 | 3.20 分钟 |
| 服务时间的标准差 | 0.60 分钟 |
| 要服务的顾客数 | 1000 |
| 服务台利用率 | 0.676 |
| 排队线最大长度 | 7 |
| 平均响应时间 | 6.33 分钟 |
| 在系统中停留四分钟及以上者所占比例 | 0.646 |
| 仿真运行长度 | 4767.27 分钟 |
| 离开次数 | 1000 |
图 12 单服务台队列仿真的定制 GPSS/H 输出报告。
START 控制语句控制仿真的执行。它启动仿真,建立一个初始值为其操作数(&LIMIT)的「待终止计数」(termination-to-go),并控制仿真的长度。
仿真完成后,用第二条 PUTPIC 控制语句把所需的输出数据写入同一个文件 OUT。所打印的统计量全部由 GPSS 自动收集。括号列表中的第一项输出是服务台利用率。FR(CHECKOUT)/1000 表示打印资源 CHECKOUT 的小数形式的利用率。由于 FR(CHECKOUT) 的单位是千分数,因此提供分母用以计算小数形式的利用率。QM(LINE) 是仿真期间队列 LINE 中的最大值。QT(SYSTIME) 是在队列 SYSTIME 中的平均时间。&COUNT/N(TER) 是响应时间为四分钟及以上的顾客数除以经过标号为 TER 的模块的顾客数,即 N(TER)。AC1 是时钟时间,其最后一个值给出仿真的长度。
定制输出文件 OUT 的内容见图 12。标准 GPSS/H 输出文件见图 13。虽然文件 OUT 中所示的许多相同数据也可以在标准 GPSS/H 输出中找到,但定制文件更为紧凑,并且使用的是问题的语言而非 GPSS 的行话。定制输出文件还有很多其他用处。例如,若要对模型做 50 次重复实验,并希望得到某个响应时间的最小值、最大值和平均值,那么用控制语句即可做到,结果形式非常紧凑,而不必从 50 个标准输出文件中提取所需数值。
6 用 SSF 进行仿真
可扩展仿真框架(Scalable Simulation Framework, SSF)是一个应用程序接口(Application Program Interface, API),它描述了一组面向对象、面向过程视角仿真的能力。该 API 十分稀疏,其设计目的是让各种实现能够达到高性能(例如在并行计算机上)。C++ 与 Java 都有 SSF API 的实现,两种语言中也都有相应的实现。SSF 拥有广泛的用户群——尤其是借助附加框架 SSFNet(www.ssfnet.org)进行网络仿真的用户。本书关于网络仿真的一章就使用了 SSFNet。
| BLOCK CURRENT | TOTAL | BLOCK | CURRENT | TOTAL | ||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 1003 | TER | 1000 | |||||||
| 2 | 1003 | |||||||||
| 3 | 3 | 1003 | ||||||||
| 4 | 1000 | |||||||||
| 5 | 1000 | |||||||||
| 6 | 1000 | |||||||||
| 7 | 1000 | |||||||||
| 8 | 1000 | |||||||||
| 9 | 1000 | |||||||||
| 10 | 646 | |||||||||
| –AVG-UTIL-DURING– | ||||||||||
| FACILITY | TOTAL | AVAIL | UNAVL | ENTRIES | AVERAGE | CURRENT | PERCENT | SEIZING | PREEMPTING | |
| TIME | TIME | TIME | TIME/XACT | STATUS | AVAIL | XACT | XACT | |||
| CHECKOUT | 0.676 | 1000 | 3.224 | AVAIL | ||||||
| QUEUE | MAXIMUM | AVERAGE | TOTAL | ZERO | PERCENT | AVERAGE | $ AVERAGE | QTABLE | CURRENT | |
| CONTENTS | CONTENTS | ENTRIES | ENTRIES | ZEROS | TIME/UNIT | TIME/UNIT | NUMBER | CONTENTS | ||
| SYSTIME | 8 | 1.331 | 1003 | 0 | 6.325 | 6.235 | 3 | |||
| LINE | 7 | 0.655 | 1003 | 334 | 33.3 | 3.111 | 4.665 | 3 | ||
| RANDOM | ANTITHETIC | INITIAL | CURRENT | SAMPLE | CHI-SQUARE | |||||
| STREAM | VARIATES | POSITION | POSITION | COUNT | UNIFORMITY | |||||
| 1 | OFF | 100000 | 103004 | 3004 | 0.83 |
图 13 单服务台队列仿真的标准 GPSS/H 输出报告。
SSF API 定义了五个基类。process 是一个实现控制线程的类;其派生类的 action 方法包含线程的执行体。Entity 类用于描述仿真对象,它包含状态变量、进程以及通信端点。inChannel 与 outChannel 类是通信端点。Event 类定义实体之间发送的消息。一个模型实体通过把一个 Event「写入」某个 outChannel 与另一个实体通信;在稍后的某个时刻,该事件会在一个或多个 inChannel 上可用。期待从某个 inChannel 获得输入的进程可以挂起,等待其上的事件。下面我们在实现单服务台队列的 SSF 模型的过程中,会对这些要点以及其他要点逐一展开。
图 14 中的源代码表达了单服务台队列示例中用 SSF 生成到达的逻辑。该示例建立在两个 SSF 进程之上:其中一个生成作业并把它们加入系统,另一个为排入队列的作业提供服务。类 SSQueue 是一个包含整个仿真实验的类。它使用辅助类 Random(用于随机数生成)和 Queue(以实现一般对象的 FIFO 排队)。SSQueue 定义了实验常量(「public static final」类型),并包含 SSF 通信端点 out 与 in,两个进程通过它们相互通信。SSQueue 还定义了一个内部类 arrival,用于存储每个作业的标识与到达时间。
类 Arrivals 是一个 SSF 进程。它的构造函数存储拥有它的实体的标识,并创建一个以传入种子初始化的随机数发生器。除首次调用之外,方法 action 生成并入队一个新的到达者,然后(通过 SSF 方法 waitFor)阻塞一个到达间隔时间;在首次调用时,它跳过作业生成这一步,阻塞一个初始到达间隔时间。对 waitFor 的调用突出了若干需要解释的细节。SSQueue 对象调用 Arrival 的构造函数,并被保存为「所有者」。该类包含一个辅助方法 exponential,它使用指定的随机数流、按规定均值对指数随机变量进行抽样。它还包含方法 d2t 与 t2d,用在基于离散的「节拍」(tick)的整数时钟与双精度浮点表示之间作转换。在 waitFor 调用中,我们使用前面见过的相同代码以双精度格式对指数分布抽样,然后用 d2t 把它转换成仿真器的整数时钟格式。具体的换算因子作为一个 SSQueue 常量列出,即每单位时间 个节拍。
在本例中,SSF 的进程间通信用得很少。由于服务是不可抢占的,当一个作业的服务完成时,提供服务的进程可以检查等待顾客的列表(位于变量 owner.Waiting 中),看是否需要为另一位顾客提供服务。因此,服务台进程唯一需要被告知「有作业在等待」的时刻,就是有作业到达一个空系统的时候。这一点体现在 Arrivals.action 对其所有者 out 通道的使用上。
最后一点值得关注的是,按 SSF 的术语,Arrivals 是一个「简单」过程。这意味着在 action 中任何可能挂起进程的语句,在正常执行语义下都将是最后一条被执行的语句。Arrivals 类通过重写一个默认方法 isSimple 使其返回 true(而非默认值 false),从而告诉 SSF 它是一个简单过程。使用简单过程的关键理由是性能——它们不需要保存任何状态,只需要保存「该进程应当被重新激活」的条件。而且,当它被重新激活时,从 action 的第一行开始执行。
图 14 作业到达过程的 SSF 模型。
图 15 给出 Server 进程的代码。与过程 Arrival 一样,它的构造函数由 SSQueue 的一个实例调用,并被告知该实例的标识和一个随机数种子。与 Arrival 一样,它也是一个简单过程。它维护状态变量 in_service 以记住正在服务的作业的细节,并维护状态变量 service_time 以记住为正在服务的作业抽样得到的服务时间取值。当 SSF 内核调用 action 时,要么有一个作业完成了服务,要么 Arrival 进程刚刚通过 inChannel 向 Server 发出了信号。我们通过查看变量 in_service 来区分这两种情形:若有一个作业刚刚完成服务而仍在服务中,该变量就非空。在这种情况下,要更新一些统计量。这项任务完成后,就要检查是否有顾客在等待服务。等待列表中的第一位顾客被出队,并被复制到 in_service 变量中;随后该进程抽样一个服务时间,并通过 waitFor 调用挂起。若没有顾客在等待,该进程就挂起在一条 waitOn 语句上,直到来自 Arrival 进程的事件把它唤醒。
图 15 单服务台队列的 SSF 模型:Server。
SSF 弥合了纯用 Java 开发的模型与用专为仿真设计的语言开发的模型之间的鸿沟。它提供了通用程序设计语言所具有的灵活性,同时又具备仿真所必需的支持。
7 仿真环境
以下各小节所介绍的所有仿真软件包都在运行 Microsoft Windows 2000 或 XP 的 PC 上运行,多数也可在 Vista 下运行。虽然就具体细节而言各软件包彼此不同,但总体而言它们有许多共同之处。
共同特征包括图形用户界面、动画,以及自动收集的用于度量系统性能的输出。在几乎所有软件包中,仿真结果都可以以表格或图形形式显示于标准报告中,也可以在仿真运行期间以交互方式显示。不同方案的输出可以图形方式或表格方式加以比较。多数软件包提供统计分析,其中包括针对性能度量与性能比较的置信区间,以及其他各种分析方法。其中一些统计分析模块将在第 8 节中介绍。
此处介绍的所有软件包都采用过程交互世界观。有少数还允许事件调度模型以及离散-连续混合模型。在动画方面,有些强调二维或三维的比例图;另一些强调基于示意图或过程流程图的图标式动画。有少数同时提供比例图和示意图式的动画。几乎所有软件包都以时间线、条形图和饼图的形式提供动态商务图表。
除本章所含信息之外,下面给出的网址也可以进一步查看:
AnyLogic www.anylogic.com
Arena www.arenasimulation.com
AutoMod www.automod.com
Enterprise Dynamics www.incontrol.ne
ExtendSim www.extendsim.com
Flexsim www.flexsim.com
ProModel www.promodel.com
SIMUL8 www.simul8.com
7.1 AnyLogic
AnyLogic 是一种多方法仿真软件,支持离散事件(以过程为中心)建模、基于智能体的建模以及系统动力学。AnyLogic 背后的主要思想是:建模者可以选择最适合问题的方法(或者也许是方法的组合)与抽象层次,从而捕捉制造、物流、业务流程、人力资源或客户行为的复杂性与异质性,以及经济与社会系统的宏观层次动态及它们之间的相互作用。
AnyLogic 包含一个用于过程建模的对象库(Source、Delay、Queue、Resource-Pool 等),支持智能体的空间、移动性、网络、交互以及各种行为定义形式,并为系统动力学模型提供存量-流量图。AnyLogic 仿真引擎支持混合(离散加连续)时间。
AnyLogic 模型(以及模型开发环境)基于 Java,因而是跨平台的。模型可以作为 Java 小程序(applet)发布到 Web 上,使远端用户能够在自己的浏览器中执行它们。模型有许多「扩展点」,用户可以在其中输入 Java 表达式与动作。
动画编辑器是 AnyLogic 模型开发环境的一部分。该编辑器支持大量多种图形形状、控件(滑块、按钮、文本输入框等)、图像、GIS(地理信息系统)地图以及导入的 CAD 图形。可以开发可缩放的、可分层的动画。例如,用户可以创建一个带某些汇总指标的制造流程全局视图,以及特定作业的详细动画,并在这些视图之间切换。
模型的输入数据可以用分布拟合软件 Stat::Fit(www.geerms.com)处理,该软件支持 AnyLogic 的概率分布语法。仿真输出可以在模型内部作统计处理与可视化(提供多种图表与直方图),也可以导出到数据库、文本文件或电子表格中。
AnyLogic 的实验框架包括简单仿真、参数变化、比较运行、敏感性分析、蒙特卡罗(Monte Carlo)、校准(calibration)、优化以及自由形式的自定义实验。OptQuest 优化引擎(见 8.2 节)已完全集成到 AnyLogic 中。
AnyLogic 有两个版本:Advanced 与 Professional。Professional 版允许用户把模型导出为独立的 Java 应用程序、嵌入 GIS 地图与 CAD 图形;它与版本控制软件集成以改善团队协作,包含功能完备的调试器,并允许用户在仿真运行期间保存模型状态并在稍后恢复。它还包含 Pedestrian Library,用于对行人密集区域进行高精度的物理层次建模。
7.2 Arena
Arena Basic 版与 Professional 版由 Rockwell Automation 提供。Arena 是一种可用于仿真离散系统与连续系统的通用仿真软件。
Arena Basic Edition 面向业务流程建模以及满足高层分析需要的其他系统。它用层次化流程图表示过程动态,并把系统信息存储在数据电子表格中。它内含基于活动的成本核算,并与流程图软件 Visio 紧密集成。
Arena Professional Edition(PE)用于构建更为细致的离散与连续系统模型。Arena PE 于 1993 年首次发布,采用基于对象的设计,实现完全图形化的模型开发。仿真模型由称为模块(modules)的图形对象构成,用以定义系统逻辑以及机器、操作员、职员或医生等物理构件。模块由图标加上在对话框窗口中输入的关联数据来表示。这些图标被连接起来以表示实体的流动。模块被组织成称为模板(templates)的集合。模板是提供通用特性、可用于各类应用建模的核心模块集合。除了资源、队列、过程逻辑和系统数据等标准特性之外,Arena 的模板还包含专注于制造、物料搬运和流程式系统之特定方面的模块。借助内建的连续建模能力和专用的流程模板,Arena PE 也可用于建模离散/连续组合系统,例如制药与化工生产。这一版本还赋予用户定制仿真对象的能力,这些对象可映射真实系统的各个组成部分,包括术语、过程逻辑、数据、性能指标与动画。
Arena 家族还包括专门用于建模呼叫中心与高速生产线的产品,即 Arena Contact Center 与 Arena Packaging Edition。这些产品可与 Professional Edition 配合使用。
Arena 的核心是 SIMAN 仿真语言。Arena 的开放架构(包括内嵌的 Visual Basic for Applications(VBA))使它既能与其它应用程序交换数据,也便于开发定制接口。为了给仿真模型制作动画,Arena 的核心建模构件配有显示队列、资源状态和实体流动的标准图形。Arena 的二维动画使用 Arena 内建的绘图工具,并结合剪贴画、AutoCAD、Visio 以及其他图形来制作。Arena 3DPlayer 可用于生成三维图像,以观看 Arena 模型的三维动画。
Arena 的 Input Analyzer 自动化了为已有数据(如处理时间与到达间隔时间)选择适当分布及其参数的过程。OptQuest 优化引擎(第 8.2 节)已完全集成到 Arena 中。Output Analyzer 与 Process Analyzer(第 8.2 节)则自动化了对不同设计备选方案的比较。
7.3 AutoMod
AutoMod Product Suite 由 Applied Materials 提供。它包括 AutoMod 仿真软件包、用于实验与分析的 AutoStat,以及用于制作三维动画 AVI 影片的 AutoView。AutoMod 仿真产品的主要着眼点是制造系统与物料搬运系统。AutoMod 的长处在于用于规划、运行决策支持与控制系统测试的详尽大型模型。
AutoMod 为大多数常见的物料搬运系统内建了模板,包括车辆系统、输送带、自动化存储与检索系统(AS/RS)、桥式起重机、动力式与自由式输送带,以及运动学(机器人)系统。它还包含一个功能强大的模型通信模块,使模型能够与控制系统以及其他仿真模型进行通信。
AutoMod 的 pathmover 车辆系统可用于建模叉车、步行或推车的人、自动导引车、牵引车、列车、空中运输车辆、单轨、卡车与小汽车。所有移动模板都基于三维比例图(绘制而成,或从 CAD 以二维或三维形式导入)。模板的所有构件都高度参数化。例如,输送带模板包含输送带段、驱动各段的电机、用于装载或卸载的站点,以及光电传感器(photo-eyes)。各段由长度、宽度、速度、加速度以及类型(积放式或非积放式)定义,另有其他专用参数。当产品由输送带系统运送时,产品(负载)的尺寸以及各输送带段的属性都得到精确计量,从而为极为精确的仿真结果提供了工具。
除物料搬运模板之外,AutoMod 还包含一门完整的仿真程序设计语言。一个 AutoMod 模型由一个或多个系统组成。系统可以是流程系统(在其中定义流动与控制逻辑),也可以是移动系统(基于某个物料搬运模板)。一个模型可以包含任意数量的系统(没有规模限制),这些系统可被保存并作为对象在别的模型中复用。流程中可以包含复杂逻辑,用于控制制造材料(负载)或控制消息的流动。由负载执行的过程逻辑,可以简单也可以复杂,视实现期望的仿真行为而定。其三维动画可以从任何角度或透视实时观看,也可以按加速的时间尺度观看。用户可以自由地对仿真模型的三维世界进行缩放、平移或旋转。
在 AutoMod 的世界观中,负载(产品、零件等)从一个流程移动到另一个流程,并竞争资源(设备、操作员、车辆、输送带空间以及队列)。负载是主动实体,在每个流程中执行动作语句。负载可以直接从流程发送到流程,也可以借助输送带或车辆移动系统来发送。
第 8.2 节介绍的 AutoStat 与 AutoMod 模型配合工作,为用户提供一个完整的环境,以定义方案、确定预热期、开展包括实验设计在内的实验,并进行分析。它还提供基于进化策略的优化。
7.4 Enterprise Dynamics
Enterprise Dynamics 是由 Incontrol Simulation Software, Inc. 提供的一个仿真平台。Enterprise Dynamics 是一个面向对象、采用事件调度的离散事件仿真器,拥有自己的内建函数式仿真程序设计语言 4DScript。Enterprise Dynamics 随附一个 Atoms 库,可在核心应用领域(制造与物料搬运系统、物流与运输)中快速建模。另有一套独立的 Atoms 与应用,可用于构建机场仿真器,其中包括行李与旅客流。
Enterprise Dynamics 拥有一个基于 OpenGL 的三维可视化引擎,以「虚拟现实」方式提供三维可视化。三维可视化在仿真阶段与建模阶段都可以查看。
当工厂提供的 Atom 库不足以满足特定建模需求时,可以在其仿真语言 4DScript 中,用一千五百多个可用函数定制模型外观与行为的其他方面。模型代码可以「即时」修改,无需重新编译或停止仿真。其他旨在支持模型开发的平台特性包括:CAD 图形导入向导;数据库接口(既有 ODBC 也有 ADO),以便把较大模型的结构与数据存储在 RDBMS(SQL Server、Oracle、MySQL、Access)中;XML 支持,以便与其他系统交换信息;以及 ActiveX 接口,它使用户能够利用 Enterprise Dynamics 的仿真引擎(在幕后不可见)开发定制的仿真解决方案。
Enterprise Dynamics 中较新的一个附加组件是 Emulation 插件,它允许生产系统的仿真模型与管理该系统的物流软件之间建立接口。这样,用户就可以在实际硬件到位之前先行测试物流软件。该模拟接口有多个层次可选,从用于测试 PLC 电路的直接 PLC 通信(使用 OPC),一直到与物流软件的高层接口。
如有必要,结果可导出到 MS Office 应用程序以供进一步分析。OptQuest 优化引擎(见第 8.2 节)已完全集成到 Enterprise Dynamics 中。
7.5 ExtendSim
ExtendSim 产品系列由 Imagine That Inc. 提供 [Krahl, 2008]。ExtendSim OR 用于仿真离散事件系统与离散-连续混合系统。ExtendSim AT 增加了用于基于速率的批处理系统的离散速率模块,ExtendSim Suite 则增加了三维动画。
ExtendSim CP 仅用于连续建模。ExtendSim 把拖放式用户界面与用于创建自定义构件的开发环境结合起来。称为模块(blocks)的图形对象既表示逻辑要素,也表示物理要素。模型可以通过放置并连接模块以图形方式构建,然后在模块的对话框中输入参数。模型也可以利用 ExtendSim 的脚本功能以程序方式创建。
每个 ExtendSim 模块都带有图标、用户界面、动画、预编译代码和在线帮助。基本模块包括 Create、Queue、Activity、Resource Pool 和 Exit。在 ExtendSim 中被称为 items(项)的主动实体,产生于 Create 模块,并通过 item 连接器从一个模块移动到另一个模块。独立的价值连接器(value connectors)允许把一个计算式挂接到模块参数上,或为报告目的而提取统计信息。输入参数可以在模型运行期间以交互方式更改,可以来自内部或外部来源。输出以图形和表格形式动态显示。模块被统一组织成通用构件库,以及面向特定应用(如高速包装线和化工生产)的专用库。第三方开发者已为垂直市场创建了 ExtendSim 库,其中包括供应链动态、通信系统以及纸浆与造纸加工。
ExtendSim 提供方块图的图标式过程流程动画。Suite 产品包含的三维动画独立于逻辑仿真模型但与之集成:三维动画可以并行运行,也可以被缓冲。代表子模型(例如一条分装线或一个功能流程)的模块集合,可以在模型工作表上组合为一个分层模块。ExtendSim 支持多层次的层次结构,分层模块可存入库中以供复用。关键参数的克隆可以组合起来并显示在工作表层面,供用户访问模型仪表板。ExtendSim 还支持基于智能体的建模、基于活动的成本核算,以及带置信区间的输出数据统计分析。ExtendSim 包含一个进化优化器以及一个集成的关系数据库。模块参数与数据表可与 ExtendSim 数据库表动态链接,以实现集中式数据管理。
ExtendSim 支持 Microsoft 组件对象模型(COM/ActiveX)、开放数据库互连(ODBC)以及文件传输协议(FTP),以进行互联网数据交换。新模块既可以分层方式创建,也可以使用基于 C 的编译型程序设计环境来创建。其基于消息的语言包含仿真专用函数与定制接口开发工具。ExtendSim 具有开放的架构——为模块修改与定制开发提供源代码。该架构还支持链接并使用以外部语言编写的代码与例程。
7.6 Flexsim
Flexsim 仿真软件由犹他州 Orem 的 Flexsim Software Products, Inc. 开发并拥有 [Nordgren, 2003]。Flexsim 是一个用 C++ 开发、采用 Open GL 技术的离散事件、面向对象仿真器。动画以三维并以虚拟现实方式呈现。所有视图在模型开发阶段或运行阶段都可以同时显示。Flexsim 把 Microsoft 的 Visual C++ IDE 与编译器集成到一个图形化的三维拖放式仿真环境中。
2007 年,Flexsim 推出了自己的预编译语言 Flexscript,允许在模型运行之前无须编译即可编程。目前 Flexsim 同时提供 Flexscript 与 C++ 两种语言用于建模复杂算法。任何流动系统或流程的仿真模型都可以在 Flexsim 中通过使用拖放式建模对象来创建。Flexsim 提供了按特定需求定制对象的能力。用户可以把修改过的对象加入自己的用户库,该库可以保存并在组织内共享。稳健的默认值使建模者能够迅速让模型运行起来。Flexsim 为离散事件、连续以及基于智能体的建模提供对象库。
2008 年,Flexsim 推出了离散事件仿真(DS)软件,用于在计算机网络或互联网上运行大型模型,模型的处理可分布在任意数量的处理器上。Flexsim DS 可用于借助数百台互联计算机建模大型复杂系统。Flexsim DS 允许多用户协作建模。建模团队可以通过互联网从远程位置协同工作,共同构建模型、分析结果并开展实验。Flexsim DS 支持模型的演进与协作设计,全部在虚拟现实环境中进行。
7.7 ProModel
ProModel 由成立于 1988 年的 ProModel Corporation 提供。它是一款仿真与动画工具,主要为建模制造系统而设计。虽然 ProModel 可以而且常常被用于对非制造系统建模,该公司还提供面向医疗仿真(MedModel)与服务系统仿真(ServiceModel)的类似产品。
ProModel 是 Microsoft Gold Certified Partner,并提供一个名为 Process Simulator 的 Microsoft Visio 插件,用于对任何行业的流程图、价值流图与设施布局进行仿真。它还提供一个 Microsoft Project 插件,用于对各种类型的项目建模,这些项目可能具有可变任务时间与共享资源。
除了提供面向广泛流程与项目的建模方案之外,ProModel 还提供若干针对特定类型规划问题的专门仿真产品。其中包括 Emergency Department Simulator(EDS),用于确定急诊室的资源需求并分析病人流;以及 Portfolio Simulator,用于可视化、分析和优化产品与项目组合。另有更多产品已经开发出来,并成功应用于美国国防部的资源产能规划。
ProModel 提供二维与三维动画,以及在仿真期间更新的动态图表与计数器。动画布局在模型开发过程中自动生成,使用来自预定义库的图形或由用户导入的图形。
模型使用图形用户界面与建模构件构建。ProModel 的能力包括用于对操作员、叉车、输送带、起重机、自动导引车系统以及泵与储罐建模的构件。ProModel 根据用户输入的材料、人工和设备成本自动跟踪成本数据。
ProModel 与 Microsoft Excel 及其他商用数据库程序接口,以开发集成化解决方案。它还提供 COM 接口用于定制并与其他应用建立连接。ProModel 支持协作建模,模型可以分别构建与维护,并在需要时协同运行。
除生成标准与定制输出报告之外,ProModel 还把数据导出到 Excel 以供更深入的分析,也导出到 Minitab 以自动生成六西格玛六联图(six-sigma six-pack charts)和过程能力图。ProModel 的运行时界面允许用户定义多个方案用于实验和并排比较。第 8.2 节讨论的 SimRunner 增加了执行仿真优化的能力。它基于进化策略算法,是遗传算法方法的一个变种。第 8.2 节讨论的 OptQuest 优化引擎已完全集成到 ProModel 中。
7.8 SIMUL8
SIMUL8 由 SIMUL8 Corporation 提供,最早于 1995 年推出。在 SIMUL8 中,模型是用计算机鼠标画出工作流程而创建的,用图标和箭头表示系统中的资源与队列。图标的所有属性都提供了默认值,因此在建模过程的早期就可以观看动画。在属性框中逐层下钻,可展开越来越详细的属性。SIMUL8 的主要着眼点是服务业,在那里人们处理事务,或者他们本身就是事务(例如在银行、呼叫中心或医院中)。
与其他一些软件包一样,SIMUL8 有「模板」(Templates)和「构件」(Components)的概念。模板(即预建的仿真)聚焦于特定的、反复出现的决策类型,可以快速参数化以适应某家公司的具体问题。构件是用户定义的图标,可以在一家公司的各个仿真中复用与共享。这缩短了构建仿真的时间,标准化了整个公司对某些情形的处理方式,并且往往省去了仿真研究中数据收集阶段的许多工作。
SIMUL8 Corporation 的做法是把仿真广泛地推广到各行各业,而不是把它集中在专职且受过高度训练的仿真专业人员手中。这意味着它们的定价与支持政策大不相同,但这也意味着软件必须包含一些能监视产品使用方式的功能,并在可能进行了无效分析时提供帮助。
SIMUL8 以 XML 格式保存其仿真模型与数据,因而易于与其他应用程序之间互相传输。它有一个用于构建定制数据录入「前端」的接口,并支持 COM/ActiveX,因而外部应用程序可以构建和控制 SIMUL8 仿真。
该产品有一个基于 Web 的版本,任何拥有互联网浏览器的人都可以运行模型,并分为 Standard 与 Professional 两个级别。两个级别提供相同的仿真特性,但 Professional 版增加了三维「虚拟现实」视图、与企业数据库的链接、一个优化器、版本跟踪,以及其他可能只有专职仿真建模者才用得上的特性。
8 实验与统计分析工具
8.1 共同特征
几乎所有仿真软件包都以不同程度支持对仿真输出的统计分析。近年来,许多软件包已把优化作为分析工具之一。为支持分析,多数软件包提供方案定义、运行管理能力,以及向电子表格和其他外部应用程序导出数据的功能。
优化用于寻找「近似最优」的解。用户必须定义一个目标函数或适应度函数,通常是一个成本或类似成本的函数,它综合考虑了额外吞吐量与额外资源之间的权衡。直到不久前,可用于优化系统的方法仍难以应对大多数仿真输出所具有的随机性与非线性。元启发式(metaheuristics)领域中的进展为仿真优化提供了新的途径,这些途径基于人工智能、神经网络、遗传算法、进化策略、禁忌搜索与分散搜索。
8.2 产品
本节简要讨论 Arena 的 Output 与 Process Analyzer、用于 AutoMod 的 AutoStat、OptQuest(在若干仿真产品中使用),以及用于 ProModel 的 SimRunner。
Arena 的 Output 与 Process Analyzer
Arena 随附 Output Analyzer 与 Process Analyzer。此外,Arena 使用 OptQuest 进行优化。
Output Analyzer 提供置信区间、多个系统之间的比较,以及用于减少初始条件偏差的预热期判定。它可生成各种图形、图表与直方图,可对响应做平滑处理,并可进行相关性分析。
Process Analyzer 为 Arena 增加了用于综合性实验设计的复杂方案管理能力。它允许用户定义方案、执行所需的运行并分析结果。它允许任意数量的控制变量与响应变量。响应变量可以在运行完成之后再行添加。它可按任一响应变量对方案排序,并给出响应变量的汇总与统计度量。用户可以查看跨重复实验或跨方案的响应取值的二维与三维图表。
AutoStat
AutoStat 是 AutoMod 产品系列中的运行管理器与统计分析产品。AutoStat 提供多种分析,包括用于稳态分析的预热期判定、绝对置信区间与比较置信区间、实验设计、敏感性分析,以及通过进化策略实现的优化。
借助 AutoStat,终端用户可以通过定义因子及其取值范围来定义任意数量的方案。因子包括模型输入参数,例如资源产能、车辆数量或车辆速度。数据文件(可以是某个特定的单元格,也可以是整个文件)同样可以定义为输入因子。通过允许把数据文件用作因子,用户可以针对例如备选生产计划、不同日期的客户订单、不同排班表,或任何其他通常在数据文件中指定的数值输入开展实验。任何标准输出或定制输出都可以指定为响应变量。对于每一个已定义的响应变量,AutoStat 计算描述性统计量(平均值、标准差、最小值与最大值)以及置信区间。由于 AutoStat 会保存并压缩所有运行的标准输出与定制输出,因此在运行完成之后还可以定义新的响应变量。为进行图形比较,还提供了各种图表与图形。
AutoStat 帮助判定哪些结果与哪些备选方案在统计上显著,也就是说,所观察到的结果极有可能并非由随机波动所引起。AutoStat 支持使用公共随机数的相关抽样(correlated sampling)。这种抽样技术把配对样本之间的变异降到最低,从而更好地反映模型变动的真实影响。
AutoStat 能够把仿真运行分布到局域网上,并把所有结果取回用户的计算机。对多台计算机与多个 CPU 的支持,使用户能够通过利用非工作时间的空闲计算机,完成远超常规可能的仿真运行次数。这在多因子分析与优化研究中尤其有用,因为这两类研究都可能需要大量的运行次数。AutoStat 还具有诊断能力,能自动检测「异常」运行,而「异常」的定义由用户确定。
AutoStat 还可与 AutoSched AP 配合使用,后者是半导体行业有限产能排程的基于规则的仿真软件包。
OptQuest
OptQuest 由科罗拉多大学的 Fred Glover、James Kelly 和 Manuel Laguna 开发,他们是 OptTek Systems, Inc. 的联合创始人 [April et al., 2003]。OptQuest 基于多种方法的组合:分散搜索、禁忌搜索、线性/整数规划以及数据挖掘(含神经网络)。分散搜索是一种基于种群的方法,把已有的解组合起来产生新的解。禁忌搜索是一种自适应记忆搜索方法,叠加其上可使方法远离过去的解而奔向更好的解;数据挖掘则进一步筛除那些可能较差的解。这些方法的组合使搜索过程能够摆脱局部最优,以追求最佳解。OptTek 的方法具有以下若干特性:
- 能够处理标准数学规划公式所用的各类方程与公式无法刻画的非线性与不连续关系;
- 能够处理多种类型的约束(线性的与非线性);
- 能够处理多个目标;
- 能够构造解的有效前沿,以支持决策分析;
- 能够求解涉及不确定的供应、需求、价格、成本、流量与排队速率的问题。
OptQuest 的核心技术已被嵌入众多基于仿真的应用中,范围从项目组合管理(Project Portfolio Management)到劳动力优化(Workforce Optimization)。
SimRunner
SimRunner 由 PROMODEL Corporation 依据 Mississippi State University 的 Royce Bowden 关于仿真优化的研究成果开发 [Harrell et al., 2003]。它可用于 ProModel、MedModel 与 ServiceModel。
SimRunner 使用遗传算法与进化策略,它们都是进化算法(evolutionary algorithms)的变种。进化算法以这样的方式操作问题的解种群:劣解逐渐消亡,优解则持续向最优解演化。这些基于种群的直接搜索技术能够避免陷入局部最优解。进化算法已被证明是稳健的:它们已被成功用于求解大量各类困难的真实世界问题,这些问题是非线性的、多峰式的、多维的、不连续的以及随机的。
在 SimRunner 中调用进化算法之前,用户首先要指定由 ProModel 宏构成的输入因子(整数或实值决策变量),然后指定由仿真输出响应构成的目标函数。SimRunner 在用户所规定的约束内操作这些输入因子,力求使目标函数最小化、最大化,或达到用户指定的目标值。优化输出报告包含在优化过程中对每个所求值解的、目标函数均值的置信区间,并显示所求值解的仿真输出响应面的三维图。解可以按目标函数值(默认方式)、按用于定义目标函数的各个仿真输出响应,或按任一决策变量来排序。
除了多变量优化模块之外,SimRunner 还提供若干模块,帮助用户估计稳态仿真的预热阶段(初始化偏差)的结束点,以及为了在给定的百分比误差与置信水平内得到目标函数均值的估计值所需的重复实验次数。这两个模块对于获得目标函数均值的准确估计很有价值,而准确的估计是成功决策与仿真优化所必需的。
参考文献
APRIL, J., F. GLOVER, J. P. KELLY, AND M. LAGUNA [2003], “Practical Introduction to Simulation Optimization,” Proceedings of the 2003 Winter Simulation Conference, eds. S. Chick, P. J. S´anchez, D. Ferrin, and D. J. Morrice, New Orleans, LA, Dec. 7–10, pp. 71–78.
BANKS, J., J. S. CARSON, AND J. N. SY [1995], Getting Started with GPSS/H, 2d ed., Wolverine Software Corporation, Annandale, VA.
BANKS, J. [1996], “Interpreting Software Checklists,” OR/MS Today, Vol. 22, No. 3, pp. 74–78.
BANKS, J. [2008], “Some burning questions about simulation,” ICS Newsletter, Spring.
COWIE, J. [1999], “Scalable Simulation FrameworkAPI Reference Manual,” www.ssfnet.org/SSFdocs /ssfapiManual.pdf.
HARRELL, C. R., B. K. GHOSH, AND R. BOWDEN [2003], Simulation Using ProModel, 2d ed., New York: McGraw-Hill.
HENRIKSEN, J. O. [1999], “General-Purpose Concurrent and Post-Processed Animation with Proof,” Proceed ings ofthe 1999 Winter Simulation Conference, eds. P. A. Farrington, H. B. Nembhard, D. T. Sturrock, G. W. Evans, Phoenix, AZ, Dec. 5–8, pp. 176–181.
KRAHL, D. [2008], “ExtendSim 7” Proceedings of the 2008 Winter Simulation Conference, eds. S.J. Mason, R.R. Hill, L. M¨onch, O. Rose, T. Jefferson, and J.W. Fowler, Miami, FL, Dec. 7–10 pp. 215–221.
NANCE, R. E. [1995], “Simulation Programming Languages: An Abridged History,” Proceedings ofthe 1995 Winter Simulation Conference, eds. C. Alexopoulos, K. Kang, W. R. Lilegdon, and D. Goldsman, Arlington, VA, Dec. 13–16, pp. 1307–1313.
NORDGREN, W. B. [2003], “Flexsim Simulation Environment,” Proceedings of the 2003 Winter Simulation Conference, eds. S. Chick, P. J. S´anchez, D. Ferrin, and D. J. Morrice, New Orleans, LA, Dec. 7–10, pp. 197–200.
PRITSKER, A. A. B., AND C. D. PEGDEN [1979], Introduction to Simulation and SLAM, John Wiley, New York.
SWAIN, J. J. [2007], “New Frontiers in Simulation: Biennial Survey of Discrete-Event Simulation Software Tools,” OR/MS Today, October, Vol.34, No. 5, pp. 23–43.
TOCHER, D. D., AND D. G. OWEN [1960], “The Automatic Programming of Simulations,” Proceedings of the Second International Conference on Operational Research, eds. J. Banbury and J. Maitland, pp. 50–68.
WILSON, J. R., et al. [1992], “The Winter Simulation Conference: Perspectives of the Founding Fathers,” Proceedings of the 1992 Winter Simulation Conference, eds. J. Swain. D. Goldsman. R. C. Crain, and J. R. Wilson, Arlington, VA, Dec. 13–16, pp.37–62.
习题
对于下面的习题,读者应当用通用程序设计语言(如 C、C++ 或 Java)、专用仿真语言(如 GPSS/H),或任何一种自己中意的仿真环境来编写模型。
大多数题目都包含在区间 上均匀分布的活动。假定 a 与 b 之间的所有取值都是可能的;也就是说,活动时间是连续随机变量。
均匀分布记作 ,其中 a 与 b 是该区间的端点;也记作 其中 m 是均值,h 是该分布的「离散度」(spread)。这四个参数之间的关系由下面的方程给出:
有些可用的均匀随机变量生成器要求指定 a 与 而另一些则要求指定 m 与 h。
有些题目的活动假定为服从正态分布,记作 ,其中 是均值, 是方差。(由于活动时间非负,只有在 时正态分布才是合适的,其中 k 至少为 4,且最好为 5 或更大。若生成了负值,则将其舍弃。)另一些题目采用指数分布,其速率为 λ 或均值为 1/λ。所有这些语言都提供了从这些分布中方便地生成样本的设施。对于 C、C++ 或 Java 仿真,学生可以使用第 4 节给出的、用于从正态分布与指数分布中生成样本的函数。
对收银台的 Java 模型(例 2)作必要的修改,使仿真恰好运行 60 小时。
除了习题 1 中的修改外,还要假定在 60 小时时刻仍在收银台处的顾客都会得到服务,但 60 小时之后不再允许新的到达。对 Java 代码作必要的修改并运行模型。
在任意一种仿真软件包中实现习题 1 与习题 2 中的修改。
在一个大都市地区,救护车以每 15 ± 10 分钟一辆的速率派出。有 15% 的呼叫是误报,完成这些呼叫需要 12 ± 2 分钟。其余所有呼叫可以分为两类。第一类归为严重呼叫,它们占非误报呼叫的 15%,完成需要 25 ± 5 分钟。其余呼叫完成需要 分钟。假定可用的救护车数量非常大,任何时刻都可以有任意数量的救护车在出勤。对该系统进行仿真,直到完成 500 次呼叫。
在习题 4 中,估计救护车完成一次呼叫所需的平均时间。
(a) 在习题 4 中,假定只有一辆救护车可用。救护车外出期间到达的任何呼叫都必须等待。一辆救护车能否应付得了这份工作负荷?(b) 用 x 辆救护车进行仿真,其中 或 4,并从呼叫必须等待的时间长度、必须等待的呼叫所占百分比、以及救护车在出勤状态所占时间百分比这三个方面比较各备选方案。
Drafty Airlines 在 Dusty Plains 机场的登机柜台前有四名工作人员。旅客每 秒到达一次办理登机。为一位旅客办理登机需要 秒。Drafty Airlines 打算用自动旅客登机设备(APCID)替换这些工作人员。一个 APCID 为一位旅客办理登机需要 秒。为了使平均等待时间不大于使用四名工作人员时的当前等待时间,需要多少个 APCID?仿真运行 10 小时的仿真时间。
一条超级高速公路连接着两个大都市地区。车辆每 秒离开第一座城市。20% 的车辆载有 1 名乘客,30% 的车辆载有 2 名乘客,10% 载有 3 名乘客,10% 载有 4 名乘客。其余 30% 的车辆是公共汽车,每辆载有 40 人。车辆在两个大都市地区之间行驶需要 分钟。要让 5000 人到达第二座城市需要多长时间?
人们以每 秒一个的速率到达一个肉类柜台。柜台分为两个区:一个卖牛肉,一个卖鸡肉人们对两者的需求比例如下:只要牛肉的占 50%;只要鸡肉的占 30%;两者都要的占 20%。一名肉贩为一位顾客处理一份订单需要 秒。所有顾客都只下一个订单,只有「牛肉和鸡肉都要」的顾客下两个订单。假定在任何时刻都有足够的肉贩来应付所有在场的顾客。要为 200 位顾客服务完毕需要多长时间?
在习题 9 中,仿真过程中最多需要多少名肉贩?这个数量是否总能保证任何顾客都不必等待?
在习题 9 中,用 x 名肉贩进行仿真,其中 。当所有肉贩都忙碌时,就会形成队伍。对 x 的每个取值,估计忙碌肉贩的平均人数。
一家只有一张椅子的男女通用的理发店,顾客到达速率为每 分钟一位。到达的顾客中有一半只要干剪(dry cut),30% 要做造型,20% 只需修剪(trim)。干剪需 分钟,做造型需 分钟,修剪需 分钟。仿真 400 位顾客经过这家理发店。把各类服务请求的给定比例与仿真结果作比较。结果是否合理?
一座机场有两个航站楼。1 号航站楼的旅客到达速率为每 秒一位,2 号航站楼的旅客到达速率为每 秒一位。走完 1 号航站楼需 秒,走完 2 号航站楼需 秒。两个航站楼都通向紧邻行李提取处的主大厅。从主大厅到行李提取区需 秒。只有 60% 的旅客会前往行李提取区。仿真 500 位旅客通过机场系统的过程。其中有多少位旅客经过了行李提取区?在本问题中,经过行李提取区的期望人数可由 计算得到。仿真估计值与期望人数相差多少?如果确有差异,是什么原因?
在一家多阶段筛查诊所中,病人以每 分钟一个的速率到达,进入听力检查区。检查需 分钟。80% 的病人在下一项检查中没有问题而被通过。其余 20% 中,一半需要简单处置,耗时 分钟,然后以同样的不通过概率送去复检。另一半带着药回家。对该系统进行仿真,以估计筛查并通过 200 位病人需要多长时间。(注意:带药回家的病人不算「通过」。)
考虑一家有四名出纳员的银行。3 号和 4 号出纳员只办理对公账户,1 号和 2 号出纳员只办理对私账户。客户以每 分钟一位的速率到达银行。在客户中,33% 为对公账户。客户在每类账户对应的两名出纳员中随机选择。(假定顾客选择队伍时不考虑其长度,也不换队。)对公业务需 分钟办完,对私业务需 分钟办完。对该系统进行仿真,直到完成 500 笔业务。每类出纳员各自有多高比例的时间处于忙碌状态?每类顾客在银行中花费的平均时间是多少?
重复习题 15,但假定顾客会加入办理其账户类型的那名出纳员中队伍最短的一队。
在习题 15 与习题 16 中,估计对公顾客与对私顾客的平均延迟。(延迟是在排队线中花费的时间,不含服务时间。)还要估计排队线的平均长度,以及延迟超过 1 分钟的顾客所占比例的平均值。
有三台不同的机器可供加工某类特殊零件,每台每天各工作 1 小时。加工时间数据如下:
| 机器 | 加工一个零件所需的时间 |
|---|---|
| 1 | 20 ± 4 秒 |
| 2 | 10 ± 3 秒 |
| 3 | 15 ± 5 秒 |
假定每天的头 3 小时内,零件以每 秒一个的速率由输送带送来。机器 1 在第 1 小时可用,机器 2 在第 2 小时可用,机器 3 在第 3 小时可用。需要多大的存储区来存放等待加工的零件?零件是否会在某个特定时刻「堆积」起来?为什么?
人们以每 30 ± 20 秒一个的速率到达一家自助餐厅。40% 的人去三明治柜台,那里有一名工人用 60 ± 30 秒做一个三明治。其余人去主柜台,那里有一名服务人员用 秒把备好的餐食舀到盘中。所有顾客都须到同一个收银台付款,耗时 秒。对所有顾客而言,用餐需 分钟。餐后,10% 的人回去吃甜点,在餐厅中共额外停留 分钟。仿真直到 100 人离开餐厅。仿真停止时,餐厅里还有多少人,他们在做什么?
三十辆运送 C-5N 货机零配件的卡车同时离开亚特兰大前往萨凡纳港。根据以往经验,已知卡车跑完这一趟需要 小时。40% 的司机会停下来喝咖啡,这需要额外 分钟。(a) 按如下方式建模:对每位司机,都有 40% 的概率停下来喝咖啡。最后一辆卡车何时到达萨凡纳?(b) 建模使得恰好 40% 的司机停下来喝咖啡。最后一辆卡车何时到达萨凡纳?
顾客每 40 ± 35 秒到达 Last National Bank 一次。目前顾客随机选择两名出纳员中的一名。一名出纳员为一位顾客服务需 秒。一旦顾客加入某个队伍,他就一直留在该队伍中,直到业务办完。有些顾客希望银行改用 Lotta Trust Bank 所采用的单一队伍方法。哪种方法对顾客来说更快?先仿真一小时再收集任何汇总统计量,然后仿真一个 8 小时的时段。从出纳员利用率(忙碌时间百分比)、顾客平均延迟、以及必须等待(服务开始之前)超过 1 分钟和超过 3 分钟的顾客所占比例这几个方面,比较这两种排队规则。
Loana Tool Company 出租链锯。顾客以每 30 ± 30 分钟一个的速率到达来租链锯。Dave 与 Betty 处理这些顾客。Dave 出租一把链锯需 14 ± 4 分钟,Betty 需 分钟。归还链锯的顾客与租链锯的顾客服从相同的分布。Dave 与 Betty 花费 2 分钟与顾客一起办理归还链锯的登记。服务按先到先服务进行。当没有顾客在场,或只有 Betty 忙碌时,Dave 就把归还的链锯准备好以便再次出租。对每一把链锯,这项维护与清理分别需要他 分钟和 分钟。每当 Dave 空闲时,他就着手下一项维护或清理。完成一项维护或清理之后,若有一位或更多顾客在等待,Dave 就开始为顾客服务。Betty 随时都可以为顾客服务。仿真该系统的运行:店铺于上午 8:00 从空店开始营业,下午 6:00 关门,并继续把链锯准备好以便再次出租直到下午 7:00。从下午 6:00 到 7:00,Dave 与 Betty 两人都做维护与清理。估计租链锯顾客的平均延迟。
在习题 22 中,修改店铺关于「准备链锯以便再次出租」的维护与清理规则:现在由 Betty 做全部这些工作。完成一把链锯的清理之后,若有队伍在等候,她就帮助 Dave。(也就是说,Dave 与 Betty 都为新顾客服务并办理归还链锯的登记,直到只有 Dave 忙碌,或店铺空闲。)然后她再回到自己的维护与清理工作中。(a) 估计租链锯顾客的平均延迟。以此比较两条店铺规则。(b) 估计必须等待超过 5 分钟的顾客所占比例。以此比较两条店铺规则。(c) 讨论 (a) 与 (b) 两部分中用于比较两条店铺规则的判据的利弊,并提出其他判据。
U of LA(University of Lower Altoona)只有一台供学生使用的彩色打印机。学生每 分钟到达彩色打印机处,使用时间 分钟。若彩色打印机正忙,60% 的人会在 10 分钟后回来再试一次。若彩色打印机仍然忙,则这 60% 中的 50% 会在 15 分钟后回来。与实际完成打印的 500 人相比,有多少学生未能使用彩色打印机?需求与服务全天 24 小时发生。
一座仓库可容纳 1000 立方米的纸箱。这些纸箱有三种尺寸:小(1 立方米)、中(2 立方米)和大(3 立方米)。纸箱的到达速率如下:小箱每 分钟一个,中箱每 15 分钟一个,大箱每 分钟一个。若不移走任何纸箱,用仿真确定填满一座空仓库需要多长时间?
Go Ape! 买了一台 Banana II 计算机来处理其全部的网页浏览需求。上网的员工每 分钟到达一次使用计算机。上网需 分钟。操作这台计算机的猴子每 分钟导致一次系统故障。故障持续 分钟。故障发生时,正在进行的上网作业会从中断处继续处理。对该系统 24 小时的运行情况进行仿真。估计平均系统响应时间。(系统响应时间是从到达直到上网完成所经历的时间长度。)还要估计那些在计算机系统故障发生时正在接受服务的上网员工的平均延迟。
Able、Baker 与 Charlie 是 Sonic Drive-In(以光速服务!)的三名 carhop(小车服务员)。汽车每 分钟到达一辆。carhop 以每 分钟一个的速率为顾客服务。然而顾客更偏爱 Able 而非 Baker,更偏爱 Baker 而非 Charlie。若中意的 carhop 忙碌,顾客就选择第一个空闲的 carhop。对该系统进行仿真,直到完成 1000 次服务。估计 Able、Baker 和 Charlie 的利用率(忙碌时间百分比)。
Jiffy Car Wash 是一道五阶段的作业,每个阶段耗时 2 ± 1 分钟。有 6 个车位可供汽车等待开始洗车。洗车设施可容纳 5 辆汽车,它们按顺序在系统中移动,前面的车不动,后面的车就无法移动。汽车每 分钟到达一辆等待洗车。若汽车无法进入系统,它就穿过街道开到 Speedy Car Wash。估计每小时的中途离去率(balking rate)。也就是说,每小时有多少辆车开走?仿真一个 12 小时的营业日。
工人以每 10 ± 4 分钟一个的速率到达内部供应商店。他们的请领单由三名办事员之一办理;一名办事员处理一张请领单需 分钟。所有请领单随后都交给一名收银员,他每张请领单花费 分钟。对该系统仿真 120 小时。(a) 根据这 120 小时的仿真,估计每名办事员的利用率。(b) 有多少工人被完全服务?三名办事员服务了多少人?共到达了多少工人?三名办事员是否曾经同时忙碌?忙碌办事员的平均人数是多少?
人们以每 4.5 分钟一个的速率到达一家理发店。若店里已满(总共可容纳五人),30% 的潜在顾客离开并在 分钟后回来。其余人离开且不再回来。一名理发师理发需 分钟;第二位很爱讲话,理发需 12 ± 4 分钟。若两名理发师都空闲,顾客偏好第一位理发师。(把试图重新进店的顾客当作新顾客对待。)对该系统进行仿真,直到 300 位顾客理完发。(a) 估计中途离去率,也就是每分钟被劝离的人数。(b) 估计每分钟被劝离且不再回来的人数。(c) 在店内花费的平均时间是多少?(d) 理发本身所花的平均时间是多少(不含延迟)?(e) 店内顾客的平均人数是多少?
人们以每 8 ± 2 分钟一个的速率到达一个显微镜展览。一次只能有一个人参观,参观需 5 ± 2 分钟。一人可以花 $1 购买一张「特权票」(privilege ticket),从而在队伍中优先于那些舍不得花这一块钱的人。约 50% 的参观者愿意这样做,但他们只有在到达时队伍中已有一人或多人时才会作出这一决定。展览从上午 10:00 到下午 4:00 连续开放。对该系统整整一天的运行情况进行仿真。出售特权票共产生多少收入?
有两台机器可供钻孔加工零件(A 型与 B 型)。A 型零件的到达速率为每 分钟一个,B 型零件为每 分钟一个。对于 B 型零件,工人选择一台空闲的机器;若两台钻床(Dewey 与 Truman)都忙碌,则随机选择一台并一直使用它。A 型零件必须尽快钻孔;因此若有机台可用,优先使用 Dewey;若不可用,该零件就排到 Dewey 钻床的队首。所有作业完成需 分钟。对 100 个 A 型零件的完成情况进行仿真。估计等待钻孔的 A 型零件的平均数量。
一个计算中心有两台彩色打印机。学生以每 8 ± 2 分钟一个的速率到达使用彩色打印机。他们可能被打断,打断他们的是教授,教授以每 分钟一个的速率到达。有一名系统分析员可以打断任何人,但学生先于教授被打断。系统分析员使用彩色打印机 分钟,然后隔 分钟回来。教授与学生使用彩色打印机 分钟。若某人被打断,他就排到队首,并尽快恢复服务。对 50 个「教授或分析员」作业进行仿真。估计每小时的打断率,以及学生排队线的平均长度。
零件在钻床上加工。到达速率为每 分钟一个,加工需 分钟。每 分钟会有一个加急作业到达,完成它需 分钟。加急作业会打断任何非加急作业。当常规作业回到机台时,它只保留自己剩余的加工时间。对 10 个加急作业的加工情况进行仿真。估计每类零件的平均系统响应时间。(响应时间是一个零件在系统中所耗费的总时间。)
电子邮件消息以每 秒一个的速率产生,一次传输一条。传输需 秒。每隔 分钟,会有传输时间为 秒的加急电子邮件抢占传输线路。任何正在进行中的电子邮件消息都必须重新处理 2 分钟,才能重新提交传输。重新提交时,它排到队首。仿真 90 分钟。估计线路被普通电子邮件消息占用的时间百分比。
一名工人包装箱子,箱子以每 分钟一个的速率到达。包装一个箱子需 分钟。每小时一次,该工人会中断手头的包装,去包装特制订单,耗时 分钟。完成特制订单后,工人再完成被打断的订单。仿真 40 小时。估计「等待包装的箱子数超过五个」这一状态所占时间的平均比例,以及等待包装的箱子的平均数量。
一位病人以约 分钟的速率到达 Hello Hospital 的急诊室。每位病人将由 Doctor Slipup 或 Doctor Gutcut 之一治疗。20% 的病人被归类为 NIA(需要立即处理),其余为 CW(可以等待)。NIA 病人享有最高优先级(3),尽快见到医生并接受 分钟的治疗,随后其优先级降为 2,他们等待直到有医生空闲,再接受 分钟的进一步治疗,然后出院。CW 病人初始优先级为 1,在轮到他们时接受 分钟的治疗;随后其优先级升为 2,他们再次等待直到有医生空闲,并接受 分钟的最后治疗,然后出院。对连续运行 20 天(每天 24 小时)的系统进行仿真。此前先用 2 天的初始化期来把系统载入病人。报告在 0 天、2 天和 22 天时刻的状态。2 天的初始化期是否足够长,能把系统载入到相当接近稳态的水平?(a) 测量 NIA 病人从到达到首次见到医生这一过程的平均与最大排队长度。有百分之多少完全不必等待?还要列表并绘制 NIA 病人这一初始等待时间的分布。有百分之多少在见到医生之前等待不足 5 分钟?(b) 列表并绘制所有病人在系统中总时间的分布。估计 90% 分位数——也就是说,90% 的病人在系统中停留的时间少于某个量。估计该量。(c) 列表并绘制所有病人从首次治疗结束到出院这段时间在系统中剩余时间的分布。估计 90% 分位数。(注意:大多数仿真软件包都提供了自动列表统计任一指定变量分布的功能。)
人们以均值为 0.5 分钟的指数分布到达间隔时间到达一个报摊。其中 55% 的人只买晨报,25% 的人买晨报加一份《华尔街日报》(Wall Street Journal)。其余的人只买《华尔街日报》。一名售货员负责《华尔街日报》的销售,另一名售货员负责晨报的销售。既买两份的人去找《华尔街日报》的售货员。所有交易的顾客服务时间服从均值为 40 秒、标准差为 4 秒的正态分布。收集各类交易对应队列的统计量。提出使该系统更有效率的办法。仿真 4 小时。
Bernie 改造房屋并加盖房间。完成一项作业所需时间服从均值为 17 个日历日、标准差为 3 天的正态分布。房主签订作业合同的间隔时间服从均值为 20 天的指数分布。Bernie 只有一个班组。估计那些发生等待的作业的平均等待时间(从签订合同到开工)。还要估计班组空闲的时间百分比。仿真直到完成 100 项作业。
零件以随机方式到达一台机器,到达间隔时间服从均值为 60 秒的指数分布。所有零件都需要 5 秒的准备与校准以便加工。零件有三种类型,其比例如下。加工每类零件所需时间服从正态分布,其均值与标准差如下:
| 零件类型 | 百分比 | 均值(秒) | σ(秒) |
|---|---|---|---|
| 1 | 50 | 48 | 8 |
| 2 | 30 | 55 | 9 |
| 3 | 20 | 85 | 12 |
求所有类型零件的加工完成总时间的分布。有多大比例的零件完成加工所需时间超过 60 秒?零件平均需要等待多久?仿真一个 8 小时的班次。
- 经查明,某百货商店的购物时间具有如下分布:
| 购物时间(分钟) | 顾客人数 |
|---|---|
| 0–10 | 90 |
| 10–20 | 120 |
| 20–30 | 270 |
| 30–40 | 145 |
| 40–50 | 88 |
| 50–60 | 28 |
购物之后,顾客从六个收银台中任选一个。结账时间服从均值为 5.1 分钟、标准差为 0.7 分钟的正态分布。到达间隔时间服从均值为 1 分钟的指数分布。为每个收银台收集统计量(包括等待结账的时间)。列表给出完成购物所需时间的分布,以及完成购物与结账全过程所需时间的分布。有多大比例的顾客在商店停留超过 45 分钟?仿真一个 16 小时的营业日。
- 需要加工的零件,其到达间隔时间如下:
| 到达间隔时间(秒) | 比例 |
|---|---|
| 10–20 | 0.20 |
| 20–30 | 0.30 |
| 30–40 | 0.50 |
零件有三种类型:A、B 和 C。各类零件所占比例,以及服从正态分布的加工时间的均值与标准差如下:
| 零件类型 | 比例 | 均值 | 标准差 |
|---|---|---|---|
| A | 0.5 | 30 秒 | 3 秒 |
| B | 0.3 | 40 秒 | 4 秒 |
| C | 0.2 | 50 秒 | 7 秒 |
每台机器一次只能加工一个零件,且可加工任何类型的零件。用仿真比较一台机器与两台机器并行工作,以及两台机器与三台机器并行工作。对于这样的比较,采用什么判据才合适?
- 订单分为四类零件之一下达。订单之间的到达间隔时间服从均值为 10 分钟的指数分布。下表给出各类零件所占比例,以及由唯一一名办事员完成各类订单所需的时间。
| 零件类型 | 百分比 | 服务时间(分钟) |
|---|---|---|
| A | 40 | N(6.1, 1.3) |
| B | 30 | N(9.1, 2.9) |
| C | 20 | N(11.8, 4.1) |
| D | 10 | N(15.1, 4.5) |
A 类与 B 类订单一填好就被取走,而 C 类与 D 类订单必须等 分钟才能取走。列表给出所有订单合并后的完成交付时间分布。有多大比例的时间少于 15 分钟?多大比例少于 25 分钟?先仿真一个 8 小时的初始化期,随后运行 40 小时。8 小时初始化期内收集到的数据不得使用。
三台独立生产小装置(widget)的机器都需要同一种关键零件,该零件需要频繁维护。为了提高产量,决定手头保留两个备用零件(总数为 个零件)。一个零件使用 2 小时后被从机器上拆下,送往一名技术员处,他完成所需维护需 分钟。维护之后,零件被放入备用零件池,供最先需要它的机器使用。这名技术员还有其他职责,即修理其他优先级更高的物件,这些物件每 分钟到达一次,修理需 分钟。此外,技术员在每个 2 小时时段中休息 15 分钟。也就是说,技术员工作 1 小时 45 分钟,休息 15 分钟,再工作 1 小时 45 分钟,休息 15 分钟,如此往复。(a) 该模型的初始条件是什么——也就是说,时刻 0 零件在何处、其状况如何?这些条件是否具有「稳态」的代表性?(b) 令本实验的每次重复实验都由 8 小时的初始化阶段加上 40 小时的数据收集阶段构成。在一次计算机运行中完成本实验的四次统计上独立的重复实验(即做四次运行,每次使用一组不同的随机数)。(c) 估计忙碌机器的平均数量以及技术员忙碌的时间比例。(d) 据估计,每个零件每个 8 小时工作日使公司付出 $50 的成本(无论其实际使用程度如何)。技术员的成本为每小时 $20。一台运转中的机器每小时生产价值 $100 的小装置。推导一个表达式,表示可归属于小装置生产的每小时总成本(也就是说,技术员的时间并非全部用于小装置生产)。根据仿真结果求值该表达式。
Wee Willy Widget Shop 对所有类型的小装置进行翻修与修理。店铺由五个工作站组成,作业在店内的流动如下图所示:
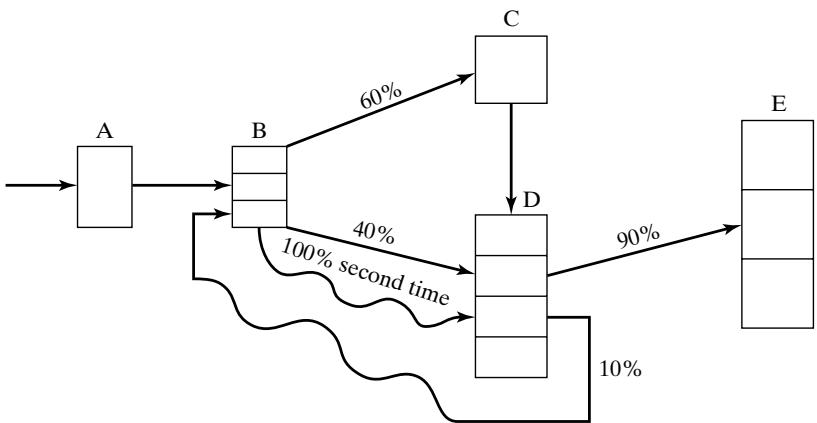
习题 45 图 1 Wee Willy Widget Shop 中作业的流动。
常规作业以每 分钟一个的速率到达 A 站。加急作业每 小时到达一次,并享有更高优先级,但在 C 站例外:在那里它们被放上传送带,与其他所有作业一起送去进行清洗与脱脂作业。作业第一次通过某个工作站时,其加工与修理时间如下:
| 工作站 | 机器或工人数量 | 加工和/或修理时间(分钟) | 说明 |
|---|---|---|---|
| A | 1 | 收货职员 | |
| B | 3 | 拆卸与零件更换 | |
| C | 1 | 20 | 脱脂机 |
| D | 4 | 重新装配与调整 | |
| E | 3 | 包装与发运 |
上表所列时间适用于所有遵循两条路径之一的作业:A B C D E 或 A B D E。然而,从 D 站出来的作业中约有 10% 被退回 B 站作进一步加工(耗时 分钟),然后再送到 D 站,最后送到 E 站。这些作业的路径如下:
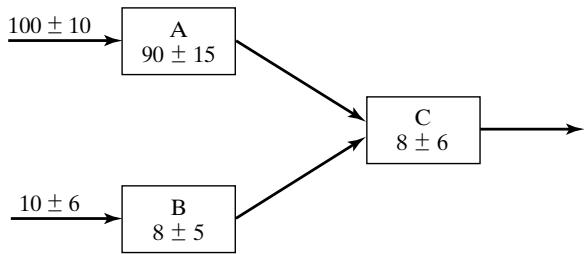
习题 45 图 2 退回作业的路径。
每 2 小时一次(从开店后 1 小时开始),脱脂站 C 停机进行例行维护,需 10 ± 1 分钟。不过,这项例行维护要等到当前的工件(若有)完成加工之后才开始。(a) 对该仿真模型作三次统计上独立的重复实验,每次重复实验等于一次 8 小时的仿真运行,之前先作一次 2 小时的初始化运行。这三组输出代表三个典型的日子。主要感兴趣的性能度量是每项作业的平均响应时间,其中响应时间是一项作业在店内所耗费的总时间。上午店里从来不会空,但若不作初始化阶段,模型将是空的。因此,运行模型 2 小时的初始化期,并从 2 小时时刻到 10 小时时刻收集统计量。这段「预热」期会减小平均响应时间估计中的向下偏差。请注意,2 小时的预热是一种手段,用以把仿真模型载入某个比「空」更贴近现实的水平。从三次统计上独立的重复实验中分别得到平均响应时间的一个估计值。同时还要得到一个总体估计,即这三个估计值的样本平均值。
(b) 管理层正在考虑在最忙碌的工作站(A、B、D 或 E)增配一名工人。这会显著改善平均响应时间吗?(c) 作为 (b) 的替代方案,管理层正在考虑用一台只需 14 分钟就能加工一个工件的更快机器替换 C 站机器。这会显著改善平均响应时间吗?
一家建材公司用两台装载机拖拉机为卡车装货。已查明卡车装载时间的分布为指数分布,平均装载时间为 6 分钟。卡车的到达间隔时间服从指数分布,到达速率为每小时 16 辆。一辆卡车及其司机的等待时间估计成本为每小时 $50。如果安装一套高架料斗系统,能以恒定的 2 分钟装满任何一辆卡车,那么该公司每个 10 小时工作日(若确有节省)能节省多少?(假定现有的拖拉机能够并且会充分地为料斗装料的输送机服务。)
一个铣床车间有 10 台机器。机器发生故障前的运行时间服从均值为 20 小时的指数分布。修理时间在 3 至 7 小时之间均匀分布。选择适当的运行长度与适当的初始条件。(a) 需要多少名修理人员,才能保证运行中的机器平均数量大于 8 台?(b) 若有两名修理人员,估计处于运行状态或正在被维修的机器数量。
40 个人要通过一个闸机,通过需 秒。对该系统进行 10 次彼此独立的仿真,确定 40 个人全部通过所花时间的范围与平均值。
人们从当地图书馆借阅《乱世佳人》(Gone with the Wind),借期为 天。图书馆中只有该书的一本副本。你是预约名单上的第六个人(前有五人)。仿真 50 个独立的借阅周期,确定你在 100 天内拿到这本书的概率。
作业每 秒到达一个由四道工序组成的流程:OP10 需 秒,OP20 需 秒,OP30 需 秒,OP40 需 秒。对该流程进行仿真直到完成 250 项作业;然后把作业的四道工序合并为一道,其分布为 秒,再用这一分布仿真该流程。这两种方案下,作业在系统中的平均时间是否发生变化?
两类作业到达同一台机器上进行加工。1 类作业每 秒到达,加工需 秒。2 类作业每 秒到达,加工需 秒。在 8 小时的仿真中,等待加工的作业平均有多少个?
两类作业到达同一台机器上进行加工。1 类作业每 秒到达,加工需 35 ± 20 秒。2 类作业每 秒到达,加工需 20 ± 15 秒。工程部门判断该机台有富余产能。对于该系统 8 小时运行的仿真,求 3 类作业的 X 值:3 类作业每 秒到达,在机台上占用 30 秒,使得等待加工的作业平均数不超过两个。
使用电子表格软件,生成 1000 个均值为 10、离散度为 2 的均匀分布随机值。以 0.5 为区间宽度,在 8 与 12 之间绘制这些值的直方图。所生成的这组值与各区间内的期望数量接近程度如何?
使用电子表格,生成 1000 个均值为 10 的指数分布随机值。所生成这些值的最大值是多少?所生成的值中小于均值 10 的比例是多少?绘制这些值的直方图。[提示:若在你所用的电子表格中找不到指数分布生成器,可使用公式 , 其中 R 是 0 到 1 之间均匀分布的随机数,LOG 是自然对数。]
互联网上有许多「群鸟」(boids)仿真。在互联网上查找两个群鸟仿真的例子。对每一个例子,找出每个群鸟所遵循规则的描述。比较并对照这两组规则。至少要回答下列关于每个模型的问题。(a) 群鸟是在二维还是三维空间中飞行?它们飞行的世界是有边界的还是无边界的?[提示:它们在边缘或墙处转向吗?还是从另一侧重新出现?若是后者,这意味着两个看似边界的地方被粘合在一起,实际上根本不是边界。]描述群鸟飞行所处的世界或宇宙。(b) 该模型是否有用户可调的参数?这些参数可能包括群鸟的数量、接近因子(一个群鸟必须靠近其他群鸟到何种程度才会受其行为影响)、速度等等。列出所有这类参数。(c) 群集行为需要多长时间才会涌现出来?
www.bcnn.net 上提供的资料清单
基于程序设计语言的仿真的基类