5 仿真中的统计模型在对现实世界现象建模时,很少有情形能够完全预测所研究系统中实体的行为。建模者所看到的世界是概率性的,而不是确定性的。变异的来源有很多。修理人员修复一台故障机器所需的时间,取决于故障的复杂程度、修理人员是否带了合适的替换零件和工具到现场、修理过程中是否有另一位修理人员请求协助、机器操作员是否接受了预防性维护的培训,等等。对建模者而言,这些变异似乎是由偶然因素造成的,无法预测。然而,某个统计模型很可能恰当地描述完成一次修理所需的时间。
通过抽样调查所关注的现象,可以建立适当的模型。随后,建模者凭经验作出合理猜测(或使用专门的软件),选择一个已知的分布形式,对该分布的参数作出估计,再检验所获得的拟合效果究竟如何。通过在选择合适分布形式上的持续努力,所假设的模型可以被接受。
第 1 节回顾概率术语与概念。第 2 节给出统计模型(即分布形式)的一些典型应用。第 3 节和第 4 节讨论若干选定的离散分布和连续分布。所选定的分布是那些能够描述多种多样概率事件的分布。关于本章出现的分布形式,以及提及但未作描述的分布形式,可参阅许多文献 [Devore, 1999; Hines and Montgomery, 1990; Law and Kelton, 2000; Papoulis, 1990; Ross, 2002; Walpole and Myers, 2002]。第 5 节描述泊松过程及其与指数分布的关系。第 6 节讨论经验分布。
1 术语与概念回顾 1.1 离散随机变量 设 X 为随机变量。如果 X 的可能取值个数是有限的,或为可数无穷的,则称 X 为离散随机变量。X 的可能取值可以列为 x 1 , x 2 , … x_{1} , x_{2} , \ldots x 1 , x 2 , …
例 1 观测某作业车间每周到达的作业数。所关注的随机变量是 X,其中
X = number of jobs arriving each week
X = \text{number of jobs arriving each week}
X = number of jobs arriving each week X 的可能取值由 X 的值域给出,记作 R X R_{X} R X R X = { 0 , 1 , 2 , … } . R_{X} = \{0 , 1 , 2 , \dots \} . R X = { 0 , 1 , 2 , … } . R X R_{X} R X x i x_{i} x i p ( x i ) = P ( X = x i ) p ( x_{i} ) = P ( X \ = \ x_{i} ) p ( x i ) = P ( X = x i ) p ( x i ) , i = 1 , 2 , . . . , p ( x_{i} ) , i = 1 , 2 , . . . , p ( x i ) , i = 1 , 2 , ... ,
a. p ( x i ) ≥ 0 p ( x_{i} ) \geq 0 p ( x i ) ≥ 0
b. ∑ i = 1 ∞ p ( x i ) = 1 \sum_{i = 1} ^ {\infty} p (x_{i}) = 1 ∑ i = 1 ∞ p ( x i ) = 1
数对 ( x i , p ( x i ) ) , i = 1 , 2 , . . . ( x_{i} , p ( x_{i} ) ) , i = 1 , 2 , . . . ( x i , p ( x i )) , i = 1 , 2 , ... p ( x i ) p ( x_{i} ) p ( x i )
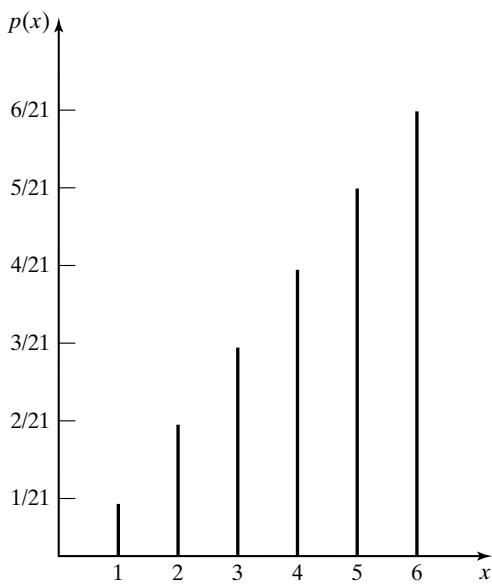
例 2 考虑掷一颗骰子的试验。定义 X 为骰子掷出后朝上那一面上的点数。于是 R X = { 1 , 2 , 3 , 4 , 5 , 6 } R_{X} = \{1 , 2 , 3 , 4 , 5 , 6 \} R X = { 1 , 2 , 3 , 4 , 5 , 6 }
前面所陈述的条件得到了满足——也就是说,对 i = 1 , 2 , … , 6 i = 1 , 2 , \dots , 6 i = 1 , 2 , … , 6 p ( x i ) ≥ 0 p ( x_{i} ) \geq 0 p ( x i ) ≥ 0 ∑ i = 1 ∞ p ( x i ) = 1 / 21 + ⋅ ⋅ ⋅ + 6 / 21 = 1 \textstyle \sum_{i = 1} ^ {\infty} p ( x_{i} ) = 1 / 21 + \cdot \cdot \cdot + 6 / 21 = 1 ∑ i = 1 ∞ p ( x i ) = 1/21 + ⋅ ⋅ ⋅ + 6/21 = 1
图 1 灌铅骰子示例的概率质量函数。
1.2 连续随机变量 如果随机变量 X 的值域 R X R_{X} R X
P ( a ≤ X ≤ b ) = ∫ a b f ( x ) d x (1)
P (a \leq X \leq b) = \int_{a} ^ {b} f (x) d x\tag{1}
P ( a ≤ X ≤ b ) = ∫ a b f ( x ) d x ( 1 ) 函数 f ( x ) f ( x ) f ( x )
a. 对 R X R_{X} R X f ( x ) ≥ 0 f ( x ) \geq 0 f ( x ) ≥ 0
b. ∫ R X f ( x ) d x = 1 \textstyle \int _ {R_{X}} f ( x ) d x = 1 ∫ R X f ( x ) d x = 1
c. 若 x 不在 R X R_{X} R X f ( x ) = 0 f ( x ) = 0 f ( x ) = 0
由式 (1) 可知,对于任何给定的值 x 0 , P ( X = x 0 ) = 0 x_{0} , P ( X = x_{0} ) = 0 x 0 , P ( X = x 0 ) = 0
∫ x 0 x 0 f ( x ) d x = 0
\int_ {x_{0}} ^ {x_{0}} f (x) d x = 0
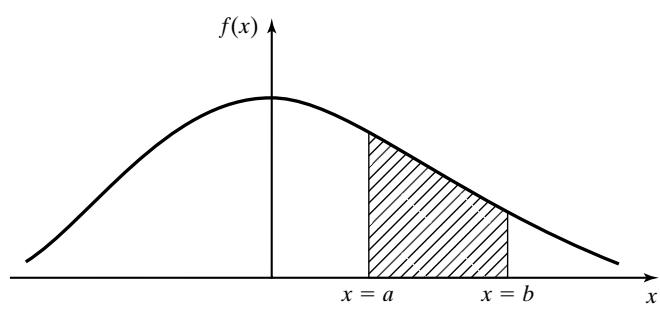
∫ x 0 x 0 f ( x ) d x = 0 图 2 P ( a < X < b ) P ( a < X < b ) P ( a < X < b )
P ( X = x 0 ) = 0 P ( X = x_{0} ) = 0 P ( X = x 0 ) = 0
P ( a ≤ X ≤ b ) = P ( a < X ≤ b ) = P ( a ≤ X < b ) = P ( a < X < b ) (2)
P (a \leq X \leq b) = P (a < X \leq b) = P (a \leq X < b) = P (a < X < b)\tag{2}
P ( a ≤ X ≤ b ) = P ( a < X ≤ b ) = P ( a ≤ X < b ) = P ( a < X < b ) ( 2 ) 式 (1) 的图解解释见图 2。阴影部分表示 X 落在区间 [a, b] 内的概率。
例 3 某台用于检查飞机机翼裂纹的设备,其寿命由 X 给出,X 是一个连续随机变量,取遍 x ≥ 0 x \geq 0 x ≥ 0
f ( x ) = { 1 2 e − x / 2 , x ≥ 0 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {1}{2} e^{- x / 2}, & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.
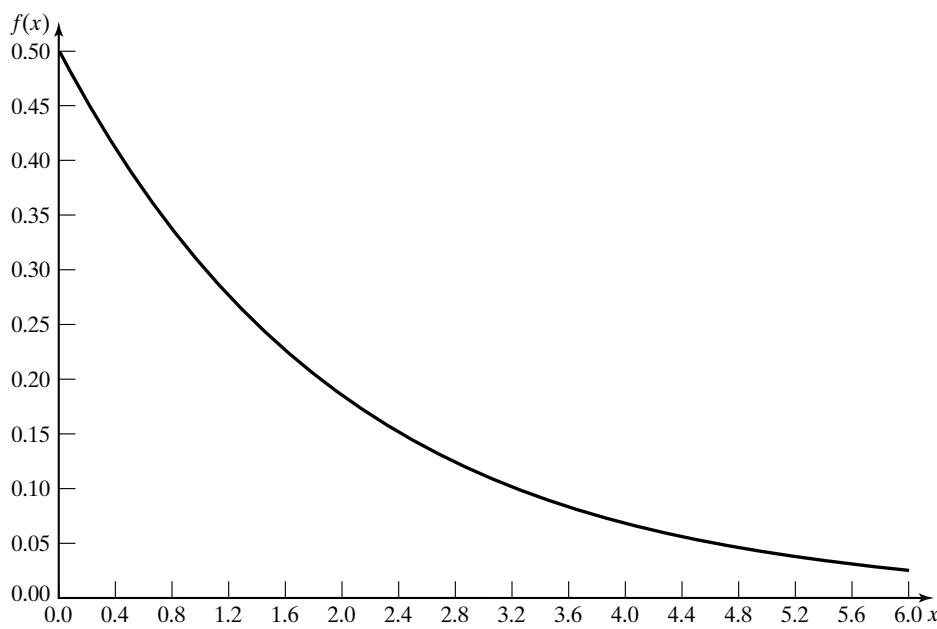
f ( x ) = { 2 1 e − x /2 , 0 , x ≥ 0 otherwise 该 pdf 的图形表示见图 3。称随机变量 X 服从均值为 2 年的指数分布。
设备寿命在 2 年到 3 年之间的概率计算如下
P ( 2 ≤ X ≤ 3 ) = 1 2 ∫ 2 3 e − x / 2 d x = − e − 3 / 2 + e − 1 = − 0.223 + 0.368 = 0.145
\begin{array}{r l} P (2 \leq X \leq 3) & = \frac {1}{2} \int_{2} ^ {3} e^{- x / 2} d x \\ & = - e^{- 3 / 2} + e^{- 1} \\ & = - 0. 223 + 0. 368 \\ & = 0. 145 \end{array}
P ( 2 ≤ X ≤ 3 ) = 2 1 ∫ 2 3 e − x /2 d x = − e − 3/2 + e − 1 = − 0.223 + 0.368 = 0.145 图 3 检测设备寿命的 pdf。
1.3 累积分布函数 累积分布函数(cdf)记作 F ( x ) F ( x ) F ( x ) F ( x ) = P ( X ≤ x ) F ( x ) = P ( X \leq x ) F ( x ) = P ( X ≤ x )
如果 X 是离散的,则
F ( x ) = ∑ all x i ≤ x p ( x i ) (3)
F(x) = \sum_{\substack{\text{all}\\ x_{i}\leq x}}p(x_{i})\tag{3}
F ( x ) = all x i ≤ x ∑ p ( x i ) ( 3 ) 如果 X 是连续的,则
F ( x ) = ∫ − ∞ x f ( t ) d t (4)
F (x) = \int_{- \infty} ^ {x} f (t) d t\tag{4}
F ( x ) = ∫ − ∞ x f ( t ) d t ( 4 ) cdf 具有以下一些性质:
a. F 是非减函数。如果 a < b a < b a < b F ( a ) ≤ F ( b ) F ( a ) \leq F ( b ) F ( a ) ≤ F ( b )
b. lim x ⟶ ∞ F ( x ) = 1 \lim _ {x \longrightarrow \infty} F ( x ) = 1 lim x ⟶ ∞ F ( x ) = 1
c. lim x ⟶ − ∞ F ( x ) = 0 \lim _ {x \longrightarrow - \infty} F ( x ) = 0 lim x ⟶ − ∞ F ( x ) = 0
关于 X 的所有概率问题都可以用 cdf 来回答。例如,
P ( a < X ≤ b ) = F ( b ) − F ( a ) f o r a l l a < b (5)
P (a < X \leq b) = F (b) - F (a) \quad \mathrm{forall} a < b\tag{5}
P ( a < X ≤ b ) = F ( b ) − F ( a ) forall a < b ( 5 ) 对于连续分布,不仅式 (5) 成立,而且式 (2) 中的各概率也都等于 F ( b ) − F ( a ) F ( b ) - F ( a ) F ( b ) − F ( a )
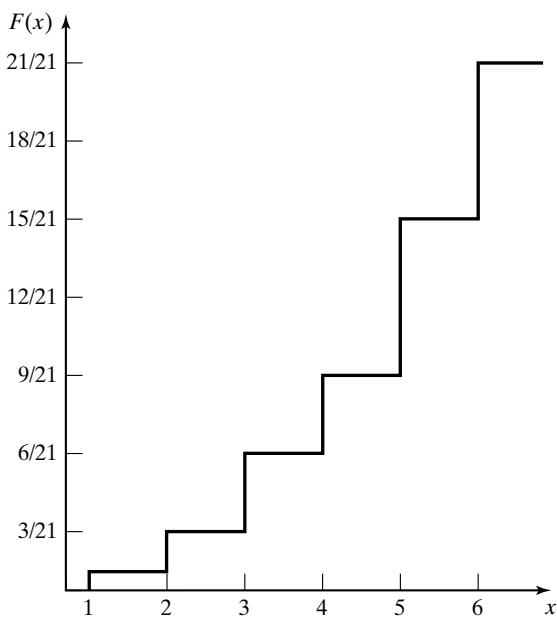
例 4 例 2 中所描述的掷骰子试验,其 cdf 如下:
其中 [a, b ) = { a ≤ x < b } b ) = \{a \leq x < b \} b ) = { a ≤ x < b }
如果 X 是离散随机变量,其可能取值为 x 1 , x 2 , … , x_{1} , x_{2} , \dotsc , x 1 , x 2 , … , x 1 < x 2 < . . . . x_{1} < x_{2} < . . . . x 1 < x 2 < .... [ x i − 1 , x i ) [ x_{i - 1} , x_{i} ) [ x i − 1 , x i ) x i x_{i} x i p ( x i ) p ( x_{i} ) p ( x i ) p ( 3 ) = 3 / 21 p ( 3 ) = 3 / 21 p ( 3 ) = 3/21 x = 3 x = 3 x = 3
图 4 灌铅骰子示例的 cdf。
例 5 例 3 中所描述设备的 cdf 为
F ( x ) = 1 2 ∫ 0 x e − t / 2 d t = 1 − e − x / 2
F (x) = \frac {1}{2} \int_{0} ^ {x} e^{- t / 2} d t = 1 - e^{- x / 2}
F ( x ) = 2 1 ∫ 0 x e − t /2 d t = 1 − e − x /2 设备寿命短于 2 年的概率为
P ( 0 ≤ X ≤ 2 ) = F ( 2 ) − F ( 0 ) = F ( 2 ) = 1 − e − 1 = 0.632
P (0 \leq X \leq 2) = F (2) - F (0) = F (2) = 1 - e^{- 1} = 0. 632
P ( 0 ≤ X ≤ 2 ) = F ( 2 ) − F ( 0 ) = F ( 2 ) = 1 − e − 1 = 0.632 设备寿命在 2 年到 3 年之间的概率计算如下
P ( 2 ≤ X ≤ 3 ) = F ( 3 ) − F ( 2 ) = ( 1 − e − 3 / 2 ) − ( 1 − e − 1 ) = − e − 3 / 2 + e − 1 = − 0.223 + 0.368 = 0.145
\begin{array}{c} P (2 \leq X \leq 3) = F (3) - F (2) = (1 - e^{- 3 / 2}) - (1 - e^{- 1}) \\ = - e^{- 3 / 2} + e^{- 1} = - 0. 223 + 0. 368 = 0. 145 \end{array}
P ( 2 ≤ X ≤ 3 ) = F ( 3 ) − F ( 2 ) = ( 1 − e − 3/2 ) − ( 1 − e − 1 ) = − e − 3/2 + e − 1 = − 0.223 + 0.368 = 0.145 与例 3 中所得结果相同。
1.4 期望 概率论中的一个重要概念是随机变量的期望。若 X 是随机变量,记作 E ( X ) E ( X ) E ( X )
E ( X ) = ∑ all i x i p ( x i ) if X is discrete (6)
E (X) = \sum_ {\text{all} i} x_{i} p (x_{i}) \quad \text{if} X \text{is discrete}\tag{6}
E ( X ) = all i ∑ x i p ( x i ) if X is discrete ( 6 ) 以及
E ( X ) = ∫ − ∞ ∞ x f ( x ) d x if X is continuous (7)
E (X) = \int_{- \infty} ^ {\infty} x f (x) d x \quad \text{if} X \text{is continuous}\tag{7}
E ( X ) = ∫ − ∞ ∞ x f ( x ) d x if X is continuous ( 7 ) 随机变量 X 的期望值 E(X) 也称为均值(mean)μ . \mu . μ . E ( X n ) , n ≥ 1 E ( X^{n} ) , n \geq 1 E ( X n ) , n ≥ 1
E ( X n ) = ∑ all i x i n p ( x i ) if X is discrete (8)
E (X^{n}) = \sum_ {\text{all} i} x_{i} ^ {n} p (x_{i}) \quad \text{if} X \text{is discrete}\tag{8}
E ( X n ) = all i ∑ x i n p ( x i ) if X is discrete ( 8 ) 以及
E ( X n ) = ∫ − ∞ ∞ x n f ( x ) d x if X is continuous (9)
E (X^{n}) = \int_{- \infty} ^ {\infty} x^{n} f (x) d x \quad \text{if} X \text{is continuous}\tag{9}
E ( X n ) = ∫ − ∞ ∞ x n f ( x ) d x if X is continuous ( 9 ) 记作 V(X) 或 var(X) 或 σ 2 \sigma^{2} σ 2
V ( X ) = E [ ( X − E [ X ] ) 2 ]
V (X) = E [ (X - E [ X ]) ^ {2} ]
V ( X ) = E [( X − E [ X ] ) 2 ] 计算 V(X) 时一个有用的恒等式为
V ( X ) = E ( X 2 ) − [ E ( X ) ] 2 (10)
V (X) = E (X^{2}) - [ E (X) ] ^ {2}\tag{10}
V ( X ) = E ( X 2 ) − [ E ( X ) ] 2 ( 10 ) 均值 E ( X ) E ( X ) E ( X ) V ( X ) V ( X ) V ( X ) E ( X ) E ( X ) E ( X ) σ 2 \sigma^{2} σ 2 E ( X ) E ( X ) E ( X ) σ = V ( X ) \sigma = \sqrt {V ( X )} σ = V ( X )
例 6 例 2 中所描述的掷骰子试验,其均值和方差计算如下:
E ( X ) = 1 ( 1 21 ) + 2 ( 2 21 ) + ⋯ + 6 ( 6 21 ) = 91 21 = 4.33
E (X) = 1 \left(\frac {1}{21}\right) + 2 \left(\frac {2}{21}\right) + \dots + 6 \left(\frac {6}{21}\right) = \frac {91}{21} = 4. 33
E ( X ) = 1 ( 21 1 ) + 2 ( 21 2 ) + ⋯ + 6 ( 21 6 ) = 21 91 = 4.33 要用式 (10) 计算 V ( X ) V ( X ) V ( X ) E ( X 2 ) E ( X^{2} ) E ( X 2 )
E ( X 2 ) = 1 2 ( 1 21 ) + 2 2 ( 2 21 ) + ⋯ + 6 2 ( 6 21 ) = 21
E \left(X^{2}\right) = 1^{2} \left(\frac {1}{21}\right) + 2^{2} \left(\frac {2}{21}\right) + \dots + 6^{2} \left(\frac {6}{21}\right) = 21
E ( X 2 ) = 1 2 ( 21 1 ) + 2 2 ( 21 2 ) + ⋯ + 6 2 ( 21 6 ) = 21 因此,
V ( X ) = 21 − ( 91 21 ) 2 = 21 − 18.78 = 2.22
V (X) = 21 - \left(\frac {91}{21}\right) ^ {2} = 21 - 18. 78 = 2. 22
V ( X ) = 21 − ( 21 91 ) 2 = 21 − 18.78 = 2.22 以及
σ = V ( X ) = 1.49
\sigma = \sqrt {V (X)} = 1. 49
σ = V ( X ) = 1.49 例 7 例 3 中所描述设备的寿命,其均值和方差计算如下:
E ( X ) = 1 2 ∫ 0 ∞ x e − x / 2 d x = − x e − x / 2 ∣ 0 ∞ + ∫ 0 ∞ e − x / 2 d x = 0 + 1 1 / 2 e − x / 2 ∣ 0 ∞ = 2 years
\begin{array}{l} E (X) = \frac {1}{2} \int_{0} ^ {\infty} x e^{- x / 2} d x = - x e^{- x / 2} \Big | _ {0} ^ {\infty} + \int_{0} ^ {\infty} e^{- x / 2} d x \\ = 0 + \frac {1}{1 / 2} e^{- x / 2} \Big | _ {0} ^ {\infty} = 2 \text{years} \end{array}
E ( X ) = 2 1 ∫ 0 ∞ x e − x /2 d x = − x e − x /2 0 ∞ + ∫ 0 ∞ e − x /2 d x = 0 + 1/2 1 e − x /2 0 ∞ = 2 years 要用式 (10) 计算 V ( X ) V ( X ) V ( X ) E ( X 2 ) E ( X^{2} ) E ( X 2 )
E ( X 2 ) = 1 2 ∫ 0 ∞ x 2 e − x / 2 d x
E (X^{2}) = \frac {1}{2} \int_{0} ^ {\infty} x^{2} e^{- x / 2} d x
E ( X 2 ) = 2 1 ∫ 0 ∞ x 2 e − x /2 d x 因此,
E ( X 2 ) = − x 2 e − x / 2 ∣ 0 ∞ + 2 ∫ 0 ∞ x e − x / 2 d x = 8
E (X^{2}) = - x^{2} e^{- x / 2} \big | _ {0} ^ {\infty} + 2 \int_{0} ^ {\infty} x e^{- x / 2} d x = 8
E ( X 2 ) = − x 2 e − x /2 0 ∞ + 2 ∫ 0 ∞ x e − x /2 d x = 8 从而
V ( X ) = 8 − 2 2 = 4 y e a r s
V (X) = 8 - 2^{2} = 4 \mathrm{years}
V ( X ) = 8 − 2 2 = 4 years 以及
σ = V ( X ) = 2 y e a r s
\sigma = \sqrt {V (X)} = 2 \mathrm{years}
σ = V ( X ) = 2 years 平均寿命为 2 年、标准差为 2 年,大多数分析人员会得出结论:实际寿命 X 具有相当大的变异性。
1.5 众数 众数用于描述本章中出现的若干统计模型。在离散情形下,众数是出现最频繁的随机变量取值。在连续情形下,众数是 pdf 取最大值的那个取值。众数可能不唯一;如果众数取值出现在随机变量的两个取值上,则称该分布是双峰的(bimodal)。
2 常用统计模型 在仿真的实施过程中会出现许多这样的情形:研究人员可能选择引入概率性事件。在排队系统中,到达间隔时间和服务时间常常是概率性的。在库存模型中,需求之间的间隔时间以及提前期(从下单到收到货物之间的时间)都可能是概率性的。在可靠性模型中,故障时间也可能是概率性的。在上述每一种情形下,仿真分析人员都希望生成随机事件,并且如果能够找到潜在的分布,就使用一个已知的统计模型。在下面几段中,将讨论适合这些应用领域的统计模型。此外,还将提及在数据有限的情形下有用的统计模型。
2.1 排队系统 在排队示例中,到达间隔时间模式和服务时间模式,即到达之间的时间和服务时间,常常是概率性的。不过,也可能有恒定的到达间隔时间(例如汽车装配线上以恒定速度移动的生产线),或者恒定的服务时间(例如同一条装配线上的机器人点焊)。下面的例子说明概率性的到达间隔时间可能如何产生。
例 8 如表 1 所示,机械师陆续到达一个集中的工具室。工具室的管理员为机械师办理所请求工具的领用与归还。数据采集从上午 10:00 开始,直到记录到 20 个不同的到达间隔时间为止。与其记录每日的实际时刻,也可以从某个给定的原点计算绝对时间。于是,第一位机械师可能在时刻 0 , 0 , 0 ,
表 1 机械师的到达数据
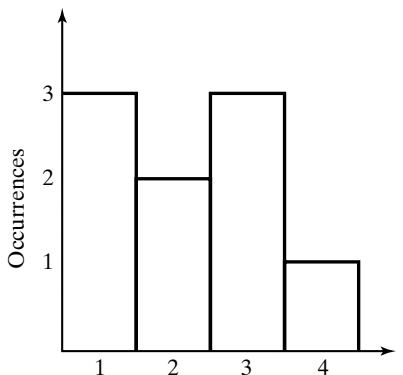
例 9 呈现到达间隔数据的另一种方式,是求出每个时段内的到达数。这里,此类到达发生在大约 1.5 小时之内;把前 20 位机械师按 10 分钟的时间间隔来考察是方便的。也就是说,在第一个 10 分钟时段内有 1 次到达,发生在 10:05::03。在第二个时段内有 2 位机械师到达,依此类推。结果汇总于表 2。这批数据随后可以绘制成直方图,如图 5 所示。
表 2 各连续时段内的到达数
到达之间时间的分布,以及每个时段内到达数的分布,在排队线系统的仿真中都是重要的。“到达"有多种多样的形式:机器故障、进入作业车间的作业、装配线上组装的单元、发往仓库的订单、到达计算机系统的数据包、打到呼叫中心的电话,等等。
服务时间可以是恒定的,也可以是概率性的。如果服务时间完全随机,为仿真目的通常采用指数分布;不过还存在若干其他可能。服务时间也可能是恒定的,但某种随机波动会以正向或负向的方式引起起伏。例如,车床走完一根 10 厘米轴所需的时间本应总是相同的。然而,材料的硬度可能略有差异,刀具也可能磨损;这两种情况中的任何一种都可能导致不同的加工时间。在这些情况下,正态分布也许能描述服务时间。
当所关注的现象似乎服从正态概率分布、但随机变量却被限制为大于或小于某个特定值时,会出现一种特殊情形。在这种情形下,可以采用截断正态分布。
伽马分布和 Weibull 分布也被用于对到达间隔时间和服务时间建模。(实际上,指数分布是伽马分布和 Weibull 分布二者的特例。)指数分布、伽马分布和 Weibull 分布之间的差别,涉及 pdf 众数的位置,以及它们在时间很大和很小时尾部的形状。指数分布的众数位于原点,而伽马分布和 Weibull 分布的众数位于某一点 ( ≥ 0 ) ( \geq 0 ) ( ≥ 0 )
图 5 各时段到达数的直方图(横轴:10 分钟时段内的到达数)。
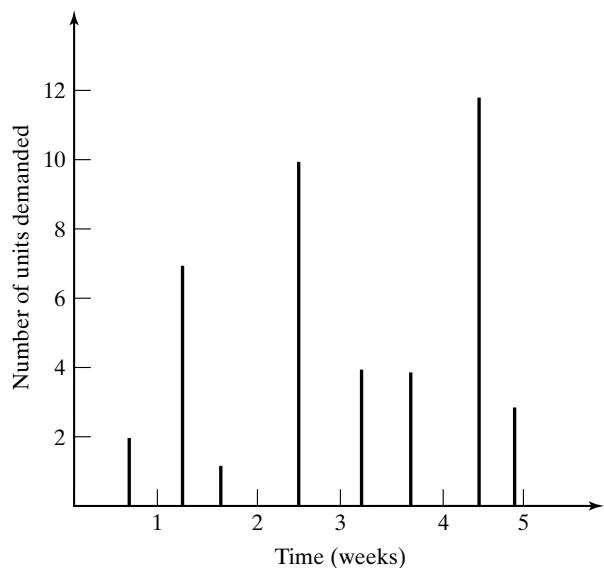
2.2 库存与供应链系统 在现实的库存和供应链系统中,至少存在三个随机变量:(1) 每笔订单或每个时段的需求件数,(2) 两次需求之间的间隔时间,(3) 提前期。(提前期定义为:为补充库存系统而下达订单的时刻与收到该订单的时刻之间的时间。)在非常简单的库存系统数学模型中,需求随时间保持恒定,而提前期为 0 或某个常数。然而,在大多数现实情形中,因而也在仿真模型中,需求在时间上是随机发生的,而且每次需求发生时的需求件数也是随机的,如图 6 所示。
库存理论教材中关于需求和提前期的分布假设,通常是基于数学上的可处理性,但在现实背景下这些假设可能并不成立。在实践中,提前期分布往往可以由伽马分布较好地拟合 [Hadley and Whitin, 1963]。与解析模型不同,仿真模型可以容纳任何看起来最合理的假设。
几何分布、泊松分布和负二项分布提供了能够满足各种需求模式的多种分布形状。几何分布是负二项分布的一个特例,在至少发生过一次需求的前提下,其众数位于 1。如果需求数据以长尾为特征,负二项分布可能是合适的。泊松分布常用于对需求建模,因为它简单、有详尽的表格数据、而且人们非常熟悉。泊松分布的尾部一般比负二项分布的尾部短,这意味着在两种模型具有相同平均需求的前提下,采用泊松模型时出现的大额需求要比采用负二项分布时少。
图 6 随机需求随时间的变化。
2.3 可靠性与可维护性 故障时间已用许多分布来建模,包括指数分布、伽马分布和 Weibull 分布。如果只发生随机故障,故障时间分布可以建模为指数分布。伽马分布源于对备用冗余的建模,其中每个部件的故障时间都服从指数分布。Weibull 分布被广泛用于表示故障时间,其性质使得它可以被调整以逼近许多观察到的现象 [Hines and Montgomery, 1990]。当一个系统中有若干部件,而故障是由于大量缺陷(或潜在缺陷)中最严重的一个所引起时,Weibull 分布似乎特别适合作为模型。在大多数故障源于磨损的情形下,正态分布也许非常合适 [Hines and Montgomery, 1990]。对数正态分布已被发现适用于描述某些类型部件的故障时间。
2.4 数据有限的情形 在许多实例中,仿真在数据收集完成之前就开始了。有三个分布适用于不完整或有限的数据,它们是均匀分布、三角分布和贝塔分布。当已知某个到达间隔时间或服务时间是随机的,但暂时无法获得关于该分布的任何信息时,可以采用均匀分布 [Gordon, 1975]。不过,也有人不赞成使用均匀分布,称它为"最大无知之分布”,因为除了随机变量可能出现的那段连续区间之外,不必再指定任何别的东西。当对随机变量的最小值、最大值和众数作出假设时,可以采用三角分布。最后,贝塔分布在单位区间上提供了多种分布形式,只需适当修改即可将其平移到任意所需的区间。均匀分布是贝塔分布的一个特例。Pegden、Shannon 和 Sadowski [1995] 对有限数据这一主题有较为详细的讨论。
2.5 其他分布 其他若干分布在离散系统仿真中可能是有用的。伯努利分布和二项分布是两种可以描述所关注现象的离散分布。超指数分布与指数分布相似,但它更大的变异性在某些场合可能使之有用。
3 离散分布 离散随机变量用于描述只可能取整数值的随机现象。第 2 节给出了大量例子——例如对库存物品的需求。以下各小节描述四个分布。
3.1 伯努利试验与伯努利分布 考虑一个由 n 次试验构成的试验,每次试验的结果非成功即失败。若第 j 次试验的结果为成功,则令 X j = 1 X_{j} = 1 X j = 1 X j = 0 X_{j} = 0 X j = 0
如果各次试验相互独立、每次试验只有两种可能结果(成功或失败),且成功的概率在试验之间保持不变,则称这 n 次伯努利试验构成一个伯努利过程。于是,
p ( x 1 , x 2 , … , x n ) = p 1 ( x 1 ) ⋅ p 2 ( x 2 ) ⋅ ⋅ ⋅ p n ( x n )
p (x_{1}, x_{2}, \ldots , x_{n}) = p_{1} (x_{1}) \cdot p_{2} (x_{2}) \cdot \cdot \cdot p_{n} (x_{n})
p ( x 1 , x 2 , … , x n ) = p 1 ( x 1 ) ⋅ p 2 ( x 2 ) ⋅ ⋅ ⋅ p n ( x n ) 并且
p j ( x j ) = p ( x j ) = { p , x j = 1 , j = 1 , 2 , … , n 1 − p = q , x j = 0 , j = 1 , 2 , … , n 0 , otherwise (11)
p_{j} (x_{j}) = p (x_{j}) = \left\{\begin{array}{l l} p, & x_{j} = 1, j = 1, 2, \ldots , n \\ 1 - p = q, & x_{j} = 0, j = 1, 2, \ldots , n \\ 0, & \text{otherwise} \end{array} \right.\tag{11}
p j ( x j ) = p ( x j ) = ⎩ ⎨ ⎧ p , 1 − p = q , 0 , x j = 1 , j = 1 , 2 , … , n x j = 0 , j = 1 , 2 , … , n otherwise ( 11 ) 对于单次试验,式 (11) 给出的分布称为伯努利分布。X j X_{j} X j
E ( X j ) = 0 ⋅ q + 1 ⋅ p = p
E (X_{j}) = 0 \cdot q + 1 \cdot p = p
E ( X j ) = 0 ⋅ q + 1 ⋅ p = p 以及
V ( X j ) = [ ( 0 2 ⋅ q ) + ( 1 2 ⋅ p ) ] − p 2 = p ( 1 − p )
V (X_{j}) = [ (0^{2} \cdot q) + (1^{2} \cdot p) ] - p^{2} = p (1 - p)
V ( X j ) = [( 0 2 ⋅ q ) + ( 1 2 ⋅ p )] − p 2 = p ( 1 − p ) 3.2 二项分布 表示 n 次伯努利试验中成功次数的随机变量 X 服从二项分布,其概率质量函数为 p ( x ) p ( x ) p ( x )
p ( x ) = { ( n x ) p x q n − x , x = 0 , 1 , 2 , … , n 0 , otherwise (12)
p (x) = \left\{\begin{array}{l l} \binom {n} {x} p^{x} q^{n - x}, & x = 0, 1, 2, \ldots , n \\ 0, & \text{otherwise} \end{array} \right.\tag{12}
p ( x ) = { ( x n ) p x q n − x , 0 , x = 0 , 1 , 2 , … , n otherwise ( 12 ) 式 (12) 的由来,是通过计算某一种特定结果出现的概率而得到的,即所有成功(各记作 S)出现在前 x 次试验中,随后是 n − x n - x n − x
P ( S S S . … . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . ⏞ x of these F F . … . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . ⏞ n − x of these = p x q n − x
P \overbrace {(S S S . \dots . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .} ^ {x \text{of these}} \overbrace {F F. \dots . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .} ^ {n - x \text{of these}} = p^{x} q^{n - x}
P ( S S S . … ....................................................................... x of these F F . … ....................................................................... n − x of these = p x q n − x 其中 q = 1 − p q = 1 - p q = 1 − p S S S F F F
( n x ) = n ! x ! ( n − x ) !
\binom {n} {x} = \frac {n !}{x ! (n - x) !}
( x n ) = x ! ( n − x )! n ! 种。于是便得到式 (12)。计算二项分布均值和方差的一种简便方法,是把 X 看作 n 个相互独立、各自均值为 p p p p ( 1 − p ) = p q p ( 1 - p ) = p q p ( 1 − p ) = pq
X = X 1 + X 2 + ⋯ + X n
X = X_{1} + X_{2} + \dots + X_{n}
X = X 1 + X 2 + ⋯ + X n 均值 E(X) 为
E ( X ) = p + p + ⋯ + p = n p (13)
E (X) = p + p + \dots + p = n p\tag{13}
E ( X ) = p + p + ⋯ + p = n p ( 13 ) 方差 V(X) 为
V ( X ) = p q + p q + ⋯ + p q = n p q (14)
V (X) = p q + p q + \dots + p q = n p q\tag{14}
V ( X ) = pq + pq + ⋯ + pq = n pq ( 14 ) 例 10 某生产工艺平均制造出 2 % 2 \% 2%
把抽样过程看作 n = 50 n = 50 n = 50 p = 0.02 p = 0.02 p = 0.02
p ( x ) = { ( 50 x ) ( 0.02 ) x ( 0.98 ) 50 − x , x = 0 , 1 , 2 , … , 50 0 , otherwise
p (x) = \left\{\begin{array}{l l} \binom {50} {x} (0. 02) ^ {x} (0. 98) ^ {50 - x}, & x = 0, 1, 2, \ldots , 50 \\ 0, & \text{otherwise} \end{array} \right.
p ( x ) = { ( x 50 ) ( 0.02 ) x ( 0.98 ) 50 − x , 0 , x = 0 , 1 , 2 , … , 50 otherwise 计算样本中发现两片以上不合格芯片的概率,用下面这个恒等式要容易得多:
P ( X > 2 ) = 1 − P ( X ≤ 2 )
P (X > 2) = 1 - P (X \leq 2)
P ( X > 2 ) = 1 − P ( X ≤ 2 ) 概率 P ( X ≤ 2 ) P ( X \leq 2 ) P ( X ≤ 2 )
P ( X ≤ 2 ) = ∑ x = 0 2 ( 50 x ) ( 0.02 ) x ( 0.98 ) 50 − x = ( 0.98 ) 50 + 50 ( 0.02 ) ( 0.98 ) 49 + 1225 ( 0.02 ) 2 ( 0.98 ) 48 ≐ 0.92
\begin{array}{r l} P (X \leq 2) & = \sum_{x = 0} ^ {2} \binom {50} {x} (0. 02) ^ {x} (0. 98) ^ {50 - x} \\ & = (0. 98) ^ {50} + 50 (0. 02) (0. 98) ^ {49} + 1225 (0. 02) ^ {2} (0. 98) ^ {48} \\ & \doteq 0. 92 \end{array}
P ( X ≤ 2 ) = ∑ x = 0 2 ( x 50 ) ( 0.02 ) x ( 0.98 ) 50 − x = ( 0.98 ) 50 + 50 ( 0.02 ) ( 0.98 ) 49 + 1225 ( 0.02 ) 2 ( 0.98 ) 48 ≐ 0.92 因此,根据抽样过程,该生产工艺在任意一天停机的概率约为 0.08。容量为 50 的随机样本中不合格芯片数的均值为
E ( X ) = n p = 50 ( 0.02 ) = 1
E (X) = n p = 50 (0. 02) = 1
E ( X ) = n p = 50 ( 0.02 ) = 1 方差为
V ( X ) = n p q = 50 ( 0.02 ) ( 0.98 ) = 0.98
V (X) = n p q = 50 (0. 02) (0. 98) = 0. 98
V ( X ) = n pq = 50 ( 0.02 ) ( 0.98 ) = 0.98 二项分布的 cdf 已由 Banks 和 Heikes [1984] 等人制成了表格。这些表格能大大减少计算诸如 P ( a < X ≤ b ) P ( a < X \leq b ) P ( a < X ≤ b ) p p p
3.3 几何分布与负二项分布 几何分布与一串伯努利试验有关;所关注的随机变量 X 定义为取得第一次成功所需的试验次数。X 的分布为
p ( x ) = { q x − 1 p , x = 1 , 2 , … 0 , otherwise (15)
p (x) = \left\{\begin{array}{l l} q^{x - 1} p, & x = 1, 2, \ldots \\ 0, & \text{otherwise} \end{array} \right.\tag{15}
p ( x ) = { q x − 1 p , 0 , x = 1 , 2 , … otherwise ( 15 ) 事件 { X = x } \{X = x \} { X = x } x − 1 x - 1 x − 1 q = 1 − p q = 1 - p q = 1 − p p p p
P ( F F F ⋅ ⋅ ⋅ F S ) = q x − 1 p
P (F F F \cdot \cdot \cdot F S) = q^{x - 1} p
P ( F F F ⋅ ⋅ ⋅ F S ) = q x − 1 p 均值和方差为
E ( X ) = 1 p (16)
E (X) = \frac {1}{p}\tag{16}
E ( X ) = p 1 ( 16 ) 以及
V ( X ) = q p 2 (17)
V (X) = \frac {q}{p^{2}}\tag{17}
V ( X ) = p 2 q ( 17 ) 更一般地,负二项分布是直到第 k 次成功为止所需试验次数的分布,其中 k = 1 , 2 , … k = 1 , 2 , \ldots k = 1 , 2 , …
p ( y ) = { ( y − 1 k − 1 ) q y − k p k , y = k , k + 1 , k + 2 , … 0 , otherwise (18)
p (y) = \left\{\begin{array}{l l} \binom {y - 1} {k - 1} q^{y - k} p^{k}, & y = k, k + 1, k + 2, \ldots \\ 0, & \text{otherwise} \end{array} \right.\tag{18}
p ( y ) = { ( k − 1 y − 1 ) q y − k p k , 0 , y = k , k + 1 , k + 2 , … otherwise ( 18 ) 因为我们可以把负二项随机变量 Y 看作 k 个相互独立的几何随机变量之和,所以很容易看出 E ( Y ) = k / p E ( Y ) = k / p E ( Y ) = k / p V ( X ) = k q / p 2 V ( X ) = k q / p^{2} V ( X ) = k q / p 2
例 11 装配好的喷墨打印机中有 40% 在检验工位被拒收。求所检验的第三台喷墨打印机是第一台合格品的概率。把每次检验看作一次伯努利试验,其中 q = 0.4 q = 0 . 4 q = 0.4 p = 0.6 p = 0 . 6 p = 0.6
p ( 3 ) = 0.4 2 ( 0.6 ) = 0.096
p (3) = 0. 4^{2} (0. 6) = 0. 096
p ( 3 ) = 0. 4 2 ( 0.6 ) = 0.096 因此,从任意起始点算起,第一台合格打印机恰好是第三台的情形只占大约 10%。要确定所检验的第三台打印机是第二台合格品的概率,则使用负二项分布式 (18):
p ( 3 ) = ( 3 − 1 2 − 1 ) 0.4 3 − 2 ( 0.6 ) 2 = ( 2 1 ) 0.4 ( 0.6 ) 2 = 0.288
p (3) = \binom {3 - 1} {2 - 1} 0. 4^{3 - 2} (0. 6) ^ {2} = \binom {2} {1} 0. 4 (0. 6) ^ {2} = 0. 288
p ( 3 ) = ( 2 − 1 3 − 1 ) 0. 4 3 − 2 ( 0.6 ) 2 = ( 1 2 ) 0.4 ( 0.6 ) 2 = 0.288 3.4 泊松分布 泊松分布能很好地描述许多随机过程,而且数学上相当简单。泊松分布由 S. D. Poisson 于 1837 年在一本论述刑法与民法问题的著作中提出。(这本相当古老的著作名为 Recherches sur la probabilit´e des jugements en mati`ere criminelle et en mati`ere civile 。显然,在概率论教授们代代相传的关于泊松分布起源的传闻并不属实。据说泊松分布最初是用来为普鲁士军队中因马蹄踢击而致死的情况建模的。)
泊松概率质量函数为
p ( x ) = { e − α α x x ! , x = 0 , 1 , … 0 , otherwise (19)
p (x) = \left\{\begin{array}{l l} \frac {e^{- \alpha} \alpha^{x}}{x !}, & x = 0, 1, \ldots \\ 0, & \text{otherwise} \end{array} \right.\tag{19}
p ( x ) = { x ! e − α α x , 0 , x = 0 , 1 , … otherwise ( 19 ) 其中 α > 0 > 0 > 0
E ( X ) = α = V ( X )
E (X) = \alpha = V (X)
E ( X ) = α = V ( X ) 累积分布函数为
F ( x ) = ∑ i = 0 x e − α α i i ! (20)
F (x) = \sum_{i = 0} ^ {x} \frac {e^{- \alpha} \alpha^{i}}{i !}\tag{20}
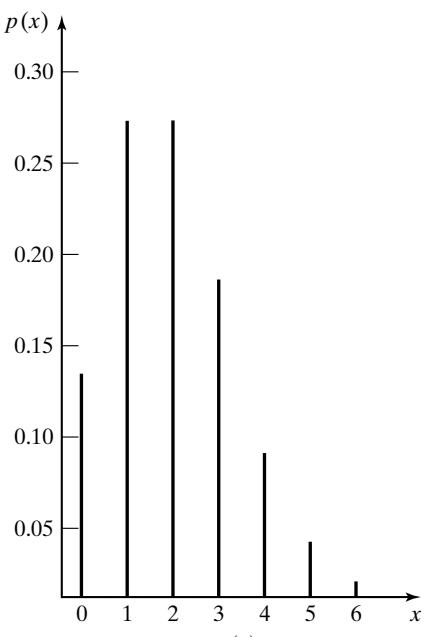
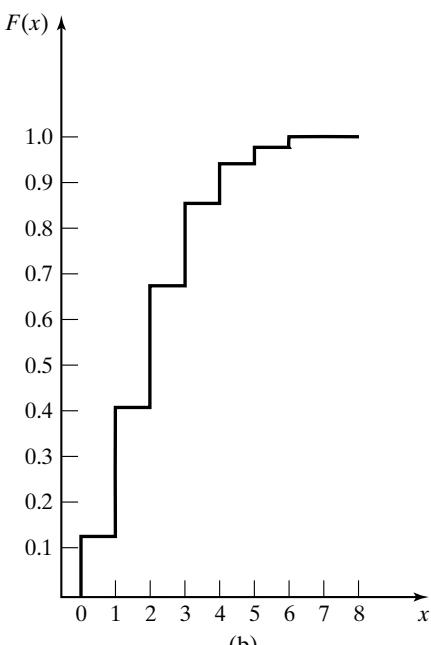
F ( x ) = i = 0 ∑ x i ! e − α α i ( 20 ) 参数为 α = 2 \alpha = 2 α = 2
图 7 泊松分布的 pmf 与 cdf。
例 12 每当有服务来电时,一位计算机修理人员就会收到一次"蜂鸣"提示。已知每小时的蜂鸣次数服从均值为每小时 α = 2 \alpha = 2 α = 2 x = 3 x = 3 x = 3
p ( 3 ) = e − 2 2 3 3 ! = ( 0.135 ) ( 8 ) 6 = 0.18
p (3) = \frac {e^{- 2} 2^{3}}{3 !} = \frac {(0 . 135) (8)}{6} = 0. 18
p ( 3 ) = 3 ! e − 2 2 3 = 6 ( 0.135 ) ( 8 ) = 0.18 同一结果也可以从图 7 的左侧读出,或从表 A.4 中由
F ( 3 ) − F ( 2 ) = 0.857 − 0.677 = 0.18
F (3) - F (2) = 0. 857 - 0. 677 = 0. 18
F ( 3 ) − F ( 2 ) = 0.857 − 0.677 = 0.18 算出。
例 13 在例 12 中,求 1 小时内出现两次或更多次蜂鸣的概率。
P ( 2 or more ) = 1 − p ( 0 ) − p ( 1 ) = 1 − F ( 1 ) = 1 − 0.406 = 0.594
\begin{array}{c} P (2 \text{or more}) = 1 - p (0) - p (1) = 1 - F (1) \\ = 1 - 0. 406 = 0. 594 \end{array}
P ( 2 or more ) = 1 − p ( 0 ) − p ( 1 ) = 1 − F ( 1 ) = 1 − 0.406 = 0.594 累积概率 F ( 1 ) F ( 1 ) F ( 1 )
例 14 库存系统中的提前期需求,是某项物品从下单时刻起直至收到订单为止这段时间内需求量的累积,即
L = ∑ i = 1 T D i (21)
L = \sum_{i = 1} ^ {T} D_{i}\tag{21}
L = i = 1 ∑ T D i ( 21 ) 其中 L L L D i D_{i} D i D i D_{i} D i T T T
库存管理者希望提前期内发生缺货的概率不超过某个给定比例。例如,可以规定提前期内出现短缺的概率不超过 5%。
如果提前期需求服从泊松分布,再订货点的确定就大大简化了。再订货点是下达新订单时的库存水平。
设提前期需求服从均值为 α = 10 \alpha = 10 α = 10
F ( x ) = ∑ i = 0 x e − 10 10 i i ! ≥ 0.95
F (x) = \sum_{i = 0} ^ {x} \frac {e^{- 10} 10^{i}}{i !} \geq 0. 95
F ( x ) = i = 0 ∑ x i ! e − 10 1 0 i ≥ 0.95 所求结果在 x = 15 x = 15 x = 15 p ( 0 ) , p ( 1 ) p ( 0 ) , p ( 1 ) p ( 0 ) , p ( 1 )
4 连续分布 连续随机变量用于描述这样一类随机现象:所关注的变量可以在某个区间内取任意值——例如故障时间或杆件的长度。以下各小节描述九个分布。
4.1 均匀分布 如果随机变量 X 的 pdf 为下式,则称 X 在区间 [a, b] 上服从均匀分布:
f ( x ) = { 1 b − a , a ≤ x ≤ b 0 , otherwise (22)
f (x) = \left\{\begin{array}{l l} \frac {1}{b - a}, & a \leq x \leq b \\ 0, & \text{otherwise} \end{array} \right.\tag{22}
f ( x ) = { b − a 1 , 0 , a ≤ x ≤ b otherwise ( 22 ) 其 cdf 为
F ( x ) = { 0 , x < a x − a b − a , a ≤ x < b 1 , x ≥ b (23)
F (x) = \left\{\begin{array}{l l} 0, & x < a \\ \frac {x - a}{b - a}, & a \leq x < b \\ 1, & x \geq b \end{array} \right.\tag{23}
F ( x ) = ⎩ ⎨ ⎧ 0 , b − a x − a , 1 , x < a a ≤ x < b x ≥ b ( 23 ) 图 8 均匀分布的 pdf 与 cdf。
注意,对于所有满足 a ≤ x 1 < x 2 ≤ b a \leq x_{1} < x_{2} \leq b a ≤ x 1 < x 2 ≤ b x 1 x_{1} x 1 x 2 x_{2} x 2
P ( x 1 < X < x 2 ) = F ( x 2 ) − F ( x 1 ) = x 2 − x 1 b − a
P (x_{1} < X < x_{2}) = F (x_{2}) - F (x_{1}) = \frac {x_{2} - x_{1}}{b - a}
P ( x 1 < X < x 2 ) = F ( x 2 ) − F ( x 1 ) = b − a x 2 − x 1 与区间的长度成正比。该分布的均值和方差为
E ( X ) = a + b 2 (24)
E (X) = \frac {a + b}{2}\tag{24}
E ( X ) = 2 a + b ( 24 ) 以及
V ( X ) = ( b − a ) 2 12 (25)
V (X) = \frac {(b - a) ^ {2}}{12}\tag{25}
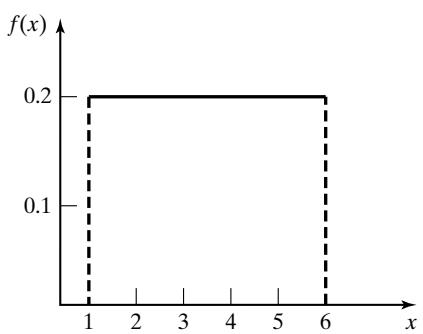
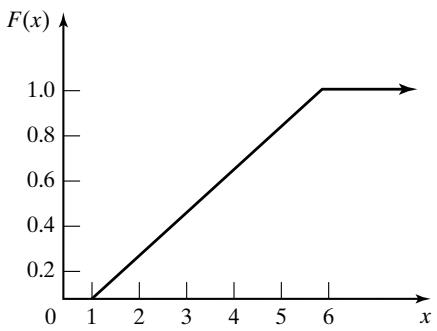
V ( X ) = 12 ( b − a ) 2 ( 25 ) 当 a = 1 a = 1 a = 1 b = 6 b = 6 b = 6
均匀分布在仿真中起着至关重要的作用。在 0 与 1 之间均匀分布的随机数,为生成随机事件提供了手段。已经设计出许多生成均匀分布随机数的方法。随后,均匀分布的随机数被用于从所有其他分布中生成随机变量样本。
例 15 正在开发一项仓库作业的仿真。大约每 3 分钟就会有一个电话,要求叉车司机开到某个指定位置。最初作出的假设是:电话之间的时间(到达间隔时间)服从均值为 3 分钟的均匀分布。由式 (25),均值为 3 且具有最大可能变异性的均匀分布,其参数值为 a = 0 a = 0 a = 0 b = 6 b = 6 b = 6
例 16 一辆公共汽车从上午 6:40 开始到上午 8:40,每隔 20 分钟到达某个指定站点。某位乘客不了解时刻表,但每天早晨在上午 7:00 到 7:30 之间随机(均匀分布)到达。求该乘客等待公交超过 5 分钟的概率。
只有当到达时刻在上午 7:00 到 7:15 之间,或在上午 7:20 到 7:30 之间时,该乘客才需等待 5 分钟以上。若 X 是表示乘客在上午 7:00 之后多少分钟到达的随机变量,则所求概率为
P ( 0 < X < 15 ) + P ( 20 < X < 30 )
P (0 < X < 15) + P (20 < X < 30)
P ( 0 < X < 15 ) + P ( 20 < X < 30 ) 现在,X 是在 (0, 30) 上均匀分布的随机变量。因此所求概率为
F ( 15 ) + F ( 30 ) − F ( 20 ) = 15 30 + 1 − 20 30 = 5 6
F (15) + F (30) - F (20) = \frac {15}{30} + 1 - \frac {20}{30} = \frac {5}{6}
F ( 15 ) + F ( 30 ) − F ( 20 ) = 30 15 + 1 − 30 20 = 6 5 4.2 指数分布 如果随机变量 X 的 pdf 为下式,其中 λ > 0 \lambda > 0 λ > 0 λ \lambda λ
f ( x ) = { λ e − λ x , x ≥ 0 0 , elsewhere (26)
f (x) = \left\{\begin{array}{l l} \lambda e^{- \lambda x}, & x \geq 0 \\ 0, & \text{elsewhere} \end{array} \right.\tag{26}
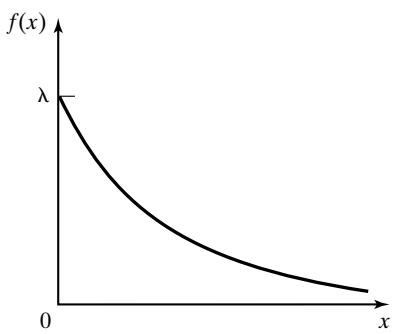
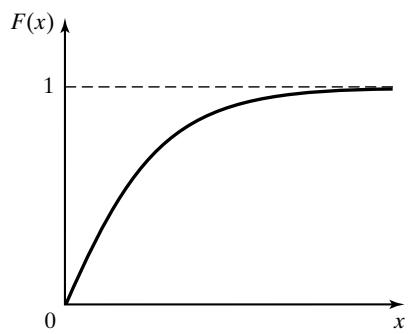
f ( x ) = { λ e − λ x , 0 , x ≥ 0 elsewhere ( 26 ) 密度函数见图 9 和图 3。图 9 还给出了其 cdf。
当到达完全随机时,指数分布已被用于对到达间隔时间建模;它也被用于对变异很大的服务时间建模。在这些场合中,λ 是一个速率:每小时到达数或每分钟服务数。指数分布还已被用于对发生灾难性(瞬间)故障的部件寿命建模,例如灯泡;此时 λ 是故障率。
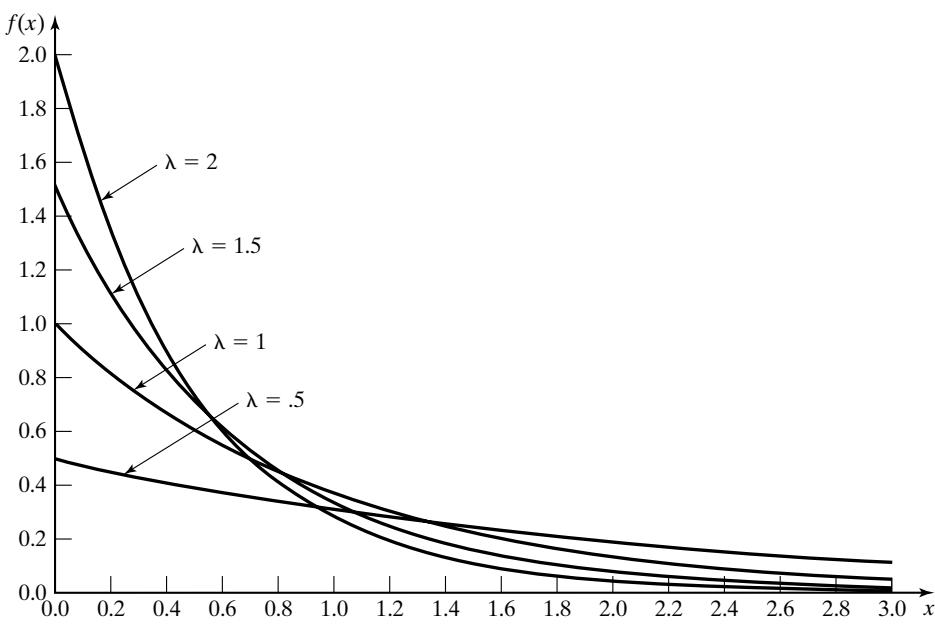
图 10 给出了若干不同的指数 pdf。纵轴上的截距值总是等于 λ 的值。还要注意,所有 pdf 最终都会相交。(为什么?)
图 9 指数密度函数与累积分布函数。
图 10 若干指数分布的 pdf。
指数分布的均值和方差为
E ( X ) = 1 λ and V ( X ) = 1 λ 2 (27)
E (X) = \frac {1}{\lambda} \quad \text{and} \quad V (X) = \frac {1}{\lambda^{2}}\tag{27}
E ( X ) = λ 1 and V ( X ) = λ 2 1 ( 27 ) 因此,均值与标准差相等。对式 (26) 积分即得 cdf:
F ( x ) = { 0 , x < 0 ∫ 0 x λ e − λ t d t = 1 − e − λ x , x ≥ 0 (28)
F (x) = \left\{\begin{array}{l l} 0, & x < 0 \\ \int_{0} ^ {x} \lambda e^{- \lambda t} d t = 1 - e^{- \lambda x}, & x \geq 0 \end{array} \right.\tag{28}
F ( x ) = { 0 , ∫ 0 x λ e − λ t d t = 1 − e − λ x , x < 0 x ≥ 0 ( 28 ) 例 17 假设一盏工业灯的寿命(以千小时计)服从故障率为 λ = 1 / 3 \lambda = 1 / 3 λ = 1/3 P ( X > 3 ) = 1 − P ( X ≤ 3 ) = 1 − F ( 3 ) P ( X > 3 ) = 1 - P ( X \le 3 ) = 1 - F ( 3 ) P ( X > 3 ) = 1 − P ( X ≤ 3 ) = 1 − F ( 3 )
P ( X > 3 ) = 1 − ( 1 − e − 3 / 3 ) = e − 1 = 0.368
P (X > 3) = 1 - \left(1 - e^{- 3 / 3}\right) = e^{- 1} = 0. 368
P ( X > 3 ) = 1 − ( 1 − e − 3/3 ) = e − 1 = 0.368 无论 λ \lambda λ λ \lambda λ
P ( 2 ≤ X ≤ 3 ) = F ( 3 ) − F ( 2 )
P (2 \leq X \leq 3) = F (3) - F (2)
P ( 2 ≤ X ≤ 3 ) = F ( 3 ) − F ( 2 ) 同样由式 (28) 给出的 cdf,
F ( 3 ) − F ( 2 ) = ( 1 − e − 3 / 3 ) − ( 1 − e − 2 / 3 ) = − 0.368 + 0.513 = 0.145
\begin{array}{c} F (3) - F (2) = (1 - e^{- 3 / 3}) - (1 - e^{- 2 / 3}) \\ = - 0. 368 + 0. 513 = 0. 145 \end{array}
F ( 3 ) − F ( 2 ) = ( 1 − e − 3/3 ) − ( 1 − e − 2/3 ) = − 0.368 + 0.513 = 0.145 指数分布最重要的性质之一是它具有"无记忆性",即对所有 s ≥ 0 s \geq 0 s ≥ 0 t ≥ 0 t \geq 0 t ≥ 0
P ( X > s + t ∣ X > s ) = P ( X > t ) (29)
P (X > s + t | X > s) = P (X > t)\tag{29}
P ( X > s + t ∣ X > s ) = P ( X > t ) ( 29 ) 设 X 表示某个部件(一节电池、一个灯泡、一片计算机芯片、一台激光器等)的寿命,并假定 X 服从指数分布。式 (29) 表明:已知该部件已存活 s 小时的条件下,它至少再存活 s + t s + t s + t X > s X > s X > s X − s X - s X − s
式 (29) 成立,可以通过考察条件概率来证明:
P ( X > s + t ∣ X > s ) = P ( X > s + t ) P ( X > s ) (30)
P (X > s + t | X > s) = \frac {P (X > s + t)}{P (X > s)}\tag{30}
P ( X > s + t ∣ X > s ) = P ( X > s ) P ( X > s + t ) ( 30 ) 利用式 (28) 可以求出式 (30) 的分子和分母,从而得到
P ( X > s + t ∣ X > s ) = e − λ ( s + t ) e − λ s = e − λ t = P ( X > t )
\begin{array}{c} P (X > s + t | X > s) = \frac {e^{- \lambda (s + t)}}{e^{- \lambda s}} = e^{- \lambda t} \\ = P (X > t) \end{array}
P ( X > s + t ∣ X > s ) = e − λ s e − λ ( s + t ) = e − λ t = P ( X > t ) 例 18 求例 17 中的工业灯在运行了 2500 小时之后还能再使用 1000 小时的概率。利用式 (29) 和式 (28) 可以求得:
P ( X > 3.5 ∣ X > 2.5 ) = P ( X > 1 ) = e − 1 / 3 = 0.717
P (X > 3. 5 | X > 2. 5) = P (X > 1) = e^{- 1 / 3} = 0. 717
P ( X > 3.5∣ X > 2.5 ) = P ( X > 1 ) = e − 1/3 = 0.717 例 18 说明了无记忆性质——即服从指数分布的用过的部件与新部件一样好。一个全新部件寿命大于 1000 小时的概率同样等于 0.717。一般地说,假设观测到某个寿命服从参数为 λ 的指数分布的部件,并发现在任意时刻它仍在运行,那么其剩余寿命的分布也是参数为 λ 的指数分布。指数分布是唯一具有无记忆性的连续分布。(几何分布是唯一具有无记忆性的离散分布。)
4.3 伽马分布 用于定义伽马分布的函数之一是伽马函数,它对所有 β > 0 \beta > 0 β > 0
Γ ( β ) = ∫ 0 ∞ x β − 1 e − x d x (31)
\Gamma (\beta) = \int_{0} ^ {\infty} x^{\beta - 1} e^{- x} d x\tag{31}
Γ ( β ) = ∫ 0 ∞ x β − 1 e − x d x ( 31 ) 对式 (31) 分部积分,可以证明
Γ ( β ) = ( β − 1 ) Γ ( β − 1 ) (32)
\Gamma (\beta) = (\beta - 1) \Gamma (\beta - 1)\tag{32}
Γ ( β ) = ( β − 1 ) Γ ( β − 1 ) ( 32 ) 如果 β \beta β Γ ( 1 ) = 1 \Gamma ( 1 ) = 1 Γ ( 1 ) = 1
Γ ( β ) = ( β − 1 ) ! (33)
\Gamma (\beta) = (\beta - 1)!\tag{33}
Γ ( β ) = ( β − 1 )! ( 33 ) 伽马函数可以看作是把阶乘概念推广到所有正数(而不仅仅是整数)上。
如果随机变量 X 的 pdf 为下式,则称 X 服从参数为 β \beta β
f ( x ) = { β θ Γ ( β ) ( β θ x ) β − 1 e − β θ x , x > 0 0 , otherwise (34)
f (x) = \left\{\begin{array}{l l} \frac {\beta \theta}{\Gamma (\beta)} (\beta \theta x) ^ {\beta - 1} e^{- \beta \theta x}, & x > 0 \\ 0, & \text{otherwise} \end{array} \right.\tag{34}
f ( x ) = { Γ ( β ) β θ ( β θ x ) β − 1 e − β θ x , 0 , x > 0 otherwise ( 34 ) β \beta β θ = 1 \theta = 1 θ = 1 β \beta β
伽马分布的均值和方差为
E ( X ) = 1 θ (35)
E (X) = \frac {1}{\theta}\tag{35}
E ( X ) = θ 1 ( 35 ) 以及
V ( X ) = 1 β θ 2 (36)
V (X) = \frac {1}{\beta \theta^{2}}\tag{36}
V ( X ) = β θ 2 1 ( 36 ) X 的 cdf 为
F ( x ) = { 1 − ∫ x ∞ β θ Γ ( β ) ( β θ t ) β − 1 e − β θ t d t , x > 0 0 , x ≤ 0 (37)
F (x) = \left\{\begin{array}{l l} 1 - \int_{x} ^ {\infty} \frac {\beta \theta}{\Gamma (\beta)} (\beta \theta t) ^ {\beta - 1} e^{- \beta \theta t} d t, & x > 0 \\ 0, & x \leq 0 \end{array} \right.\tag{37}
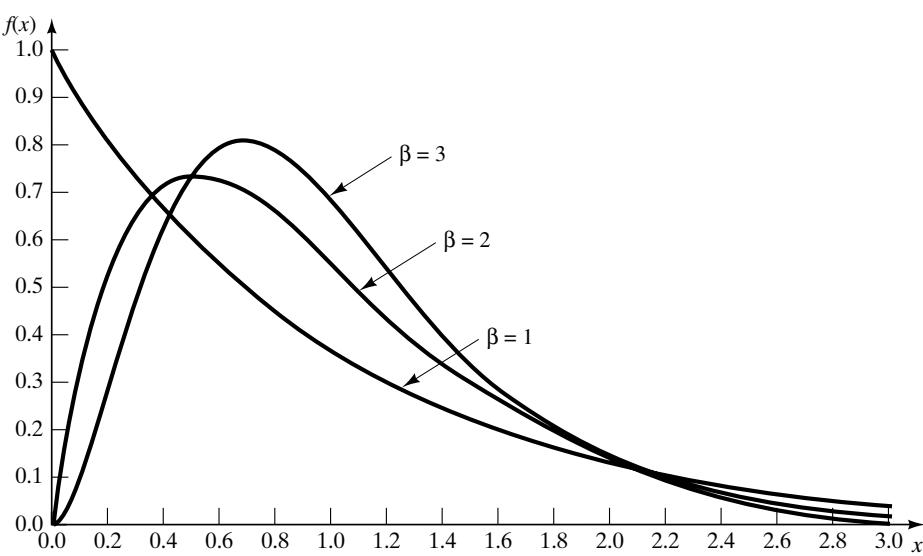
F ( x ) = { 1 − ∫ x ∞ Γ ( β ) β θ ( β θ t ) β − 1 e − β θ t d t , 0 , x > 0 x ≤ 0 ( 37 ) 图 11 θ = 1 时若干伽马分布的 pdf。
当 β \beta β β \beta β β θ \beta \theta β θ β \beta β
X = X 1 + X 2 + ⋯ + X β (38)
X = X_{1} + X_{2} + \dots + X_{\beta}\tag{38}
X = X 1 + X 2 + ⋯ + X β ( 38 ) 其中 X j X_{j} X j
g ( x j ) = { ( β θ ) e − β θ x j , x ≥ 0 0 , otherwise
g (x_{j}) = \left\{\begin{array}{l l} (\beta \theta) e ^ {- \beta \theta x_{j}}, & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.
g ( x j ) = { ( β θ ) e − β θ x j , 0 , x ≥ 0 otherwise 并且各 X j X_{j} X j β = 1 \beta = 1 β = 1 β = 1 \beta = 1 β = 1
4.4 厄兰分布 当 β = k \beta = k β = k β \beta β β = k \beta = k β = k
E ( X ) = E ( X 1 ) + E ( X 2 ) + ⋯ + E ( X k )
E (X) = E (X_{1}) + E (X_{2}) + \dots + E (X_{k})
E ( X ) = E ( X 1 ) + E ( X 2 ) + ⋯ + E ( X k ) 每个服从指数分布的 X j X_{j} X j 1 / k θ 1 / k \theta 1/ k θ
E ( X ) = 1 k θ + 1 k θ + ⋯ + 1 k θ = 1 θ
E (X) = \frac {1}{k \theta} + \frac {1}{k \theta} + \dots + \frac {1}{k \theta} = \frac {1}{\theta}
E ( X ) = k θ 1 + k θ 1 + ⋯ + k θ 1 = θ 1 如果各随机变量 X j X_{j} X j
V ( X ) = 1 ( k θ ) 2 + 1 ( k θ ) 2 + ⋯ + 1 ( k θ ) 2 = 1 k θ 2
V (X) = \frac {1}{(k \theta) ^ {2}} + \frac {1}{(k \theta) ^ {2}} + \dots + \frac {1}{(k \theta) ^ {2}} = \frac {1}{k \theta^{2}}
V ( X ) = ( k θ ) 2 1 + ( k θ ) 2 1 + ⋯ + ( k θ ) 2 1 = k θ 2 1 当 β = k \beta = k β = k
F ( x ) = { 1 − ∑ i = 0 k − 1 e − k θ x ( k θ x ) i i ! , x > 0 0 , x ≤ 0 (39)
F (x) = \left\{\begin{array}{l l} 1 - \sum_{i = 0} ^ {k - 1} \frac {e^{- k \theta x} (k \theta x) ^ {i}}{i !}, & x > 0 \\ 0, & x \leq 0 \end{array} \right.\tag{39}
F ( x ) = { 1 − ∑ i = 0 k − 1 i ! e − k θ x ( k θ x ) i , 0 , x > 0 x ≤ 0 ( 39 ) 它是均值为 α = k θ x \alpha = k \theta x α = k θ x
例 19 某大学电气工程专业的教授暑假要离开家,但他希望始终有一盏灯亮着以吓退窃贼。教授装配了一个可装两个灯泡的装置。当第一个灯泡失效时,该装置会把电流切换到第二个灯泡上。灯泡包装盒上写着:“平均寿命 1000 小时,服从指数分布。“教授将外出 90 天(2160 小时)。问夏季结束、教授返回时仍有一盏灯亮着的概率是多少?
系统至少工作 x 小时的概率称为可靠度函数(reliability function)R ( x ) R ( x ) R ( x )
R ( x ) = 1 − F ( x )
R (x) = 1 - F (x)
R ( x ) = 1 − F ( x ) 本例中,整个系统的总寿命由式 (38) 给出,其中 β = k = 2 \beta = k = 2 β = k = 2 k θ = 1 / 1000 k \theta = 1 / 1000 k θ = 1/1000 θ = 1 / 2000 \theta = 1 / 2000 θ = 1/2000 F ( 2160 ) F ( 2160 ) F ( 2160 )
F ( 2160 ) = 1 − ∑ i = 0 1 e − ( 2 ) ( 1 / 2000 ) ( 2160 ) [ ( 2 ) ( 1 / 2000 ) ( 2160 ) ] i i ! = 1 − e − 2.16 ∑ i = 0 1 ( 2.16 ) i i ! = 0.636
\begin{array}{l} F (2160) = 1 - \sum_{i = 0} ^ {1} \frac {e^{- (2) (1 / 2000) (2160)} [ (2) (1 / 2000) (2160) ] ^ {i}}{i !} \\ = 1 - e^{- 2. 16} \sum_{i = 0} ^ {1} \frac {(2 . 16) ^ {i}}{i !} = 0. 636 \end{array}
F ( 2160 ) = 1 − ∑ i = 0 1 i ! e − ( 2 ) ( 1/2000 ) ( 2160 ) [( 2 ) ( 1/2000 ) ( 2160 ) ] i = 1 − e − 2.16 ∑ i = 0 1 i ! ( 2.16 ) i = 0.636 因此,教授返回时仍有一盏灯亮着的概率约为 36%。
例 20 一位医生给病人做体检,共分三个阶段。每个阶段都服从均值为 20 分钟的指数分布。求体检在 50 分钟或以内完成的概率。同时,计算体检时间的期望长度。本例中,k = 3 k = 3 k = 3 k θ = 1 / 20 k \theta = 1 / 20 k θ = 1/20 θ = 1 / 60 \theta = 1 / 60 θ = 1/60 F ( 50 ) F ( 50 ) F ( 50 )
F ( 50 ) = 1 − ∑ i = 0 2 e − ( 3 ) ( 1 / 60 ) ( 50 ) [ ( 3 ) ( 1 / 60 ) ( 50 ) ] i i ! = 1 − ∑ i = 0 2 e − 5 / 2 ( 5 / 2 ) i i !
\begin{array}{l} F (50) = 1 - \sum_{i = 0} ^ {2} \frac {e^{- (3) (1 / 60) (50)} [ (3) (1 / 60) (50) ] ^ {i}}{i !} \\ = 1 - \sum_{i = 0} ^ {2} \frac {e^{- 5 / 2} (5 / 2) ^ {i}}{i !} \end{array}
F ( 50 ) = 1 − ∑ i = 0 2 i ! e − ( 3 ) ( 1/60 ) ( 50 ) [( 3 ) ( 1/60 ) ( 50 ) ] i = 1 − ∑ i = 0 2 i ! e − 5/2 ( 5/2 ) i 利用表 A.4 所示的泊松累积分布,可以计算出
F ( 50 ) = 1 − 0.543 = 0.457
F (50) = 1 - 0. 543 = 0. 457
F ( 50 ) = 1 − 0.543 = 0.457 体检在 50 分钟或以内完成的概率为 0.457。体检时间的期望长度由式 (35) 求得:
E ( X ) = 1 θ = 1 1 / 60 = 60 minutes
E (X) = \frac {1}{\theta} = \frac {1}{1 / 60} = 60 \text{minutes}
E ( X ) = θ 1 = 1/60 1 = 60 minutes 此外,X 的方差为 V ( X ) = 1 / β θ 2 = 1200 V ( X ) = 1 / \beta \theta^{2} = 1200 V ( X ) = 1/ β θ 2 = 1200
M o d e = k − 1 k θ (40)
\mathrm{Mode} = \frac {k - 1}{k \theta}\tag{40}
Mode = k θ k − 1 ( 40 ) 因此,本例中的众数值为
M o d e = 3 − 1 3 ( 1 / 60 ) = 40 m i n u t e s
\mathrm{Mode} = \frac {3 - 1}{3 (1 / 60)} = 40 \mathrm{minutes}
Mode = 3 ( 1/60 ) 3 − 1 = 40 minutes 4.5 正态分布 具有均值 − ∞ < μ < ∞ - \infty < \mu < \infty − ∞ < μ < ∞ σ 2 > 0 \sigma^{2} > 0 σ 2 > 0
f ( x ) = 1 σ 2 π exp [ − 1 2 ( x − μ σ ) 2 ] , − ∞ < x < ∞ (41)
f (x) = \frac {1}{\sigma \sqrt {2 \pi}} \exp \left[ - \frac {1}{2} \left(\frac {x - \mu}{\sigma}\right) ^ {2} \right], \quad - \infty < x < \infty\tag{41}
f ( x ) = σ 2 π 1 exp [ − 2 1 ( σ x − μ ) 2 ] , − ∞ < x < ∞ ( 41 ) 则称 X 服从正态分布。
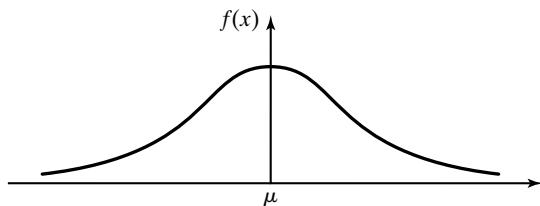
图 12 正态分布的 pdf。
正态分布使用得如此频繁,以至于许多作者采用记号 X ∼ N ( μ , σ 2 ) X \sim N ( \mu , \sigma^{2} ) X ∼ N ( μ , σ 2 ) μ \mu μ σ 2 \sigma^{2} σ 2
这里列出正态分布的若干特殊性质:
a. lim x ⟶ − ∞ f ( x ) = 0 \lim _ {x \longrightarrow - \infty} f ( x ) = 0 lim x ⟶ − ∞ f ( x ) = 0 lim x ⟶ ∞ f ( x ) = 0 \lim _ {x \longrightarrow \infty} f ( x ) = 0 lim x ⟶ ∞ f ( x ) = 0
b. f ( μ − x ) = f ( μ + x ) f ( \mu - x ) = f ( \mu + x ) f ( μ − x ) = f ( μ + x ) μ \mu μ
c. pdf 的最大值出现在 x = μ x = \mu x = μ
正态分布的 cdf 为
F ( x ) = P ( X ≤ x ) = ∫ − ∞ x 1 σ 2 π exp [ − 1 2 ( t − μ σ ) 2 ] d t (42)
F (x) = P (X \leq x) = \int_{- \infty} ^ {x} \frac {1}{\sigma \sqrt {2 \pi}} \exp \left[ - \frac {1}{2} \left(\frac {t - \mu}{\sigma}\right) ^ {2} \right] d t\tag{42}
F ( x ) = P ( X ≤ x ) = ∫ − ∞ x σ 2 π 1 exp [ − 2 1 ( σ t − μ ) 2 ] d t ( 42 ) 式 (42) 无法用闭式求值。可以采用数值方法,但似乎必须对每一对 ( μ , σ 2 ) ( \mu , \sigma^{2} ) ( μ , σ 2 ) z = ( t − μ ) / σ z = ( t - \mu ) / \sigma z = ( t − μ ) / σ μ \mu μ σ \sigma σ X ∼ N ( μ , σ 2 ) X \sim N ( \mu , \sigma^{2} ) X ∼ N ( μ , σ 2 ) Z = ( X − μ ) / σ Z = ( X - \mu ) / \sigma Z = ( X − μ ) / σ
F ( x ) = P ( X ≤ x ) = P ( Z ≤ x − μ σ ) = ∫ − ∞ ( x − μ ) / σ 1 2 π e − z 2 / 2 d z = ∫ − ∞ ( x − μ ) / σ ϕ ( z ) d z = Φ ( x − μ σ ) (43)
\begin{array}{l} F (x) = P (X \leq x) = P \left(Z \leq \frac {x - \mu}{\sigma}\right) \\ = \int_{- \infty} ^ {(x - \mu) / \sigma} \frac {1}{\sqrt {2 \pi}} e ^ {- z^{2} / 2} d z \\ = \int_{- \infty} ^ {(x - \mu) / \sigma} \phi (z) d z = \Phi \left(\frac {x - \mu}{\sigma}\right) \end{array}\tag{43}
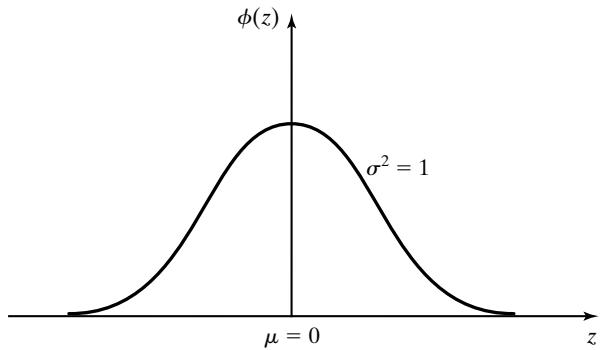
F ( x ) = P ( X ≤ x ) = P ( Z ≤ σ x − μ ) = ∫ − ∞ ( x − μ ) / σ 2 π 1 e − z 2 /2 d z = ∫ − ∞ ( x − μ ) / σ ϕ ( z ) d z = Φ ( σ x − μ ) ( 43 ) 图 13 标准正态分布的 pdf。
pdf
ϕ ( z ) = 1 2 π e − z 2 / 2 , − ∞ < z < ∞ (44)
\phi (z) = \frac {1}{\sqrt {2 \pi}} e ^ {- z^{2} / 2}, - \infty < z < \infty\tag{44}
ϕ ( z ) = 2 π 1 e − z 2 /2 , − ∞ < z < ∞ ( 44 ) 是均值为 0、方差为 1 的正态分布的 pdf。于是 Z ∼ N ( 0 , 1 ) Z \sim N ( 0 , 1 ) Z ∼ N ( 0 , 1 ) Z Z Z
Φ ( z ) = ∫ − ∞ z 1 2 π e − t 2 / 2 d t (45)
\Phi (z) = \int_{- \infty} ^ {z} \frac {1}{\sqrt {2 \pi}} e ^ {- t^{2} / 2} d t\tag{45}
Φ ( z ) = ∫ − ∞ z 2 π 1 e − t 2 /2 d t ( 45 ) 式 (45) 已被广泛地制成数值表。z ≥ 0 z \geq 0 z ≥ 0 Φ ( z ) \Phi ( z ) Φ ( z )
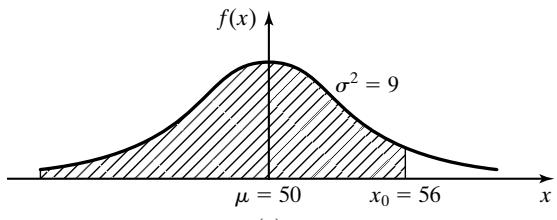
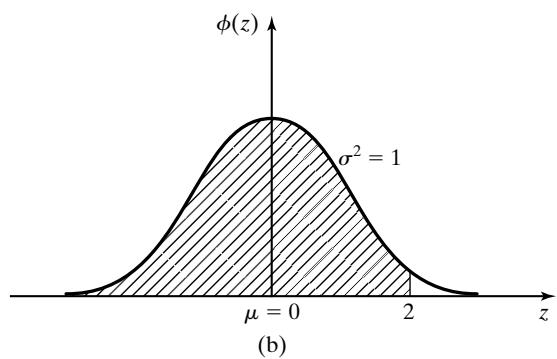
例 21 假设已知 X ∼ N ( 50 , 9 ) X \sim N ( 50 , 9 ) X ∼ N ( 50 , 9 ) F ( 56 ) = P ( X ≤ 56 ) F ( 56 ) = P ( X \leq 56 ) F ( 56 ) = P ( X ≤ 56 )
F ( 56 ) = Φ ( 56 − 50 3 ) = Φ ( 2 ) = 0.9772
F (56) = \Phi \left(\frac {56 - 50}{3}\right) = \Phi (2) = 0. 9772
F ( 56 ) = Φ ( 3 56 − 50 ) = Φ ( 2 ) = 0.9772 其直观解释见图 14。图 14(a) 给出了 X ∼ N ( 50 , 9 ) X \sim N ( 50 , 9 ) X ∼ N ( 50 , 9 ) x 0 = 56 x_{0} = 56 x 0 = 56 Z ∼ N ( 0 , 1 ) Z \sim N ( 0 , 1 ) Z ∼ N ( 0 , 1 ) x 0 = 56 x_{0} = 56 x 0 = 56 σ = 3 \sigma = 3 σ = 3
图 14 变换到标准正态分布。
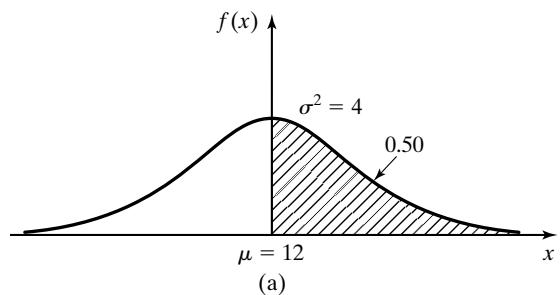
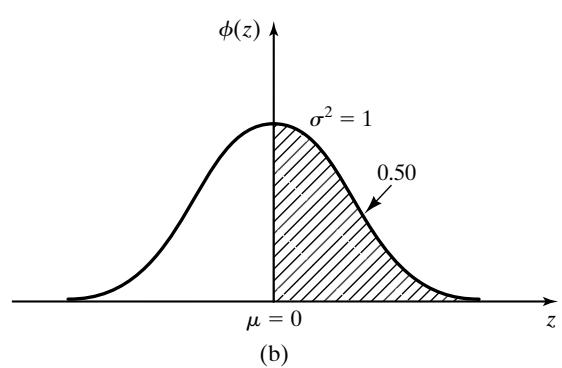
例 22 装载一艘远洋船舶所需的时间(以小时计)X 服从 N ( 12 , 4 ) N ( 12 , 4 ) N ( 12 , 4 ) F ( 10 ) F ( 10 ) F ( 10 )
F ( 10 ) = Φ ( 10 − 12 2 ) = Φ ( − 1 ) = 0.1587
F (10) = \Phi \left(\frac {10 - 12}{2}\right) = \Phi (- 1) = 0. 1587
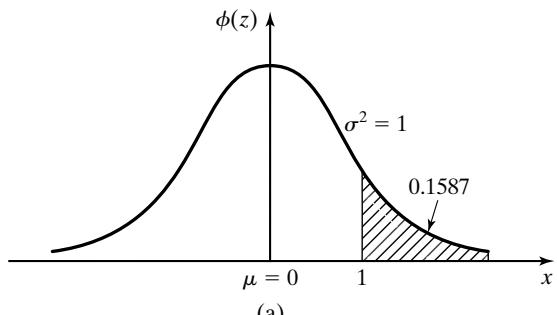
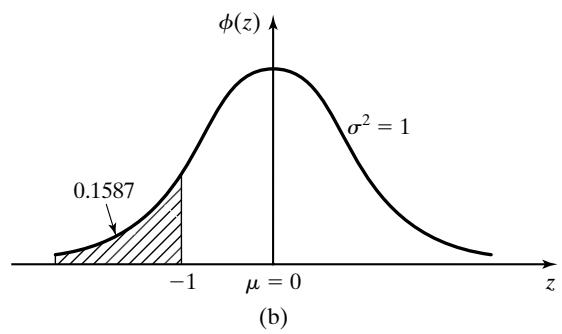
F ( 10 ) = Φ ( 2 10 − 12 ) = Φ ( − 1 ) = 0.1587 利用正态分布的对称性,可在表 A.3 中查得 Φ ( − 1 ) = 0.1587 \Phi ( - 1 ) = 0 . 1587 Φ ( − 1 ) = 0.1587 Φ ( 1 ) = 0.8413 \Phi ( 1 ) = 0 . 8413 Φ ( 1 ) = 0.8413 Φ ( − 1 ) = 1 − Φ ( 1 ) = 0.1587 \Phi ( - 1 ) = 1 - \Phi ( 1 ) = 0 . 1587 Φ ( − 1 ) = 1 − Φ ( 1 ) = 0.1587 Φ ( 2 ) = 0.9772 \Phi ( 2 ) = 0 . 9772 Φ ( 2 ) = 0.9772 Φ ( − 2 ) = 1 − Φ ( 2 ) = 0.0228 \Phi ( - 2 ) = 1 - \Phi ( 2 ) = 0 . 0228 Φ ( − 2 ) = 1 − Φ ( 2 ) = 0.0228 Φ ( − x ) = 1 − Φ ( x ) \Phi ( - x ) = 1 - \Phi ( x ) Φ ( − x ) = 1 − Φ ( x ) P ( X < 12 ) P ( X < 12 ) P ( X < 12 ) P ( X > 12 ) = 1 − F ( 12 ) P ( X \ > \ 12 ) \ = \ 1 - F ( 12 ) P ( X > 12 ) = 1 − F ( 12 ) F ( 12 ) = Φ ( 0 ) = 0.50 F ( 12 ) = \Phi ( 0 ) = 0 . 50 F ( 12 ) = Φ ( 0 ) = 0.50 P ( X > 12 ) = 1 − 0.50 = 0.50 P ( X \ > \ 12 ) \ = \ 1 - 0 . 50 \ = \ 0 . 50 P ( X > 12 ) = 1 − 0.50 = 0.50
图 15 利用正态分布的对称性。
图 16 通过观察求概率。
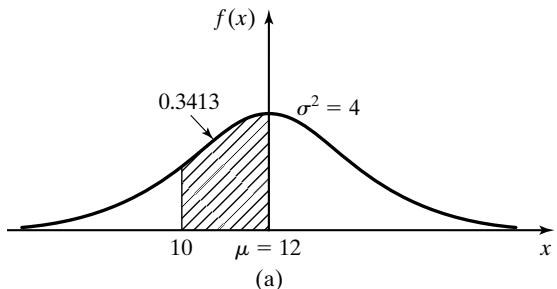
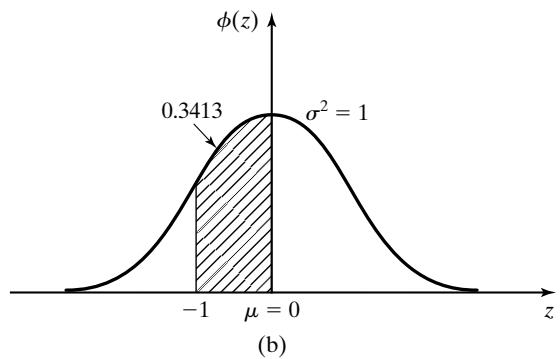
图 17 船舶装载问题的标准正态变换。
装载一条船所需时间在 10 小时到 12 小时之间的概率,利用本例前面给出的结果:
P ( 10 ≤ X ≤ 12 ) = F ( 12 ) − F ( 10 ) = 0.5000 − 0.1587 = 0.3413
P (10 \leq X \leq 12) = F (12) - F (10) = 0. 5000 - 0. 1587 = 0. 3413
P ( 10 ≤ X ≤ 12 ) = F ( 12 ) − F ( 10 ) = 0.5000 − 0.1587 = 0.3413 所求面积显示在图 17(a) 的阴影部分。以标准化正态分布表示的等价问题见图 17(b)。概率式为 F ( 12 ) − F ( 10 ) = Φ ( 0 ) − Φ ( − 1 ) = 0.5000 − 0.1587 = F ( 12 ) - F ( 10 ) = \Phi ( 0 ) - \Phi ( - 1 ) = 0 . 5000 - 0 . 1587 = F ( 12 ) − F ( 10 ) = Φ ( 0 ) − Φ ( − 1 ) = 0.5000 − 0.1587 =
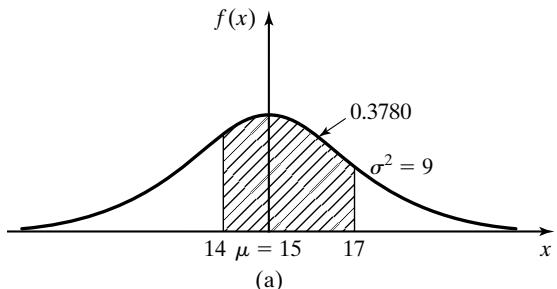
例 23 在某自助餐厅排队后开始自助服务所需的时间被发现服从 N ( 15 , 9 ) N ( 15 , 9 ) N ( 15 , 9 )
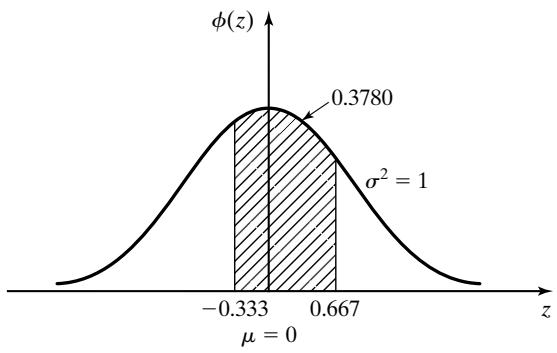
P ( 14 ≤ X ≤ 17 ) = F ( 17 ) − F ( 14 ) = Φ ( 17 − 15 3 ) − Φ ( 14 − 15 3 ) = Φ ( 0.667 ) − Φ ( − 0.333 )
\begin{array}{r l} P (14 \leq X \leq 17) & = F (17) - F (14) = \Phi \left(\frac {17 - 15}{3}\right) - \Phi \left(\frac {14 - 15}{3}\right) \\ & = \Phi (0. 667) - \Phi (- 0. 333) \end{array}
P ( 14 ≤ X ≤ 17 ) = F ( 17 ) − F ( 14 ) = Φ ( 3 17 − 15 ) − Φ ( 3 14 − 15 ) = Φ ( 0.667 ) − Φ ( − 0.333 ) 图 18(a) 中所示的阴影面积表示概率 F ( 17 ) − F ( 14 ) F ( 17 ) - F ( 14 ) F ( 17 ) − F ( 14 ) Φ ( 0.667 ) − Φ ( − 0.333 ) \Phi ( 0 . 667 ) \mathrm{~ - ~} \Phi ( - 0 . 333 ) Φ ( 0.667 ) − Φ ( − 0.333 ) Φ ( 0.667 ) = 0.7476 \Phi ( 0 . 667 ) \mathrm{~ = ~} 0 . 7476 Φ ( 0.667 ) = 0.7476 Φ ( − 0.333 ) = 1 − Φ ( 0.333 ) = 1 − 0.6304 = 0.3696 \Phi ( - 0 . 333 ) = 1 - \Phi ( 0 . 333 ) = 1 - 0 . 6304 = 0 . 3696 Φ ( − 0.333 ) = 1 − Φ ( 0.333 ) = 1 − 0.6304 = 0.3696 ( 0.667 ) − Φ ( − 0.333 ) = 0.3780 ( 0 . 667 ) - \Phi ( - 0 . 333 ) = 0 . 3780 ( 0.667 ) − Φ ( − 0.333 ) = 0.3780
图 18 自助餐厅问题的标准正态变换。
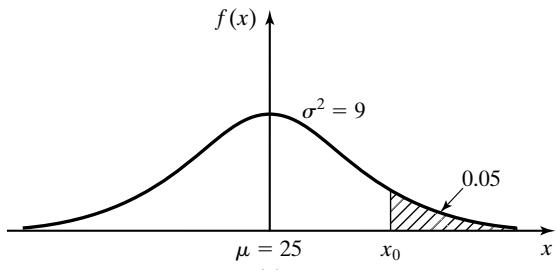
例 24 某项物品的提前期需求 X 近似服从均值为 25、方差为 9 的正态分布。希望计算提前期数值,使得超出该值的概率仅为 5%。因此,问题就是求 x 0 x_{0} x 0 P ( X > x 0 ) = 0.05 P ( X > x_{0} ) = 0 . 05 P ( X > x 0 ) = 0.05
P ( X > x 0 ) = P ( Z > x 0 − 25 3 ) = 1 − Φ ( x 0 − 25 3 ) = 0.05
P (X > x_{0}) = P \left(Z > \frac {x_{0} - 25}{3}\right) = 1 - \Phi \left(\frac {x_{0} - 25}{3}\right) = 0. 05
P ( X > x 0 ) = P ( Z > 3 x 0 − 25 ) = 1 − Φ ( 3 x 0 − 25 ) = 0.05 或者等价地,
Φ ( x 0 − 25 3 ) = 0.95
\Phi \left(\frac {x_{0} - 25}{3}\right) = 0. 95
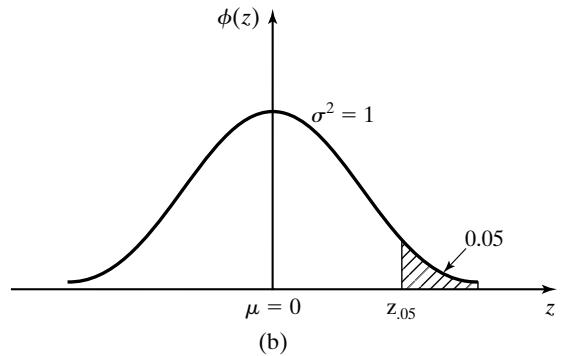
Φ ( 3 x 0 − 25 ) = 0.95 由表 A.3 可以看出 (1.645) 对应 0.95。于是,x 0 x_{0} x 0
x 0 − 25 3 = 1.645
\frac {x_{0} - 25}{3} = 1. 645
3 x 0 − 25 = 1.645 得到
x 0 = 29.935
x_{0} = 29. 935
x 0 = 29.935 因此,如果当库存水平降到 30 时发出采购订单,则提前期内需求超出可用库存的情形仅占 5%。
图 19 求提前期需求问题中的 x 0 x_{0} x 0
4.6 Weibull 分布 如果随机变量 X 的 pdf 具有下述形式,则称 X 服从 Weibull 分布:
f ( x ) = { β α ( x − ν α ) β − 1 exp [ − ( x − ν α ) β ] , x ≥ ν 0 , otherwise (46)
f (x) = \left\{\begin{array}{l l} \frac {\beta}{\alpha} \left(\frac {x - \nu}{\alpha}\right) ^ {\beta - 1} \exp \left[ - \left(\frac {x - \nu}{\alpha}\right) ^ {\beta} \right], & x \geq \nu \\ 0, & \text{otherwise} \end{array} \right.\tag{46}
f ( x ) = { α β ( α x − ν ) β − 1 exp [ − ( α x − ν ) β ] , 0 , x ≥ ν otherwise ( 46 ) Weibull 分布的三个参数为:ν( − ∞ < ν < ∞ ) ( - \infty < \nu < \infty ) ( − ∞ < ν < ∞ ) ( α > 0 ) ( \alpha > 0 ) ( α > 0 ) β ( β > 0 ) \beta \left( \beta > 0 \right) β ( β > 0 ) ν = 0 \nu = 0 ν = 0
f ( x ) = { β α ( x α ) β − 1 exp [ − ( x α ) β ] , x ≥ 0 0 , otherwise (47)
f (x) = \left\{\begin{array}{l l} \frac {\beta}{\alpha} \left(\frac {x}{\alpha}\right) ^ {\beta - 1} \exp \left[ - \left(\frac {x}{\alpha}\right) ^ {\beta} \right], & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.\tag{47}
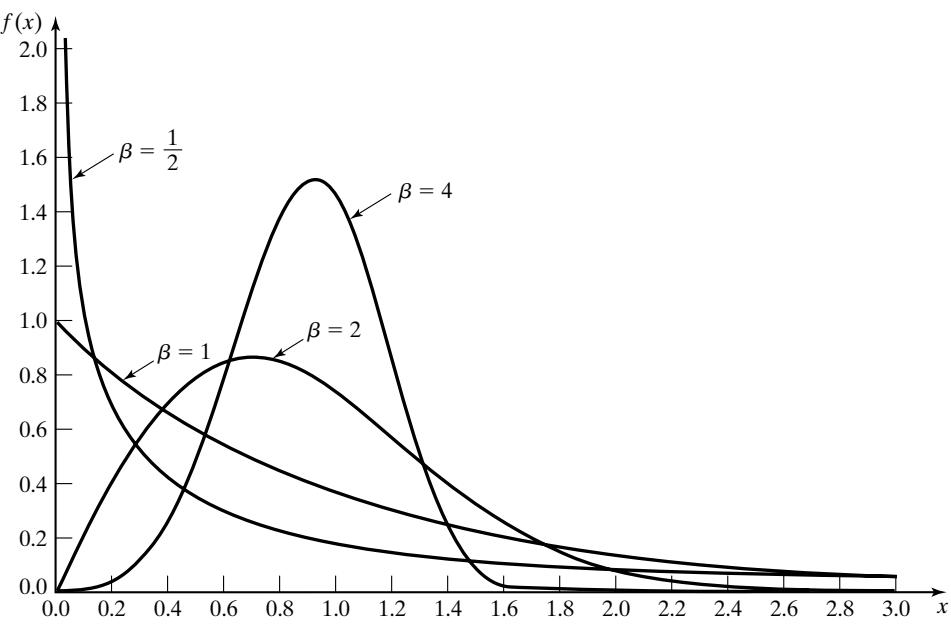
f ( x ) = { α β ( α x ) β − 1 exp [ − ( α x ) β ] , 0 , x ≥ 0 otherwise ( 47 ) 图 20 ν = 0;α = 1;β = 1/2, 1, 2, 4 时的 Weibull pdf。
图 20 给出了 ν = 0 \nu = 0 ν = 0 α = 1 \alpha = 1 α = 1 β = 1 \beta = 1 β = 1
f ( x ) = { 1 α e − x / α , x ≥ 0 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {1}{\alpha} e^{- x / \alpha}, & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = { α 1 e − x / α , 0 , x ≥ 0 otherwise 这就是参数为 λ = 1 / α \lambda = 1 / \alpha λ = 1/ α
E ( X ) = ν + α Γ ( 1 β + 1 ) (48)
E (X) = \nu + \alpha \Gamma \left(\frac {1}{\beta} + 1\right)\tag{48}
E ( X ) = ν + α Γ ( β 1 + 1 ) ( 48 ) V ( X ) = α 2 [ Γ ( 2 β + 1 ) − [ Γ ( 1 β + 1 ) ] 2 ] (49)
V (X) = \alpha^{2} \left[ \Gamma \left(\frac {2}{\beta} + 1\right) - \left[ \Gamma \left(\frac {1}{\beta} + 1\right) \right] ^ {2} \right]\tag{49}
V ( X ) = α 2 [ Γ ( β 2 + 1 ) − [ Γ ( β 1 + 1 ) ] 2 ] ( 49 ) 其中 Γ ( ⋅ ) \Gamma ( \cdot ) Γ ( ⋅ )
F ( x ) = { 0 , x < ν 1 − exp [ − ( x − ν α ) β ] , x ≥ ν (50)
F (x) = \left\{\begin{array}{l l} 0, & x < \nu \\ 1 - \exp \left[ - \left(\frac {x - \nu}{\alpha}\right) ^ {\beta} \right], & x \geq \nu \end{array} \right.\tag{50}
F ( x ) = { 0 , 1 − exp [ − ( α x − ν ) β ] , x < ν x ≥ ν ( 50 ) 例 25 已知某部件的故障时间服从 Weibull 分布,其中 ν = 0 , α = 200 h o u r s \nu = 0 , \alpha = 200 \mathrm{hours} ν = 0 , α = 200 hours β = 1 / 3 \beta = 1 / 3 β = 1/3
E ( X ) = 200 Γ ( 3 + 1 ) = 200 ( 3 ! ) = 1200 hours
E (X) = 200 \Gamma (3 + 1) = 200 (3!) = 1200 \text{hours}
E ( X ) = 200Γ ( 3 + 1 ) = 200 ( 3 !) = 1200 hours 某个单元在 2000 小时之前发生故障的概率由式 (50) 计算:
F ( 2000 ) = 1 − exp [ − ( 2000 200 ) 1 / 3 ] = 1 − e − 3 10 = 1 − e − 2.15 = 0.884
\begin{array}{r l} F (2000) & = 1 - \exp \left[ - \left(\frac {2000}{200}\right) ^ {1 / 3} \right] \\ & = 1 - e ^ {- 3 \sqrt {10}} = 1 - e^{- 2. 15} = 0. 884 \end{array}
F ( 2000 ) = 1 − exp [ − ( 200 2000 ) 1/3 ] = 1 − e − 3 10 = 1 − e − 2.15 = 0.884 例 26 某大型国际机场中,飞机着陆并脱离跑道所需的时间服从 Weibull 分布,其中 ν = 1.34 \nu = 1 . 34 ν = 1.34 α = 0.04 \alpha = 0 . 04 α = 0.04 β = 0.5 \beta = 0 . 5 β = 0.5 P ( X > 1.5 ) P ( X > 1 . 5 ) P ( X > 1.5 )
P ( X ≤ 1.5 ) = F ( 1.5 ) = 1 − exp [ − ( 1.5 − 1.34 0.04 ) 0.5 ] = 1 − e − 2 = 1 − 0.135 = 0.865
\begin{array}{r l} P (X \leq 1. 5) & = F (1. 5) \\ & = 1 - \exp \left[ - \left(\frac {1 . 5 - 1 . 34}{0 . 04}\right) ^ {0. 5} \right] \\ & = 1 - e^{- 2} = 1 - 0. 135 = 0. 865 \end{array}
P ( X ≤ 1.5 ) = F ( 1.5 ) = 1 − exp [ − ( 0.04 1.5 − 1.34 ) 0.5 ] = 1 − e − 2 = 1 − 0.135 = 0.865 因此,飞机着陆并脱离跑道需要 1.5 分钟以上的概率为 0.135。
4.7 三角分布 如果随机变量 X 的 pdf 为下式,则称 X 服从三角分布:
f ( x ) = { 2 ( x − a ) ( b − a ) ( c − a ) , a ≤ x ≤ b 2 ( c − x ) ( c − b ) ( c − a ) , b < x ≤ c 0 , elsewhere (51)
f (x) = \left\{\begin{array}{l l} \frac {2 (x - a)}{(b - a) (c - a)}, & a \leq x \leq b \\ \frac {2 (c - x)}{(c - b) (c - a)}, & b < x \leq c \\ 0, & \text{elsewhere} \end{array} \right.\tag{51}
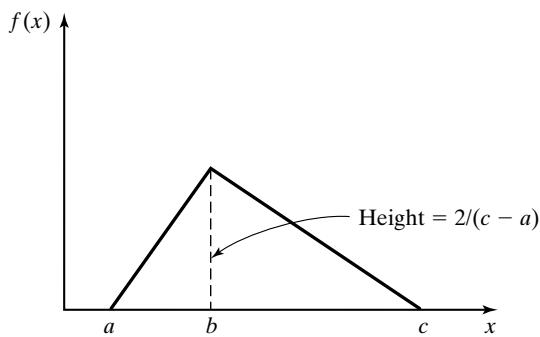
f ( x ) = ⎩ ⎨ ⎧ ( b − a ) ( c − a ) 2 ( x − a ) , ( c − b ) ( c − a ) 2 ( c − x ) , 0 , a ≤ x ≤ b b < x ≤ c elsewhere ( 51 ) 其中 a ≤ b ≤ c a \leq b \leq c a ≤ b ≤ c x = b x = b x = b ( a , b , c ) ( a , b , c ) ( a , b , c )
E ( X ) = a + b + c 3 (52)
E (X) = \frac {a + b + c}{3}\tag{52}
E ( X ) = 3 a + b + c ( 52 ) 图 21 三角分布的 pdf。
由式 (52) 可以确定众数:
Mode = b = 3 E ( X ) − ( a + c ) (53)
\text{Mode} = b = 3 E (X) - (a + c)\tag{53}
Mode = b = 3 E ( X ) − ( a + c ) ( 53 ) 因为 a ≤ b ≤ c a \leq b \leq c a ≤ b ≤ c
2 a + c 3 ≤ E ( X ) ≤ a + 2 c 3
\frac {2 a + c}{3} \leq E (X) \leq \frac {a + 2 c}{3}
3 2 a + c ≤ E ( X ) ≤ 3 a + 2 c 在刻画三角分布时,众数比均值用得更多。如图 21 所示,其在 x 轴之上的高度为 2 / ( c − a ) 2 / ( c - a ) 2/ ( c − a ) V ( X ) V ( X ) V ( X )
F ( x ) = { 0 , x ≤ a ( x − a ) 2 ( b − a ) ( c − a ) , a < x ≤ b 1 − ( c − x ) 2 ( c − b ) ( c − a ) , b < x ≤ c 1 , x > c (54)
F (x) = \left\{\begin{array}{l l} 0, & x \leq a \\ \frac {(x - a) ^ {2}}{(b - a) (c - a)}, & a < x \leq b \\ 1 - \frac {(c - x) ^ {2}}{(c - b) (c - a)}, & b < x \leq c \\ 1, & x > c \end{array} \right.\tag{54}
F ( x ) = ⎩ ⎨ ⎧ 0 , ( b − a ) ( c − a ) ( x − a ) 2 , 1 − ( c − b ) ( c − a ) ( c − x ) 2 , 1 , x ≤ a a < x ≤ b b < x ≤ c x > c ( 54 ) 例 27 将要执行的程序对中央处理器(CPU)时间的需求服从三角分布,其中 a = 0.05 a = 0 . 05 a = 0.05 b = 1.1 b = 1 . 1 b = 1.1 c = 6.5 c = 6 . 5 c = 6.5
F ( 2.5 ) = 1 − ( 6.5 − 2.5 ) 2 ( 6.5 − 0.05 ) ( 6.5 − 1.1 ) = 0.541
F (2. 5) = 1 - \frac {(6 . 5 - 2 . 5) ^ {2}}{(6 . 5 - 0 . 05) (6 . 5 - 1 . 1)} = 0. 541
F ( 2.5 ) = 1 − ( 6.5 − 0.05 ) ( 6.5 − 1.1 ) ( 6.5 − 2.5 ) 2 = 0.541 因此,CPU 需求为 2.5 毫秒或更小的概率为 0.541。
例 28 某电子传感器用于评估存储芯片的质量,对不合格品予以剔除。应要求时,该传感器会给出过去 24 小时内每生产小时内的最少和最多剔除数,同时也给出均值。在没有进一步信息的情况下,质量控制部门假定被剔除芯片的数量可用三角分布近似。当前数据导出表明,任意小时内被剔除芯片的最少数为 0,最多数为 10,均值为 4。已知 a = 0 , c = 10. a = 0 , c = 10 . a = 0 , c = 10. E ( X ) = 4 , E ( X ) = 4 , E ( X ) = 4 ,
b = 3 ( 4 ) − ( 0 + 10 ) = 2
b = 3 (4) - (0 + 10) = 2
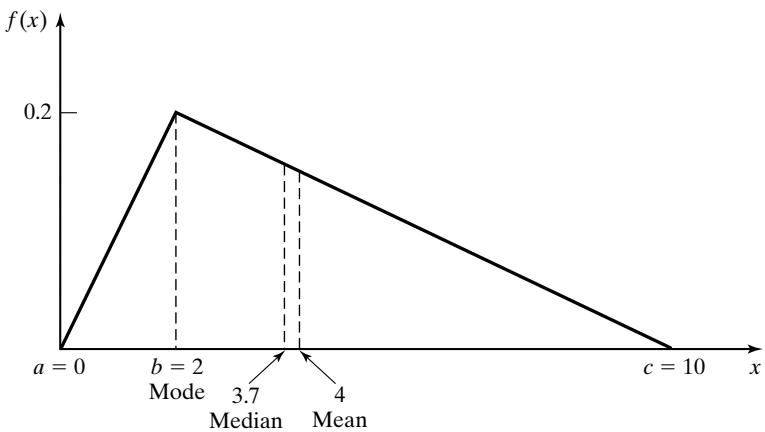
b = 3 ( 4 ) − ( 0 + 10 ) = 2 众数处的高度为 2 / ( 10 − 0 ) = 0.2 2 / ( 10 - 0 ) = 0 . 2 2/ ( 10 − 0 ) = 0.2
中位数是这样的点:其左侧面积为 0.5,右侧面积也为 0.5。本例中的中位数为 3.7,也标在图 22 上。求三角分布的中位数,需要先确定该值位于众数的左侧还是右侧。众数左侧的面积由式 (54) 算得:
F ( 2 ) = 2 2 20 = 0.2
F (2) = \frac {2^{2}}{20} = 0. 2
F ( 2 ) = 20 2 2 = 0.2 因此,中位数位于 b 与 c 之间。在式 (54) 中令 F ( x ) = 0.5 F ( x ) = 0 . 5 F ( x ) = 0.5
0.5 = 1 − ( 10 − x ) 2 ( 10 ) ( 8 )
0. 5 = 1 - \frac {(10 - x) ^ {2}}{(10) (8)}
0.5 = 1 − ( 10 ) ( 8 ) ( 10 − x ) 2 其中
x = 3.7
x = 3. 7
x = 3.7 本例清楚地表明,均值、众数和中位数并不一定相等。
图 22 三角分布的众数、中位数与均值。
4.8 对数正态分布 如果随机变量 X 的 pdf 为下式,则称 X 服从对数正态分布:
f ( x ) = { 1 2 π σ x exp [ − ( ln x − μ ) 2 2 σ 2 ] , x > 0 0 , otherwise (55)
f (x) = \left\{\begin{array}{l l} \frac {1}{\sqrt {2 \pi} \sigma x} \exp \left[ - \frac {(\ln x - \mu) ^ {2}}{2 \sigma^{2}} \right], & x > 0 \\ 0, & \text{otherwise} \end{array} \right.\tag{55}
f ( x ) = { 2 π σ x 1 exp [ − 2 σ 2 ( l n x − μ ) 2 ] , 0 , x > 0 otherwise ( 55 ) 其中 σ 2 > 0 \sigma^{2} > 0 σ 2 > 0
E ( X ) = e μ + σ 2 / 2 (56)
E (X) = e ^ {\mu + \sigma^{2} / 2}\tag{56}
E ( X ) = e μ + σ 2 /2 ( 56 ) V ( X ) = e 2 μ + σ 2 ( e σ 2 − 1 ) (57)
V (X) = e ^ {2 \mu + \sigma^{2}} (e ^ {\sigma^{2}} - 1)\tag{57}
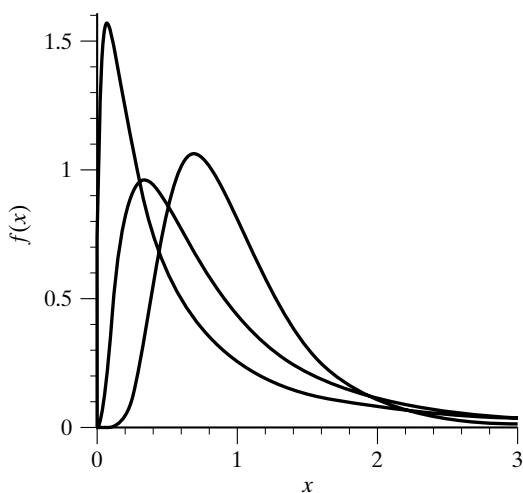
V ( X ) = e 2 μ + σ 2 ( e σ 2 − 1 ) ( 57 ) 图 23 给出了三个对数正态 pdf,它们的均值均为 1,方差分别为 1 / 2 , 1 / 2 , 1/2 ,
注意,参数 μ \mu μ σ 2 \sigma^{2} σ 2 N ( μ , σ 2 ) N ( \mu , \sigma^{2} ) N ( μ , σ 2 ) X = e Y X = e^{Y} X = e Y μ \mu μ σ 2 \sigma^{2} σ 2 μ L \mu_{L} μ L σ L 2 . \sigma_{L} ^ {2} . σ L 2 . μ \mu μ σ 2 \sigma^{2} σ 2
μ = ln ( μ L 2 μ L 2 + σ L 2 ) (58)
\mu = \ln \left(\frac {\mu_{L} ^ {2}}{\sqrt {\mu_{L} ^ {2} + \sigma_{L} ^ {2}}}\right)\tag{58}
μ = ln ( μ L 2 + σ L 2 μ L 2 ) ( 58 ) σ 2 = ln ( μ L 2 + σ L 2 μ L 2 ) (59)
\sigma^{2} = \ln \left(\frac {\mu_{L} ^ {2} + \sigma_{L} ^ {2}}{\mu_{L} ^ {2}}\right)\tag{59}
σ 2 = ln ( μ L 2 μ L 2 + σ L 2 ) ( 59 ) 图 23 对数正态分布的 pdf。
例 29 某项高风险投资的收益率建模为服从对数正态分布,均值 20%,标准差 5%。计算该对数正态分布的参数。由已知信息,μ L = 20 \mu_{L} = 20 μ L = 20 σ L 2 = 5 2 \sigma_{L} ^ {2} = 5^{2} σ L 2 = 5 2
μ = ln ( 20 2 20 2 + 5 2 ) ≐ 2.9654
\mu = \ln \left(\frac {20^{2}}{\sqrt {20^{2} + 5^{2}}}\right) \doteq 2. 9654
μ = ln ( 2 0 2 + 5 2 2 0 2 ) ≐ 2.9654 σ 2 = ln ( 20 2 + 5 2 20 2 ) ≐ 0.06
\sigma^{2} = \ln \left(\frac {20^{2} + 5^{2}}{20^{2}}\right) \doteq 0. 06
σ 2 = ln ( 2 0 2 2 0 2 + 5 2 ) ≐ 0.06 4.9 贝塔分布 如果随机变量 X 的 pdf 为下式,其中参数 β 1 > 0 \beta_{1} > 0 β 1 > 0 β 2 > 0 \beta_{2} > 0 β 2 > 0
f ( x ) = { x β 1 − 1 ( 1 − x ) β 2 − 1 B ( β 1 , β 2 ) , 0 < x < 1 0 , otherwise (60)
f (x) = \left\{\begin{array}{l l} \frac {x ^ {\beta_{1} - 1} (1 - x) ^ {\beta_{2} - 1}}{B (\beta_{1} , \beta_{2})}, & 0 < x < 1 \\ 0, & \text{otherwise} \end{array} \right.\tag{60}
f ( x ) = { B ( β 1 , β 2 ) x β 1 − 1 ( 1 − x ) β 2 − 1 , 0 , 0 < x < 1 otherwise ( 60 ) 其中 B ( β 1 , β 2 ) = Γ ( β 1 ) Γ ( β 2 ) / Γ ( β 1 + β 2 ) B (\beta_{1} , \beta_{2}) = \Gamma ( \beta_{1} ) \Gamma ( \beta_{2} ) / \Gamma ( \beta_{1} + \beta_{2} ) B ( β 1 , β 2 ) = Γ ( β 1 ) Γ ( β 2 ) /Γ ( β 1 + β 2 )
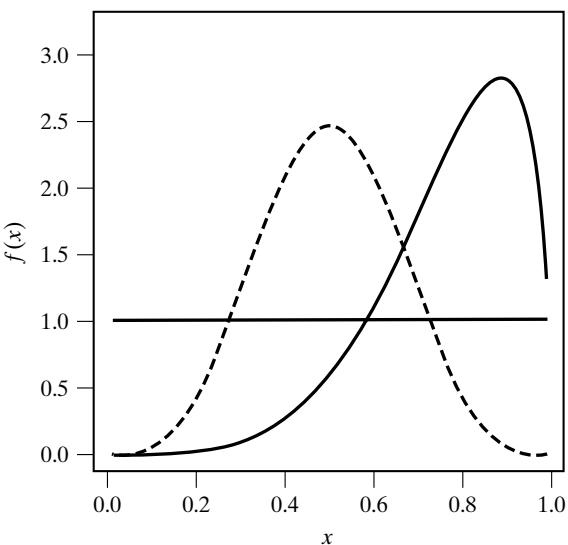
贝塔分布非常灵活,取值范围有限,为 0 到 1,如图 24 所示。在实践中,我们常常需要一个定义在另一个范围(例如 ( a , b ) ( a , b ) ( a , b ) a < b a < b a < b
Y = a + ( b − a ) X
Y = a + (b - a) X
Y = a + ( b − a ) X Y 的均值和方差为
a + ( b − a ) ( β 1 β 1 + β 2 ) (61)
a + (b - a) \left(\frac {\beta_{1}}{\beta_{1} + \beta_{2}}\right)\tag{61}
a + ( b − a ) ( β 1 + β 2 β 1 ) ( 61 ) 以及
( b − a ) 2 ( β 1 β 2 ( β 1 + β 2 ) 2 ( β 1 + β 2 + 1 ) ) (62)
(b - a) ^ {2} \left(\frac {\beta_{1} \beta_{2}}{(\beta_{1} + \beta_{2}) ^ {2} (\beta_{1} + \beta_{2} + 1)}\right)\tag{62}
( b − a ) 2 ( ( β 1 + β 2 ) 2 ( β 1 + β 2 + 1 ) β 1 β 2 ) ( 62 ) 图 24 若干贝塔分布的 pdf。
5 泊松过程 考虑诸如作业到达作业车间、电子邮件到达邮件服务器、船只到达码头、来电到达呼叫中心、大型工厂中机器故障等随机事件。这些事件可以用对所有 t ≥ 0 t \geq 0 t ≥ 0 N ( t ) N ( t ) N ( t ) [ 0 , t ] . [ 0 , t ] . [ 0 , t ] . N ( t ) N ( t ) N ( t ) 0 , 1 , 2 , … 0 , 1 , 2 , \ldots 0 , 1 , 2 , … { N ( t ) , t ≥ 0 } \{N ( t ) , t \ge 0 \} { N ( t ) , t ≥ 0 }
a. 到达一次一个地发生。
b. { N ( t ) , t ≥ 0 } \{N ( t ) , t \ge 0 \} { N ( t ) , t ≥ 0 } t + s t + s t + s
c. { N ( t ) , t ≥ 0 } \{N ( t ) , t \ge 0 \} { N ( t ) , t ≥ 0 }
如果到达按照满足上述三个假设的泊松过程发生,可以证明 N ( t ) N ( t ) N ( t )
P [ N ( t ) = n ] = e − λ t ( λ t ) n n ! for t ≥ 0 and n = 0 , 1 , 2 , … (63)
P [ N (t) = n ] = \frac {e^{- \lambda t} (\lambda t) ^ {n}}{n !} \quad \text{for} t \geq 0 \text{and} n = 0, 1, 2, \dots\tag{63}
P [ N ( t ) = n ] = n ! e − λ t ( λ t ) n for t ≥ 0 and n = 0 , 1 , 2 , … ( 63 ) 将式 (63) 与式 (19) 比较可以看出,N ( t ) N ( t ) N ( t ) α = λ t \alpha = \lambda t α = λ t
E [ N ( t ) ] = α = λ t = V [ N ( t ) ]
E [ N (t) ] = \alpha = \lambda t = V [ N (t) ]
E [ N ( t )] = α = λ t = V [ N ( t )] 对于任何满足 s < t s < t s < t N ( t ) − N ( s ) N ( t ) - N ( s ) N ( t ) − N ( s ) λ ( t − s ) \lambda ( t - s ) λ ( t − s )
P [ N ( t ) − N ( s ) = n ] = e − λ ( t − s ) [ λ ( t − s ) ] n n ! for n = 0 , 1 , 2 , …
P [ N (t) - N (s) = n ] = \frac {e^{- \lambda (t - s)} [ \lambda (t - s) ] ^ {n}}{n !} \quad \text{for} n = 0, 1, 2, \dots
P [ N ( t ) − N ( s ) = n ] = n ! e − λ ( t − s ) [ λ ( t − s ) ] n for n = 0 , 1 , 2 , … 以及
E [ N ( t ) − N ( s ) ] = λ ( t − s ) = V [ N ( t ) − N ( s ) ]
E [ N (t) - N (s) ] = \lambda (t - s) = V [ N (t) - N (s) ]
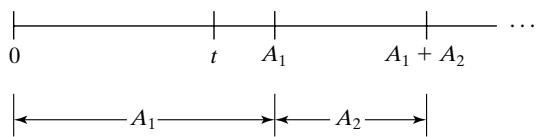
E [ N ( t ) − N ( s )] = λ ( t − s ) = V [ N ( t ) − N ( s )] 现在,考虑泊松过程中到达发生的时间。设第一次到达发生在时刻 A 1 A_{1} A 1 A 1 + A 2 A_{1} + A_{2} A 1 + A 2
图 25 到达过程。
于是,A 1 , A 2 , … A_{1} , A_{2} , \ldots A 1 , A 2 , …
{ A 1 > t } = { N ( t ) = 0 }
\{A_{1} > t \} = \{N (t) = 0 \}
{ A 1 > t } = { N ( t ) = 0 } 因此,
P ( A 1 > t ) = P [ N ( t ) = 0 ] = e − λ t
P (A_{1} > t) = P [ N (t) = 0 ] = e^{- \lambda t}
P ( A 1 > t ) = P [ N ( t ) = 0 ] = e − λ t 最后一个等号由式 (63) 得出。于是,第一次到达发生在 [0, t] 内的概率为
P ( A 1 ≤ t ) = 1 − e − λ t
P (A_{1} \leq t) = 1 - e^{- \lambda t}
P ( A 1 ≤ t ) = 1 − e − λ t 这正是参数为 λ 的指数分布的 cdf。因此,A 1 A_{1} A 1 E ( A 1 ) = 1 / λ E ( A_{1} ) = 1 / \lambda E ( A 1 ) = 1/ λ A 1 , A 2 , … , A_{1} , A_{2} , \ldots , A 1 , A 2 , … , 1 / λ 1 / \lambda 1/ λ N ( t ) N ( t ) N ( t )
回顾一下,指数分布具有无记忆性——即在长度为 s 的时间区间内发生未来到达的概率与上一次到达的时刻无关。到达的概率只取决于时间区间长度 s。因此,无记忆性与泊松过程的独立增量和平稳增量性质是相关的。
关于泊松过程的更多阅读材料可从许多来源获得,包括 Parzen [1999]、Feller [1968] 和 Ross [2002]。
例 30 某机械加工车间的作业按照均值为每小时 λ = 2 \lambda = 2 λ = 2
E ( A ) = 1 / λ = 1 2
E (A) = 1 / \lambda = \frac {1} {2}
E ( A ) = 1/ λ = 2 1 小时。
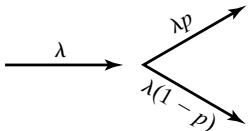
5.1 泊松过程的性质 Ross [2002] 等人讨论的泊松过程的若干性质,在离散系统仿真中很有用。其中第一个性质涉及随机分裂。考虑一个具有速率 λ 的泊松过程 { N ( t ) , t ≥ 0 } \{N ( t ) , t \ge 0 \} { N ( t ) , t ≥ 0 }
假设每次事件发生时,都把它归类为 I 型事件或 II 型事件。再假设每个事件被归类为 I 型事件的概率为 p p p 1 − p . 1 - p . 1 − p .
设 N 1 ( t ) N_{1} ( t ) N 1 ( t ) N 2 ( t ) N_{2} ( t ) N 2 ( t ) N ( t ) = N 1 ( t ) + N 2 ( t ) N ( t ) = N_{1} ( t ) + N_{2} ( t ) N ( t ) = N 1 ( t ) + N 2 ( t ) N 1 ( t ) N_{1} ( t ) N 1 ( t ) N 2 ( t ) N_{2} ( t ) N 2 ( t ) λ p \lambda p λ p λ ( 1 − p ) \lambda ( 1 - p ) λ ( 1 − p )
图 26 随机分裂。
例 31:随机分裂 假设作业按照速率为 λ 的泊松过程到达某车间。再假设每次到达以 1/3 的概率被标记为"高优先级”,以 2/3 的概率被标记为"低优先级”。那么 I 型事件对应高优先级到达,II 型事件对应低优先级到达。若 N 1 ( t ) N_{1} ( t ) N 1 ( t ) N 2 ( t ) N_{2} ( t ) N 2 ( t ) λ / 3 \lambda / 3 λ /3 2 λ / 3 , 2 \lambda / 3 , 2 λ /3 ,
例 32 例 31 中的速率为每小时 λ = 3 \lambda = 3 λ = 3 α = λ p t = 2 \alpha = \lambda p t = 2 α = λ pt = 2
P ( 0 ) = e − 2 2 0 0 ! = 0.135
P (0) = \frac {e^{- 2} 2^{0}}{0 !} = 0. 135
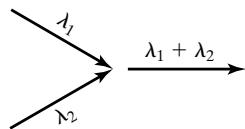
P ( 0 ) = 0 ! e − 2 2 0 = 0.135 现在考虑与随机分裂相反的情形,即两股到达流的合并。所关注的过程见图 27。可以证明,若 N i ( t ) N_{i} ( t ) N i ( t ) λ i . \lambda_{i} . λ i . i = 1 i = 1 i = 1 N ( t ) = N 1 ( t ) + N 2 ( t ) N ( t ) = N _ {1} ( t ) + N _ {2} ( t ) N ( t ) = N 1 ( t ) + N 2 ( t ) λ 1 + λ 2 \lambda_{1} + \lambda_{2} λ 1 + λ 2
图 27 合并过程。
例 33:合并过程 一个速率为每小时 λ 1 = 10 \lambda_{1} = 10 λ 1 = 10 λ 2 = 17 \lambda_{2} ~ = ~ 17 λ 2 = 17 λ = 27 \lambda = 27 λ = 27
5.2 非平稳泊松过程 如果保留泊松假设 1 和 3(第 5 节),但去掉假设 2(平稳增量),就得到非平稳泊松过程(NSPP),它由 λ ( t ) \lambda ( t ) λ ( t )
处理 NSPP 的关键在于截至时刻 t 的期望到达数,记作
Λ ( t ) = ∫ 0 t λ ( s ) d s
\Lambda (t) = \int_{0} ^ {t} \lambda (s) d s
Λ ( t ) = ∫ 0 t λ ( s ) d s 要能作为到达率函数,λ(t) 必须非负且可积。对于速率为 λ 的平稳泊松过程,我们有 Λ ( t ) = λ t , \Lambda ( t ) = \lambda t , Λ ( t ) = λ t ,
设 T 1 , T 2 , … T_{1} , T_{2} , \ldots T 1 , T 2 , … λ = 1 \lambda = 1 λ = 1 N ( t ) N ( t ) N ( t ) T 1 , T 2 , … \mathcal {T} _ {1} , \mathcal {T} _ {2} , \ldots T 1 , T 2 , … λ ( t ) \lambda ( t ) λ ( t ) N ( t ) \mathcal {N} ( t ) N ( t )
T i = Λ ( T i ) T i = Λ − 1 ( T i )
\begin{array}{l} {T_{i} = \Lambda (\mathcal {T} _ {i})} \\ {\mathcal {T} _ {i} = \Lambda^{- 1} (T_{i})} \end{array}
T i = Λ ( T i ) T i = Λ − 1 ( T i ) 换句话说,NSPP 可以被变换为到达率为 1 的平稳泊松过程,而到达率为 1 的平稳泊松过程也可以被变换为到达率为 λ(t) 的 NSPP,两种情形下的变换都与 Λ ( t ) \Lambda ( t ) Λ ( t )
例 34 假设某邮局从上午 8 点到中午 12 点的到达率为每分钟 2 件,此后降到每 2 分钟 1 件,直到当天下午 4 点结束营业。求上午 11 点到下午 2 点之间到达件数的概率分布。
令时刻 t = 0 t = 0 t = 0 N ( t ) \mathcal {N} ( t ) N ( t )
λ ( t ) = { 2 , 0 ≤ t < 4 1 2 , 4 ≤ t ≤ 8
\lambda (t) = \left\{\begin{array}{l l} 2, & 0 \leq t < 4 \\ \frac {1}{2}, & 4 \leq t \leq 8 \end{array} \right.
λ ( t ) = { 2 , 2 1 , 0 ≤ t < 4 4 ≤ t ≤ 8 因此,截至时刻 t 的期望到达数为
Λ ( t ) = { 2 t , 0 ≤ t < 4 t 2 + 6 , 4 ≤ t ≤ 8
\Lambda (t) = \left\{\begin{array}{l l} 2 t, & 0 \leq t < 4 \\ \frac {t}{2} + 6, & 4 \leq t \leq 8 \end{array} \right.
Λ ( t ) = { 2 t , 2 t + 6 , 0 ≤ t < 4 4 ≤ t ≤ 8 注意,计算 4 ≤ t ≤ 8 4 \leq t \leq 8 4 ≤ t ≤ 8
Λ ( t ) = ∫ 0 t λ ( s ) d s = ∫ 0 4 2 d s + ∫ 4 t 1 2 d s = t 2 + 6
\Lambda (t) = \int_{0} ^ {t} \lambda (s) d s = \int_{0} ^ {4} 2 d s + \int_{4} ^ {t} \frac {1}{2} d s = \frac {t}{2} + 6
Λ ( t ) = ∫ 0 t λ ( s ) d s = ∫ 0 4 2 d s + ∫ 4 t 2 1 d s = 2 t + 6 由于下午 2 点和上午 11 点分别对应时刻 6 和时刻 3,故有
P [ N ( 6 ) − N ( 3 ) = k ] = P [ N ( Λ ( 6 ) ) − N ( Λ ( 3 ) ) = k ] = P [ N ( 9 ) − N ( 6 ) = k ] = e 9 − 6 ( 9 − 6 ) k k ! = e 3 ( 3 ) k k !
\begin{array}{r l} P [ \mathcal {N} (6) - \mathcal {N} (3) = k ] & = P [ N (\Lambda (6)) - N (\Lambda (3)) = k ] \\ & = P [ N (9) - N (6) = k ] \\ & = \frac {e^{9 - 6} (9 - 6) ^ {k}}{k !} \\ & = \frac {e^{3} (3) ^ {k}}{k !} \end{array}
P [ N ( 6 ) − N ( 3 ) = k ] = P [ N ( Λ ( 6 )) − N ( Λ ( 3 )) = k ] = P [ N ( 9 ) − N ( 6 ) = k ] = k ! e 9 − 6 ( 9 − 6 ) k = k ! e 3 ( 3 ) k 其中 N ( t ) N ( t ) N ( t )
6 经验分布 经验分布(可以是离散形式,也可以是连续形式)是一种分布,其参数就是数据样本中的观测值。这与参数分布族(如指数分布、正态分布或泊松分布)形成对照,后者只需指定少数几个参数(如均值和方差)即可刻画。当不可能或没有必要确立某个随机变量具有特定的参数分布时,可以使用经验分布。经验分布的一个优点是,除样本中的观测值之外不作任何假设;但这同时也是一个缺点,因为样本可能并未覆盖全部可能的取值范围。
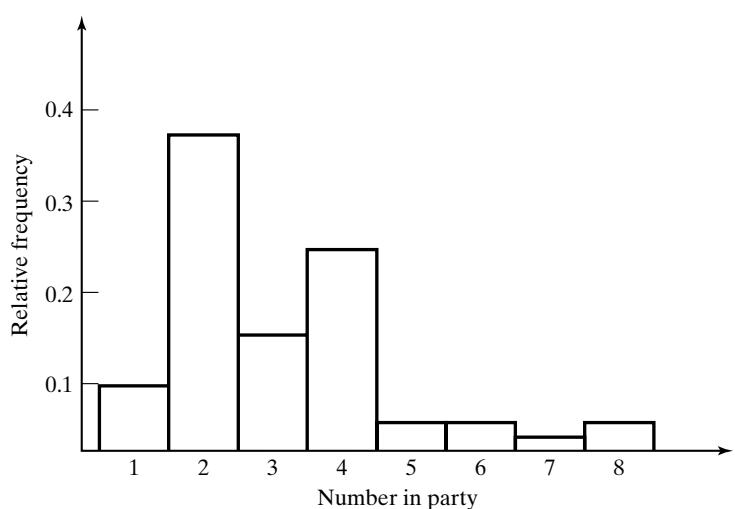
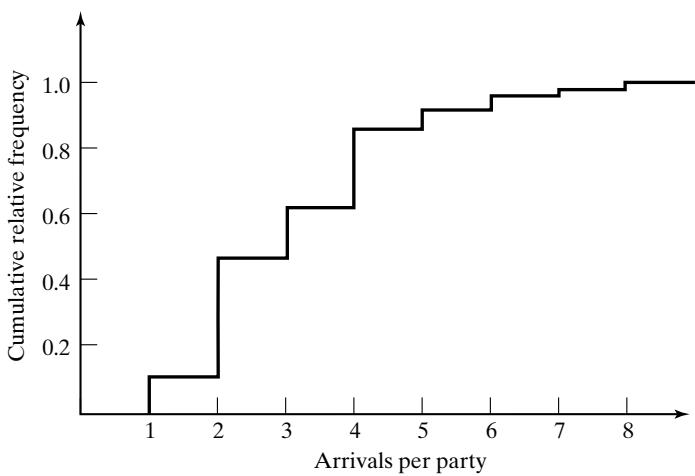
例 35:离散型 某本地餐厅的顾客在午餐时段以 1 至 8 人的小组形式到达。已经观测了最近 300 组中每组的人数;结果汇总于表 3。相对频数见表 3,也见图 28,该图给出了所收集数据的直方图。图 29 给出了数据的 cdf。图 29 中的 cdf 称为给定数据的经验分布。
表 3 每桌到达人数分布
图 28 每桌人数的直方图。
图 29 每桌人数的经验 cdf。
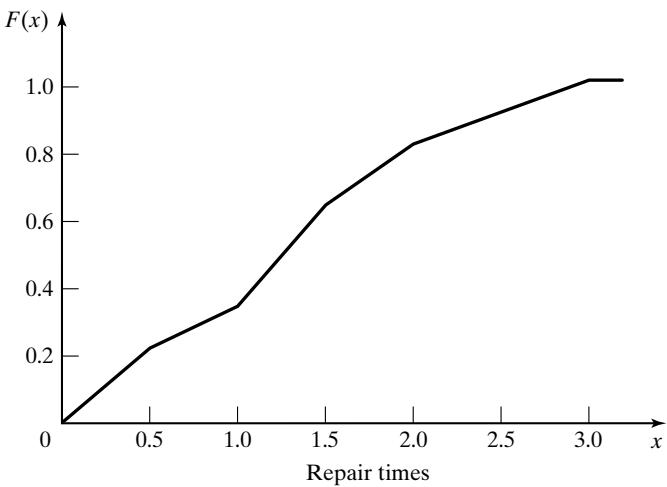
例 36:连续型 已经收集了最近 100 次输送系统发生故障后所需的修理时间;结果见表 4。其中有 21 次修理时间在 0 到 0.5 小时之间,依此类推。经验 cdf 见图 30。由形如 [x, F(x)] 的各点相连形成一条分段线性曲线。这些点以直线相连。第一对相连点是 (0, 0) 和 (0.5, 0.21);然后把点 (0.5, 0.21) 和 (1.0, 0.33) 相连;依此类推。
表 4 输送带的修理时间
图 30 修理时间的经验 cdf。
7 小结 在许多情形下,仿真分析人员所看到的世界是概率性的,而不是确定性的。本章的目的在于回顾若干重要的概率分布,使读者熟悉本书其余部分所用的记号,并展示概率分布在仿真情境下的应用。
仿真中的一项主要任务是输入数据的收集与分析。这项任务的首要步骤之一,是为输入数据假设一种分布形式。做法是把概率密度函数或概率质量函数的形状与数据的直方图作比较,并理解某些物理过程会产生特定的分布。(有专门的计算机软件可用来协助完成这项工作。)本章旨在强化对各种分布性质的理解,并加深对这些分布在实践中如何产生的认识。此外,输入数据的概率模型还用于在仿真中生成随机事件。
以下若干特征应当给读者留下深刻印象:离散分布、连续分布与经验分布之间的差异;泊松过程及其性质;以及伽马分布和 Weibull 分布的多才多艺。
参考文献 BANKS, J., AND R. G. HEIKES [1984], Handbook of Tables and Graphs for the Industrial Engineer and Manager, Reston Publishing, Reston, VA.
DEVORE, J. L. [1999], Probability and Statistics for Engineers and the Sciences, 5th ed., Brooks/Cole, Pacific Grove, CA.
FELLER, W. [1968], An Introduction to Probability Theory and Its Applications, Vol. I, 3d ed., Wiley, New York.
GORDON, G. [1975], The Application of GPSS V to Discrete System Simulation, Prentice-Hall, Englewood Cliffs, NJ.
HADLEY, G., AND T. M. WHITIN [1963], Analysis of Inventory Systems, Prentice-Hall, Englewood Cliffs, NJ.
HINES, W. W., AND D. C. MONTGOMERY [1990], Probability and Statistics in Engineering and Management Science, 3d ed., Wiley, New York.
LAW, A. M., AND W. D. KELTON [2000], Simulation Modeling & Analysis, 3d ed., McGraw-Hill, New York.
PAPOULIS, A. [1990], Probability and Statistics, Prentice Hall, Englewood Cliffs, NJ.
PARZEN, E. [1999], Stochastic Process, Classics in Applied Mathematics, 24, Society for Industrial & Applied Mathematics, Philadelphia, PA.
PEGDEN, C. D., R. E. SHANNON, AND R. P. SADOWSKI [1995], Introduction to Simulation Using SIMAN, 2d ed., McGraw-Hill, New York
ROSS, S. M. [2002], Introduction to Probability Models, 8th ed., Academic Press, New York.
WALPOLE, R. E., AND R. H. MYERS [2002], Probability and Statistics for Engineers and Scientists, 7th ed., Prentice Hall, Upper Saddle River, NJ.
习题 某生产工艺制造用于休闲船用舷外发动机的交流发电机。平均而言,在发动机总装厂检验时,有 1% 的交流发电机达不到所要求的标准。当工厂收到一大批交流发电机时,抽取 100 台进行检验;如果其中有两台以上不合格,则该批货物退回交流发电机制造商。求退货批次的概率。
已开发出一种能够延缓油漆火灾蔓延的工业化学品。当地销售代表根据以往经验估计,48% 的销售拜访会带来订单。
(a) 当天第一次订单出现在第四次销售拜访时的概率是多少?
(b) 如果一天进行八次销售拜访,恰好收到六份订单的概率是多少?
(c) 如果午餐前进行四次销售拜访,其中一次或更少带来订单的概率是多少?
最近的一项调查表明,82% 的 25 岁单身女性将在其一生中结婚。利用二项分布,求 20 人样本中有两名或三名女性终身未婚的概率。
Hawks 队目前胜率为 0.55。未来两周内有 5 场比赛。求他们胜场多于负场的概率。
Joe Coledge 是 Lower Alatoona 大学的第三替补四分卫。Joe 参加任何一场比赛的概率为 0.40。
(a) Joe 参加的第一场比赛是赛季第四场比赛的概率是多少?
(b) Joe 在前五场比赛中参加不超过两场的概率是多少?
对参数 λ = 1 \lambda = 1 λ = 1 X 1 X_{1} X 1 X 2 X_{2} X 2 P ( X 1 + X 2 > 2 ) P ( X_{1} + X_{2} > 2 ) P ( X 1 + X 2 > 2 )
证明几何分布具有无记忆性。
每年袭击佛罗里达海岸的飓风数量服从均值为 0.8 的泊松分布。
(a) 一年内有两场以上飓风袭击佛罗里达海岸的概率是多少?
(b) 一年内恰好有一场飓风袭击佛罗里达海岸的概率是多少?
银行柜员机(drive-through)窗口的到达服从速率为每分钟 1.2 的泊松分布。
(a) 下一分钟内零到达的概率是多少?
(b) 未来 2 分钟内零到达的概率是多少?
记录表明,某大型州立大学入学的学生中有 1.8% 在学期中退学。求从 200 名入学学生中随机抽取一组,其中三人或更少退学的概率。
Lane Braintwain 是一位相当受欢迎的学生。Lane 平均每晚接到四个电话(服从泊松分布)。求明晚接到的电话数比平均值超出超过一个标准差的概率。
冷凝机组(condenser units)的提前期需求服从均值为 6 台的泊松分布。为库存管理者编制一张表,列出达到以下保护水平所需的订货水平:50%、80%、90%、95%、97%、97.5%、99%、99.5% 和 99.9%。
若随机变量 X 在范围 R X = { 0 , 1 , 2 , … , n } R_{X} = \{0 , 1 , 2 , \ldots , n \} R X = { 0 , 1 , 2 , … , n } p ( x ) = 1 / ( n + 1 ) p ( x ) = 1 / ( n + 1 ) p ( x ) = 1/ ( n + 1 )
(a) 求该分布的均值和方差。提示:
∑ i = 1 n i = n ( n + 1 ) 2 and ∑ i = 1 n i 2 = n ( n + 1 ) ( 2 n + 1 ) 6
\sum_{i = 1} ^ {n} i = \frac {n (n + 1)}{2} \text{and} \sum_{i = 1} ^ {n} i^{2} = \frac {n (n + 1) (2 n + 1)}{6}
i = 1 ∑ n i = 2 n ( n + 1 ) and i = 1 ∑ n i 2 = 6 n ( n + 1 ) ( 2 n + 1 ) (b) 若 \(R_{X} = \{a , a + 1 , a + 2 , \ldots , b \}\),计算 X 的均值和方差。
一颗被送入轨道的卫星,其寿命(以年计)的 pdf 如下: f ( x ) = { 0.4 e − 0.4 x , x ≥ 0 0 , otherwise
f (x) = \left\{\begin{array}{l l} 0. 4 e^{- 0. 4 x}, & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = { 0.4 e − 0.4 x , 0 , x ≥ 0 otherwise (a) 这颗卫星在 5 年后仍"存活"的概率是多少?
(b) 该卫星在送入轨道后 3 年到 6 年之间失效的概率是多少?
一台大型计算机按照泊松过程发生崩溃,平均速率为每 36 小时崩溃一次。求在最后一次崩溃后 24 小时到 48 小时之间发生下一次崩溃的概率。
(当 n 很大而 p 很小时(例如 p 小于 0.1),可以用泊松分布来逼近二项分布。在使用泊松逼近时,令 λ = n p \lambda = n p λ = n p
对指数分布的随机变量 X,求满足下列关系的 λ 值:
P ( X ≤ 3 ) = 0.9 P ( X ≤ 4 )
P (X \leq 3) = 0. 9 P (X \leq 4)
P ( X ≤ 3 ) = 0.9 P ( X ≤ 4 ) 某工业场地的意外事故一次一个地、相互独立且完全随机地发生,平均速率为每周一起。求未来三周内没有意外事故发生的概率。
某部件的故障时间服从均值为 10,000 小时的指数分布。
(a) 该部件已运行了相当于其平均寿命的时间。它在 15,000 小时前失效的概率是多少?
(b) 在 15,000 小时时,该部件仍在运行。它还能再运行 5000 小时的概率是多少?
假设某种"永不停歇"(Die-Hardly-Ever)电池的故障时间服从均值为 48 个月的指数分布。在 60 个月时,该电池仍在运行。
(a) 该电池将在未来 12 个月内失效的概率是多少?
(b) 该电池在其寿命的奇数年份失效的概率是多少?
(c) 若电池在 60 个月时仍在运行,计算其剩余寿命的期望月数。
银行柜员机(drive-through)窗口为顾客服务的时间服从均值为 50 秒的指数分布。
(a) 排在某位到达顾客前面的两位顾客各自用不到 60 秒完成业务的概率是多少?
(b) 前面的两位顾客完成业务,从而使得到达的顾客能在 2 分钟内到达柜员窗口的概率是多少?
确定三角分布的方差 V(X)。
Hardscrabble 工具与模具厂每日用水量(以千升计)服从形状参数为 2、尺度参数为 1/4 的伽马分布。求任意一天需求超过 4000 升的概率。
伯德海军上将前往北极时,穿着电池供电的保暖内衣。这些电池是瞬间而非渐进失效的。电池寿命服从均值为 12 天的指数分布。行程历时 30 天。伯德海军上将装了三块电池。求三块电池足以使这位上将保持温暖的概率。
远程计算机访问某网页的时间间隔服从均值为 15 秒的指数分布。求第三次连接命中发生在 30 秒之后的概率。
亚特兰大机场的机场列车车厢采用双电力制动系统。如果第一套系统失效,车厢会自动切换到备用系统。如果两套系统都失效,就会发生碰撞!假定单套电力制动系统的寿命服从均值为 4000 运行小时的指数分布。如果系统每 5000 运行小时检查一次,求车厢在该时刻之前不发生碰撞的概率。
假设到达收费亭的汽车服从平均到达间隔时间为 15 秒的泊松过程。求直到有三辆车到达为止经过不超过一分钟的概率。
假设按照泊松过程,平均每小时有 30 位顾客到达 Sticky Donut Shop。求在接下来的两位顾客走进店门之前经过时间超过 5 分钟的概率。
Dipsy Doodle 教授每次考试出六道题。每道题给全班 15 名学生评分平均需要 30 分钟。每道题的评分时间服从指数分布,且各题之间相互独立。
(a) 求教授在 2.5 小时或更短时间内完成评分的概率。
(b) 最可能的评分时间是多少?
(c) 期望的评分时间是多少?
某飞机装有双液压系统。如果第一套系统失效,飞机会自动切换到备用系统。如果两套系统都失效,飞机就会坠毁。假定一套液压系统的寿命服从均值为 2000 飞行小时的指数分布。
(a) 若液压系统每 2500 小时检查一次,求飞机在该时刻之前坠毁的概率。
(b) 把检查点移到 3000 小时会带来什么危险?
若随机变量 X 的 pdf 为
f ( x ) = { ( α + β + 1 ) ! α ! β ! x α ( 1 − x ) β , 0 < x < 1 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {(\alpha + \beta + 1) !}{\alpha ! \beta !} x^{\alpha} (1 - x) ^ {\beta}, & 0 < x < 1 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = { α ! β ! ( α + β + 1 )! x α ( 1 − x ) β , 0 , 0 < x < 1 otherwise 则称 X 服从贝塔分布。证明当 \(\beta_{1} = \beta_{2} = 1\) 时,贝塔分布成为单位区间上的均匀分布。
提前期(以百个单位计)服从形状参数为 3、尺度参数为 1 的伽马分布。求在即将到来的一个周期内提前期超过 2(百)个单位的概率。
PC 用廉价显示卡的寿命(以月计)记为随机变量 X,服从 β = 4 \beta = 4 β = 4 θ = 1 / 16 \theta = 1 / 16 θ = 1/16
许多州的车牌遵循如下格式:
letter letter letter number number number
数字是随机的,取值范围为 100 到 999。
(a) 求(随机看到的)接下来两块车牌号码均不低于 500 的概率。
(b) 求(随机看到的)接下来两块车牌号码之和不低于 1000 的概率。[提示:用连续均匀分布逼近离散均匀分布。两个独立均匀分布之和为三角分布。]
设 X 是服从正态分布的随机变量,均值为 10,方差为 4。求 a 和 b 的值,使得 $ P ( a < X < b ) = 0 . 90 {\mathrm{~ a n d ~}} | \mu - a | = | \mu - b |$。
给定下列分布:
Normal (10, 4)
Triangular (4, 10, 16)
Uniform (4, 16)
求各分布下 6 < X < 8 6 < X < 8 6 < X < 8
某项物品的提前期近似服从均值为 20 天、方差为 4 天² 的正态分布。求提前期仅被超出 1%、5% 和 10% 的提前期数值。
社会上的 IQ 分数服从正态分布,均值为 100,标准差为 15。
(a) IQ 不低于 140 的人被称为"天才"。社会中处于天才类别的比例是多少?
(b) 社会中有多大比例的人会因相差 5 分或更少而未达到天才类别?
(c) 假设要进入经认可的学院或大学需要 IQ 不低于 110。由于 IQ 分数偏低而可能被排除在高等教育之外的社会比例是多少?
制造三根轴并装配成一套连杆机构。每根轴的长度(以厘米计)分布如下:
Shaft 1: N(60, 0.09)
Shaft 2: N(40, 0.05)
Shaft 3: N(50, 0.11)
(a) 该连杆机构长度的分布是什么?
(b) 该连杆机构长度超过 150.2 厘米的概率是多少?
(c) 该装配的公差限为 (149.83, 150.21)。有多大比例的装配落在公差限内?[提示:若 { X i } \{X_{i}\} { X i } X i X_{i} X i μ i \mu_{i} μ i σ i 2 \sigma_{i} ^ {2} σ i 2
Y = X 1 + X 2 + ⋯ + X n
Y = X_{1} + X_{2} + \dots + X_{n}
Y = X 1 + X 2 + ⋯ + X n 服从正态分布,均值为 \(\textstyle \sum_{i = 1} ^ {n} \mu_{i}\),方差为 \(\textstyle \sum_{i = 1} ^ {n} \sigma_{i} ^ {2} .\)]
镍镉电池的电池柱周长服从 Weibull 分布,其中 ν = 3.25 \nu = 3 . 25 ν = 3.25 α = 0.005 \alpha = 0 . 005 α = 0.005 β = 1 / 3 \beta = 1 / 3 β = 1/3
(a) 求随机选取的一根电池柱周长大于 3.40 厘米的概率。
(b) 若电池柱大于 3.50 厘米,它们将无法穿过所提供的孔;若小于 3.30 厘米,夹具就无法充分夹紧。有多大比例的电池柱因上述原因之一而必须报废?
镍镉电池的故障时间服从参数为 ν = 0、α = 1/2 年、β = 1 / 4 \beta = 1 / 4 β = 1/4
(a) 求预期在 1.5 年之前失效的电池比例。
(b) 预期寿命长于平均寿命的电池比例是多少?
(c) 预期在 1.5 年到 2.5 年之间失效的电池比例是多少?
Gipgip Pig Farm 在欢乐的 5 月份的用电需求服从三角分布,其中 a = 100 千瓦时,c = 1800 千瓦时。千瓦时的中位数为 1425。计算该月份千瓦时的众数值。
某电子子组件的故障时间可用 Weibull 分布建模,其位置参数为 0,α = 1000 小时,β = 1 / 2 \beta = 1 / 2 β = 1/2
(a) 平均故障时间是多少?
(b) 这些子组件中有多大比例在 3000 小时前失效?
在 85 号州际公路 Hahira 检查站接受检查的三轴卡车的总重量,服从参数为 ν = 6.8 吨、α = 1/2 吨、β = 1.5 的 Weibull 分布。确定适当的载重限值,使得有 0.01 的卡车会因超重而被处罚。
Sag Reva 的燃油里程表当前读数为平均每加仑 25.3 英里。假定 Sag 的汽车的燃油里程服从三角分布,最小值为零,最大值为每加仑 50 英里。中位数的值是多少?
某邮递员有一条由五段组成的投递路线,完成每一段所需的时间(以分钟计)服从正态分布,其均值和方差如下:
除了上述时间之外,邮递员还必须在中心邮局整理邮件,该活动所需时间服从 N(90, 25)。驾车前往路线起点所需时间服从 N(10, 4)。从路线返回所需时间服从 N(15, 4)。随后邮递员从事行政事务,所需时间服从 N(30, 9)。

(a) 邮递员工作日长度的期望是多少?

(b) 某一天工作满八小时后开始加班。求任意一天该邮递员需要加班的概率。

(c) 求在六天工作周中,该邮递员有两天或更多天需要加班的概率。

(d) 求任意一天该路线会在 8 小时上下 24 分钟之内完成(即在 8 小时 ±24 分钟之内完成)的概率。[提示:参见习题 39。]
已知 WD-1 计算机芯片的故障时间服从参数为 ν = 0 , α = 400 d a y s , \nu = 0 , \alpha = 400 \mathrm{days} , ν = 0 , α = 400 days , β = 1 / 2 \beta = 1 / 2 β = 1/2
Schocker 百货商店展出的电视机采用这样的接线方式:当一台失效时,会有一台完全相同的机型接替开机。三台这样的电视以这种串联方式接在一起。这些电视的寿命彼此独立。每台电视的寿命服从均值为 10,000 小时的指数分布。求系统组合寿命大于 32,000 小时的概率。
密西西比州比洛克西(Biloxi)7 月 21 日的最高气温记为随机变量 X,其概率密度函数如下,其中 X 以华氏度为单位。
f ( x ) = { 2 ( x − 85 ) 119 , 85 ≤ x ≤ 92 2 ( 102 − x ) 170 , 92 < x ≤ 102 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {2 (x - 85)}{119}, & 85 \leq x \leq 92 \\ \frac {2 (102 - x)}{170}, & 92 < x \leq 102 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = ⎩ ⎨ ⎧ 119 2 ( x − 85 ) , 170 2 ( 102 − x ) , 0 , 85 ≤ x ≤ 92 92 < x ≤ 102 otherwise (a) 气温的方差 V(X) 是多少?[提示:如果你做过了习题 22,这题相当容易。]
(b) 气温的中位数是多少?
(c) 气温的众数是多少?
Eastinghome 灯泡的故障时间服从 Weibull 分布,其中 ν = 1.8 × 10 3 \nu = 1 . 8 \times 10^{3} ν = 1.8 × 1 0 3 α = 1 / 3 × 10 3 \alpha = 1 / 3 \times 10^{3} α = 1/3 × 1 0 3 β = 1 / 2 \beta = 1 / 2 β = 1/2
(a) 预期寿命长于平均寿命的灯泡比例是多少?
(b) 灯泡寿命的中位数是多少?
提前期需求(以百个单位计)服从形状参数为 2、尺度参数为 1/4 的伽马分布。求在即将到来的一个周期内提前期超过 4(百)个单位的概率。
令时刻 t = 0 t = 0 t = 0
λ ( t ) = { 30 , 0 ≤ t < 1 45 , 1 ≤ t < 2 20 , 2 ≤ t ≤ 4
\lambda (t) = \left\{\begin{array}{l l} 30, & 0 \leq t < 1 \\ 45, & 1 \leq t < 2 \\ 20, & 2 \leq t \leq 4 \end{array} \right.
λ ( t ) = ⎩ ⎨ ⎧ 30 , 45 , 20 , 0 ≤ t < 1 1 ≤ t < 2 2 ≤ t ≤ 4 假定 NSPP 模型是合适的,完成下列各项:(a) 推导 \(\Lambda (t)\)。(b) 计算上午 6:30 到 8:30 之间的期望到达数。(c) 计算上午 6:30 到 8:30 之间到达数少于 60 的概率。