7 随机数生成
随机数(random number)是几乎所有离散系统仿真中不可或缺的基本要素。大多数计算机语言都备有某种子程序、对象或函数,用来产生随机数。在仿真语言中,随机数用于产生事件时间以及其他随机变量(random variable)。本章介绍随机数的生成,以及随后对所生成随机数所作的随机性检验。
1 随机数的性质
一串随机数 必须具备两项重要的统计性质:均匀性与独立性。每个随机数 都必须是从 0 到 1 之间连续均匀分布(uniform distribution)中抽取的独立样本——也就是说,其概率密度函数(pdf)为
该密度函数如图 1 所示。每个 的期望值(expected value)由下式给出:
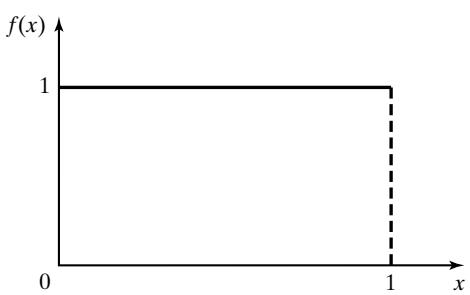
图 1 随机数的概率密度函数。
而方差(variance)由下式给出:
均匀性与独立性这两项性质带来如下推论:
若把区间 [0, 1] 划分为 n 个类别(class),或等长的子区间,则每个区间中观察值的期望个数为 其中 N 为观察值总数。
在某个特定区间上观察到取值的概率,与此前已抽取的取值无关。
下一节将描述用于产生随机数、驱动仿真的方法所应具备的若干理想性质。
2 伪随机数的生成
注意本节的标题中含有"伪"(pseudo)字。“伪"意为虚假,因此我们所生成的是虚假的随机数!这里使用"伪"字,是要说明:仅仅是用一种已知方法来生成随机数,这一行为本身就消除了产生真正随机性的可能。方法一旦已知,随机数的集合便可重复生成。于是便可以论证,这些数字并非真正随机。然而,任何生成方案的目标,都是产生一串介于 0 与 1 之间的数字,使其尽可能贴近地模拟(或模仿)均匀分布与独立性的理想性质。
确实,在生成伪随机数(pseudo-random number)的过程中,可能会出现某些问题或误差。这些误差,或对理想随机性的偏离,都与第 1 节中所述的性质有关。这类偏离的例子包括:
所生成的数字可能不是均匀分布的。
所生成的数字可能是离散取值而非连续取值的。
所生成数字的均值可能偏高或偏低。
所生成数字的方差可能偏高或偏低。
可能存在相依性,例如以自相关来度量。
对某一特定生成方案而言,其对均匀性与独立性的偏离,通常可以通过第 4 节所述的检验发现。若发现了偏离,就应当弃用该生成方案,改用一个可接受的(acceptable)发生器(generator)。通过第 4 节检验乃至更严格检验的发生器已经问世;因此,没有任何理由去使用一个已被判定有缺陷的发生器。
通常,随机数是由数字计算机作为仿真的一部分来产生的。可以用来产生这些数值的方法有很多。在介绍其中若干方法之前,有几个重要的考虑事项应当提及:
方法应当快速。单次计算代价不高,但一次仿真可能需要数百万个随机数。通过选择计算效率高的随机数生成方法,可以控制总成本。
方法应当可移植到不同的计算机——最好还能移植到不同的编程语言。这样做是有好处的:仿真程序无论在何处执行都将产生相同的结果。
方法应当具有足够长的循环。循环长度,或称周期(period),表示随机数序列在先前的数字开始以早先的次序重复之前所能延续的长度。因此,若要生成 10,000 个事件,周期应当比这长许多倍。
循环的一种特殊情形是退化(degenerating)。当同样的随机数反复出现时,该方法即发生退化。这种情况当然是不可接受的。有些方法很快就会发生这种现象。
随机数应当可重复。给定起点(或初始条件),应当能够生成同一组随机数,且完全独立于被仿真的系统。这对调试大有帮助,并便于在不同系统之间作比较。基于同样的理由,还应当能够方便地指定序列中彼此相距很远的不同起点。
最重要的是,所生成的随机数应当紧逼均匀性与独立性的理想统计性质。
发明一些"看起来像"能产生随机数的技术很容易;而发明真正能产生看上去独立、均匀分布的随机数序列的技术,则极其困难。目前该主题已有浩繁的文献和丰富的理论,人们投入了大量时间进行检验,以确定各种发生器的性质。即便一项技术已知在理论上是可靠的,要把它实现得既快又可移植,也很少容易。本章的目标是让读者了解随机数生成中的核心问题,加深理解,并展示该领域工作者所采用的一些技术。
3 随机数的生成技术
第 3.1 节的线性同余法是生成随机数应用最广泛的技术,因此我们详细地介绍它。我们还将介绍该方法的一个扩展,它能产生周期更长的序列。书中还提出了许多其他方法,Bratley、Fox 与 Schrage [1996]、Law [2007] 和 Ripley [1987] 对它们作了评述。
3.1 线性同余法
线性同余法最初由 Lehmer [1951] 提出,它首先按如下递推关系产生一串介于 0 与 之间的整数 :
初值 称为种子(seed),a 称为乘数(multiplier),c 称为增量(increment),m 称为模(modulus)。若式 (1) 中 ,则这种形式称为混合同余法(mixed congruential method)。当 时,这种形式称为乘法同余法(multiplicative congruential method)。 和 取值的选取会显著影响统计性质与循环长度。式 (1) 的各种变形在计算机生成随机数时相当常见。
注意,这里生成的是随机整数而不是随机数。这些随机整数看上去应当在 0 到 的整数上均匀分布。于是可通过下式生成 0 与 1 之间的随机数 :
下面一个例子将说明这一技术是如何运作的。
例 1
用线性同余法生成一串随机数,取 ,,。种子序列 及其随后所得的随机数 计算如下:
回顾一下:只要 能被 m 整除且没有余数,就有 mod m;否则 mod 运算返回 的余数。因此, mod ,因为 502/100 等于 5 且余数为 2。
线性同余法(以及任何生成方案)的最终检验标准,在于所生成的数字 . 逼近均匀性与独立性的程度。不过,还有若干次级性质必须加以考虑,其中包括最大密度与最大周期。
首先注意,由式 (2) 生成的数字只取自集合 中的值,因为每个 X 都是集合 中的整数。因此,每个 在 I 上是离散的,而不是在区间 [0, 1] 上连续的。如果模 m 是一个很大的整数,这种近似似乎无关紧要。(诸如 和 这样的取值,在许多仿真语言所出现发生器中是常用的。)所谓最大密度,是指 所取的值在 [0, 1] 上不留下大的空隙。
其次,为有助于达到最大密度,并避免在实际应用中发生循环(即同一生成数字序列的反复出现),发生器应当具有尽可能大的周期。通过恰当选取 和 可达到最大周期 [Law 2007]。
当 m 是 2 的幂,即 ,且 时,可能的最长周期为 ,只要 c 与 m 互素(即 c 与 m 的最大公因子为 1)且 (k 为整数)即可达到。
当 m 是 2 的幂,即 ,且 时,可能的最长周期为 ,若种子 为奇数,且乘数 a 取为 或 (其中 1, . . . )即可达到。
当 m 是素数且 时,可能的最长周期为 ,只要乘数 a 具有如下性质即可达到:使 能被 m 整除的最小整数 k 为 。
例 2
使用乘法同余法,求取发生器在 64 且 和 4 时的周期。解答见表 1。当种子为 1 或 3 时,序列的周期为 16。然而,种子为 2 时得到的周期长度为 8,种子为 4 时则出现长度为 4 的周期。
在例 2 中, 且 。因此最大周期为 注意,该周期是通过使用奇数种子 和 达到的;偶数种子 和 分别给出周期 8 和 4,均小于最大值。注意 属于 且 的形式,这正是达到最大周期所要求的。
当 时,所生成的序列取值为集合 中的值。所生成的随机数 序列中的间隙相当大(即间隙为 ,即 0.0625)。这样的间隙引发了人们对所生成序列密度的担忧。
例 2 中的发生器对任何应用都是不可行的——它的周期太短,密度也不足。不过,这个例子显示了对 和 进行恰当选择的重要性。
表 1 使用不同种子确定周期
| i | ||||
|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 |
| 1 | 13 | 26 | 39 | 52 |
| 2 | 41 | 18 | 59 | 36 |
| 3 | 21 | 42 | 63 | 20 |
| 4 | 17 | 34 | 51 | 4 |
| 5 | 29 | 58 | 23 | |
| 6 | 57 | 50 | 43 | |
| 7 | 37 | 10 | 47 | |
| 8 | 33 | 2 | 35 | |
| 9 | 45 | 7 | ||
| 10 | 9 | 27 | ||
| 11 | 53 | 31 | ||
| 12 | 49 | 19 | ||
| 13 | 61 | 55 | ||
| 14 | 25 | 11 | ||
| 15 | 5 | 15 | ||
| 16 | 1 | 3 |
在数字计算机上使用该发生器时,速度与效率同样也是选择时需要考虑的因素。使用一个 2 的幂或接近 2 的幂的模 m,有助于提高速度与效率。由于大多数数字计算机采用二进制表示,当模为 2 的幂()时,式 (1) 中的 mod(取余)运算可以高效地完成。在普通算术运算给出 的值之后,只需丢弃 中最左边的二进制位,再取最右边的 b 个二进制位,即得 。下面的例子用 类比地说明这一运算,因为大多数人是以十进制方式思考的。
例 3
令 ,并用式 (1) 生成一串随机整数。
当 m 是 10 的幂,即 时,mod 运算只需保留最右边的 b 位(十进制)数字即可完成。类比地,当 且 时,mod 运算对二进制计算机最为高效。
例 4
本节最后一个例子已在实际中使用。它经过了大量检验 [Learmonth and Lewis, 1973; Lewis et , 1969]。 和 m 的取值经过挑选,以确保发生器所期望的特性最有可能得到满足。
令 , 且 (一个素数)。这些取值满足保证周期为 (远超过 20 亿)的条件。再指定种子 。所生成的前几个数如下:
注意,该方法除以 而非 ;不过,对于如此之大的 ,其影响可以忽略。
3.2 组合线性同余发生器
随着计算能力的提高,我们能够仿真的系统复杂度也随之提高。周期为 的随机数发生器(例如例 4 中介绍的那个广为流行的发生器),对所有应用来说已不再够用。例子包括高可靠性系统的仿真——为了观察哪怕仅仅一次失效事件,就必须仿真数十万次基本事件;以及复杂计算机网络的仿真,其中数千名用户正在执行数百个程序。当前的一个研究领域是推导周期显著更长的发生器。
一种富有成效的思路,是把两个或多个乘法同余发生器组合起来,使组合后的发生器既具有良好的统计性质,又有更长的周期。L’Ecuyer [1988] 的下列结果给出了实现这一点的思路:
若 是任意一组相互独立的离散取值随机变量(不一定同分布),但其中之一(比如 )在 0 到 的整数上均匀分布,那么
在 0 到 的整数上均匀分布。为说明如何利用这一结果来构造组合发生器,令 为 k 个不同乘法同余发生器的第 i 个输出,其中第 j 个发生器的模为素数 ,乘数 的选取使得周期为 。于是第 j 个发生器产生的整数 近似地在 1 到 的整数上均匀分布,而 近似地在 0 到 的整数上均匀分布。因此 L’Ecuyer 建议采用如下形式的组合发生器:
其中
注意, 系数隐含地完成了减去 1 的操作,即 ;例如,若 ,则 。这类发生器可能达到的最大周期为
它由下一个例子所介绍的发生器达到。
例 5
对于 32 位计算机,L’Ecuyer [1988] 建议组合 个发生器,其中 ,,,且 。由此得到如下算法(algorithm):
为第一个发生器选取处于区间 [1, 2,147,483,562] 内的种子 ,为第二个发生器选取处于区间 [1, 2,147,483,398] 内的种子 。令 。
计算各个发生器。
- 置
- 返回
- 置 ,转到步骤 2。
这个组合发生器的周期为 。或许出人意料的是,即便如此之长的周期,对所有应用来说也仍可能不够用。周期长达 的组合发生器,可参见 L’Ecuyer [1996, 1999] 和 L’Ecuyer 等人 [2002]。其中一个发生器已被译成 Visual Basic for Applications,可在 www.bcnn.net 上的电子表格 RandomNumberTools.xls 中找到。
3.3 随机数流
线性同余随机数发生器的初始种子(对于组合线性同余发生器而言则是各初始种子),就是用于初始化随机数序列的整数值 。由于发生器所产生的整数序列 X , 是重复的,序列中的任何取值都可以用来"播种"该发生器。
对于线性同余发生器,随机数流(stream)无非是这样一种便利的指称方式:它指取自序列 的一个起始种子(对于组合发生器,流指的是所有基本发生器的起始种子);通常这些起始种子在序列中相距甚远。例如,若各流相隔 b 个取值,则第 i 个流可由起始种子
来定义,其中 。在较早的发生器中 较为常见,但在现代组合线性同余发生器中已使用高达 的取值。(此类发生器的实现可参见 L’Ecuyer 等人 [2002]。)因此,只要保存每个流当前的种子取值,一个具有 k 个流的随机数发生器就像 k 个彼此独立的虚拟随机数发生器。习题 21 给出了构造相距很远之随机数流的一种方法。
这里还有一个问题:通过仿真来比较两个或多个备选系统;把伪随机数序列的各段专门用于各个被仿真系统中的同一用途,是有利的。例如,在比较若干排队系统的效率时,若所有被仿真的系统都经历完全相同的顾客到达序列,则比较会更加公平。通过为每个排队仿真指定一个特定的流来产生到达,即可实现这种同步。若这些流的起始种子相距足够远,则其效果等同于拥有一个专门用于产生顾客到达的独立随机数发生器。
4 随机数的检验
随机数所期望具备的性质——均匀性与独立性——已在第 1 节中讨论过。为检验这些期望性质是否已经达到,可以进行若干检验。(所幸,大多数商业仿真软件所适用的检验都已经做过。)按照所关注的性质,这些检验可归为两类:均匀性与独立性。本节简要介绍两类检验:
频数检验(frequency test)。采用 Kolmogorov–Smirnov 检验或卡方检验(chi-square test),将所生成数字集合的分布与均匀分布作比较。
自相关检验(autocorrelation test)。检验数字之间的相关性,并把样本相关性与所期望的相关性(零)作比较。
在均匀性检验(uniform test)中,假设如下:
原假设 的含义是:这些数字在区间 [0, 1] 上均匀分布。未能拒绝原假设,意味着本检验没有发现非均匀性的证据。但这并不意味着无需进一步检验发生器的均匀性。
在独立性检验中,假设如下:
这一原假设 的含义是:这些数字是独立的。未能拒绝原假设,意味着本检验没有发现相依性的证据。但这并不意味着无需进一步检验发生器的独立性。
每项检验都必须给出显著性水平 α。水平 α 是在原假设为真时拒绝原假设的概率:
决策者为任何检验设定 α 的取值。α 通常取 0.01 或 0.05。
若对同一组数字进行若干项检验,则仅凭偶然(即犯第一类(α)错误)在至少一项检验上拒绝原假设的概率会上升。设 ,并对一串数字进行了五项不同的检验。仅凭偶然在至少一项检验上拒绝原假设的概率可能高达 0.25。
类似地,若对发生器产生的许多组数字各做一项检验,则随着受检数字组数的增加,仅凭偶然(即犯第一类(α)错误)在至少一项检验上拒绝原假设的概率也会上升。例如,若对 100 组数字做该检验,取 ,则预期会有五项检验仅凭偶然而被拒绝。若 100 次检验中的拒绝次数接近 100α,就没有充分理由弃用该发生器。本段与上一段所讨论的概念,在例 8 的结论中还将进一步讨论。
如果使用的是众所周知的仿真语言或随机数发生器,那么前面提到的检验以及第 4.1 节和第 4.2 节所述的检验,很可能就没有必要再做了。然而,随机数发生器常常被加入并非专为仿真而开发的软件中,例如电子表格程序、符号/数值计算器以及编程语言。如果手头的发生器没有明确的说明或文档,那么就应该对来自该发生器的许多组数字样本应用本章的检验。本章未予涵盖、但常用的其他检验有:用于抽样数字的 Good 序列检验(serial test)[1953, 1967]、中位谱检验 [Cox and Lewis, 1966; Durbin, 1967]、游程检验 [Law 2007],以及方差齐性检验 [Cox and Lewis, 1966]。即便一组数字通过了所有检验,也不能保证其随机性;总有可能存在某种潜在的规律未被察觉。
本书强调的是应用于发生器实际产生的数字序列上的经验检验。由于现代伪随机数发生器的周期极长(如第 3.2 节所述),如今已不可能把这些检验应用于此类发生器周期中相当可观的一部分。当遇到一个性质完全未知的发生器(例如某个没有文档说明、埋藏在软件包深处的那种)时,这些检验可以用作一种检查;但它们无法用以确定一个发生器在其整个周期内的质量。所幸,还有一类理论检验,它们无需实际产生任何数字即可评价 m、a、c 的取值选择,其中最常见的是频谱检验(spectral test)。这些检验中有许多评估 k 元组随机数是如何填满一个 k 维单位立方体的。这些检验超出了本书的范围;可参见 Ripley [1987]。
在下面检验的示例中不再重述假设,假设如前面各段所指出。尽管很少有仿真分析人员需要亲自执行这些检验,但每一位仿真使用者都应当了解一个优良随机数发生器应具备的性质。
4.1 频数检验
为确认一个新发生器而始终应当进行的一项基本检验,是均匀性检验。两种不同的检验方法是 Kolmogorov–Smirnov 检验和卡方检验。这两种检验都度量随机数样本的分布与理论均匀分布之间的吻合程度。二者都基于这样的原假设:样本分布与理论分布之间不存在显著差异。
- Kolmogorov–Smirnov 检验。该检验把均匀分布的连续累积分布函数(cdf) 与 N 个观察值样本的经验累积分布函数 作比较。根据定义,
若来自该随机数发生器的样本为 ,则经验累积分布函数 定义为
随着 N 变大,只要原假设成立, 就应当成为 更好的逼近。
经验分布的累积分布函数是阶梯函数,在每个观测值处发生跳跃。
Kolmogorov–Smirnov 检验基于 与 在随机变量取值范围内的最大绝对偏差——即,它基于统计量
D 的抽样分布是已知的;它作为 N 的函数列于表 A.8。对于针对均匀 cdf 的检验,检验步骤如下:
步骤 1. 将数据由小到大排序。令 表示第 i 个最小的观察值,使得
步骤 2. 计算
步骤 3. 计算
步骤 4. 在表 A.8 中按给定的显著性水平 α 和给定的样本量 N 查取临界值 。
步骤 5. 若样本统计量 D 大于临界值 ,则拒绝"数据是来自均匀分布的样本"这一原假设。若 ,则断定 的真实分布与均匀分布之间未发现差异。
例 6
假定生成了 5 个数字 0.44、0.81、0.14、0.05、0.93,现拟采用 Kolmogorov–Smirnov 检验(显著性水平 )进行均匀性检验。首先必须把这些数字由小到大排序。借助表 2 可以简化计算。表 2 的首行列出了从最小()到最大()的各数。(即 )和 (即 )的计算只需使用表 2 即可轻松完成。统计量算得 ,。因此,。
表 2 Kolmogorov–Smirnov 检验的计算
| 0.05 | 0.14 | 0.44 | 0.81 | 0.93 | |
|---|---|---|---|---|---|
| 0.20 | 0.40 | 0.60 | 0.80 | 1.00 | |
| 0.15 | 0.26 | 0.16 | — | 0.07 | |
| 0.05 | — | 0.04 | 0.21 | 0.13 |
的临界值由附录中的表 A.8 按 和 查得,为 0.565。由于算得的值 0.26 小于表列临界值 0.565,故"所生成数字的分布为均匀分布"这一假设不被拒绝。
表 2 中的计算在图 2 中得到了图示,其中经验累积分布函数 与均匀累积分布函数 作了比较。可以看出, 是 高于 的最大偏差,而 是 低于 的最大偏差。例如,在 处, 的值由 给出,而 的值由 给出。虽然统计量 D 由式 (3) 定义为所有 x 上的最大偏差,但从图 2 可以看出,最大偏差总是出现在某个跳跃点 上;因此,无需考虑其他 x 取值处的偏差。
- 卡方检验。卡方检验使用样本统计量
其中 是第 i 类中的观察频数, 是第 i 类中的期望频数,n 是类别数。对于均匀分布 若各类等间距,则每类的期望个数为
其中 N 为观察值总数。可以证明, 的抽样分布近似于具有 n − 1 个自由度的卡方分布。
例 7
用 的卡方检验,检验接下来给出的数据是否均匀分布。表 3 给出了主要的计算结果。该检验使用 个等长区间,即 。 的值为 3.4。将其与表 A.6 中给出的临界值 作比较。由于 远小于表列值 ,故均匀分布的原假设不被拒绝。
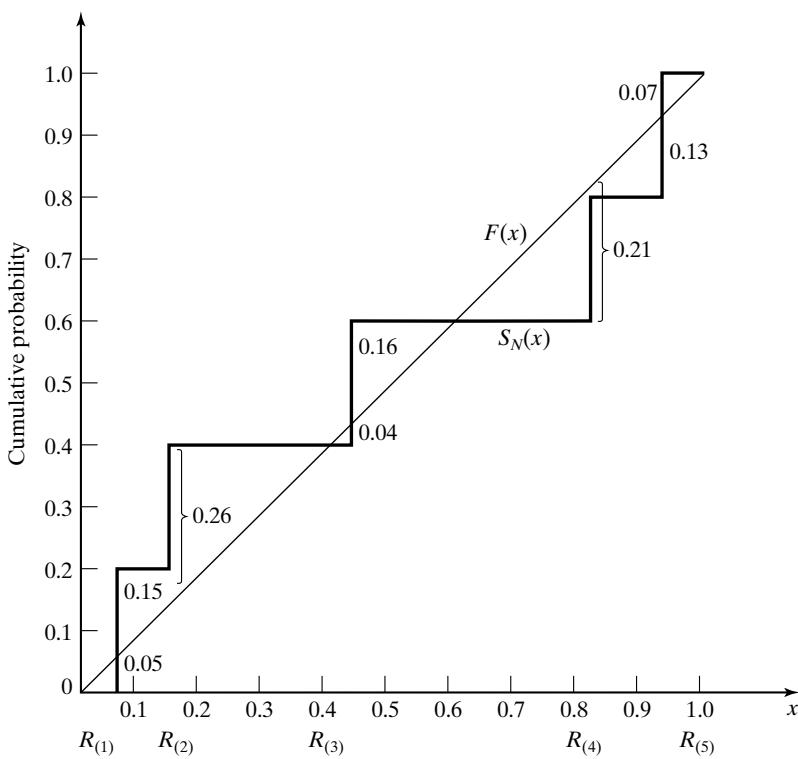
图 2 F(x) 与 的比较。
| 0.34 | 0.90 | 0.25 | 0.89 | 0.87 | 0.44 | 0.12 | 0.21 | 0.46 | 0.67 |
|---|---|---|---|---|---|---|---|---|---|
| 0.83 | 0.76 | 0.79 | 0.64 | 0.70 | 0.81 | 0.94 | 0.74 | 0.22 | 0.74 |
| 0.96 | 0.99 | 0.77 | 0.67 | 0.56 | 0.41 | 0.52 | 0.73 | 0.99 | 0.02 |
| 0.47 | 0.30 | 0.17 | 0.82 | 0.56 | 0.05 | 0.45 | 0.31 | 0.78 | 0.05 |
| 0.79 | 0.71 | 0.23 | 0.19 | 0.82 | 0.93 | 0.65 | 0.37 | 0.39 | 0.42 |
| 0.99 | 0.17 | 0.99 | 0.46 | 0.05 | 0.66 | 0.10 | 0.42 | 0.18 | 0.49 |
| 0.37 | 0.51 | 0.54 | 0.01 | 0.81 | 0.28 | 0.69 | 0.34 | 0.75 | 0.49 |
| 0.72 | 0.43 | 0.56 | 0.97 | 0.30 | 0.94 | 0.96 | 0.58 | 0.73 | 0.05 |
| 0.06 | 0.39 | 0.84 | 0.24 | 0.40 | 0.64 | 0.40 | 0.19 | 0.79 | 0.62 |
| 0.18 | 0.26 | 0.97 | 0.88 | 0.64 | 0.47 | 0.60 | 0.11 | 0.29 | 0.78 |
不同作者对于卡方检验的应用提出了各自的考虑。对于例 7 中那种大小的数据集,这些考虑并不适用——也就是说,若样本中有 100 个取值,并使用 5 到 10 个等长区间,该检验即可接受。一般而言,建议选取 n 与 N 使每个 。
只要样本量足够大,Kolmogorov–Smirnov 检验和卡方检验都可用于检验数据样本的均匀性。不过,Kolmogorov–Smirnov 检验在两者中检验功效更强,因而更受推荐。此外,Kolmogorov–Smirnov 检验可用于小样本,而卡方检验只对大样本有效,比如 。
表 3 卡方检验的计算
| 区间 | |||||
|---|---|---|---|---|---|
| 1 | 8 | 10 | -2 | 4 | 0.4 |
| 2 | 8 | 10 | -2 | 4 | 0.4 |
| 3 | 10 | 10 | 0 | 0 | 0.0 |
| 4 | 9 | 10 | -1 | 1 | 0.1 |
| 5 | 12 | 10 | 2 | 4 | 0.4 |
| 6 | 8 | 10 | -2 | 4 | 0.4 |
| 7 | 10 | 10 | 0 | 0 | 0.0 |
| 8 | 14 | 10 | 4 | 16 | 1.6 |
| 9 | 10 | 10 | 0 | 0 | 0.0 |
| 10 | 11 | 10 | 1 | 1 | 0.1 |
| 100 | 100 | 0 | 3.4 |
设想一组 100 个正在接受独立性检验的数字,其中前 10 个取值位于 0.01–0.10 区间,接下来的 10 个取值位于 0.11–0.20 区间,依此类推。这组数字会轻松通过频数检验,但发生器所产生数字的次序并不是随机的。本章下一节所讨论的检验,正是针对所生成随机数的独立性。
4.2 自相关检验
自相关检验关注的是一串数字之间的相依性。举例来说,请考虑下面这串数字(从左到右读):
| 0.12 | 0.01 | 0.23 | 0.28 | 0.89 | 0.31 | 0.64 | 0.28 | 0.83 | 0.93 |
|---|---|---|---|---|---|---|---|---|---|
| 0.99 | 0.15 | 0.33 | 0.35 | 0.91 | 0.41 | 0.60 | 0.27 | 0.75 | 0.88 |
| 0.68 | 0.49 | 0.05 | 0.43 | 0.95 | 0.58 | 0.19 | 0.36 | 0.69 | 0.87 |
从直观上看,这些数字似乎是随机的,而且它们大概会通过至此为止所给出的全部检验。然而,考察第 5 个、第 10 个、第 15 个(即从第 5 个起每隔 5 个)等等位置,会发现该位置上是一个很大的数。现在,30 个数字对于判定一个随机数发生器不合格而言,样本量还相当小,但这个想法是:序列中的数字可能是相互关联的。在本节中,将介绍一种发现是否存在这种关系的方法。这种关系不必非要是全是大数。也有可能在被考察的位置上全是小数,或者数字在极高与极低之间交替。
下面即将介绍的检验,要求计算每隔 ℓ 个数(ℓ 也称为 ,即滞后)之间的自相关,并从第 i 个数开始。因此,有意义的是下列各数之间的自相关 :。M 是满足 的最大整数,其中 N 是序列中取值的总数。(也就是说,所检验的是长度为 的子序列。)
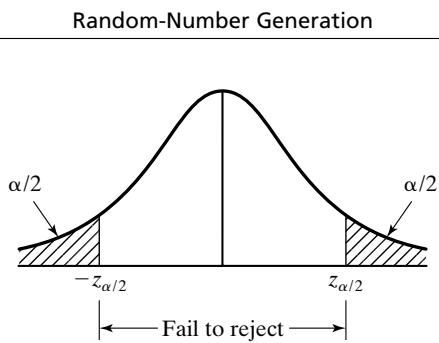
图 3 未能拒绝假设。
非零的自相关意味着缺乏独立性,因此适合采用下面的双尾检验:
当 M 较大时,若 互不相关,则 的估计量(estimator,记作 )近似服从正态分布。于是检验统计量可构造为
在 M 较大时,在独立性假设下它服从均值为 0、方差为 1 的正态分布。
的公式(写成略有差异的形式)以及估计量的标准差(standard deviation),由 Schmidt 与 Taylor [1970] 给出如下:
以及
算出 之后,若 ,则不拒绝独立性的原假设,其中 α 为显著性水平, 由表 A.3 查得。图 3 说明了这一检验。
若 ,则称该子序列呈现正自相关。此时,滞后为 ℓ 的相邻取值彼此接近的概率高于预期(即子序列中随机数高者之后仍为高者,低者之后仍为低者)。另一方面,若 ,则该子序列呈现负自相关,这意味着低随机数后面往往跟着高随机数,反之亦然。所期望的性质——独立性(它意味着零自相关)——意味着在滞后为 ℓ 的相邻随机数之间,不存在这里所讨论的那种可辨别的关系。
例 8
用 检验本节开头那串数字中的第 3 个、第 8 个、第 13 个……是否自相关。这里 i = 3(从第 3 个数开始),(每隔 5 个数),(序列中有 30 个数),(满足 的最大整数)。于是
以及
于是检验统计量取值为
由表 A.3 查得临界值为
因此,不能依据本检验拒绝独立性的假设。
可以看出,当 M 较小时该检验并不十分灵敏,特别是当被检验的数字偏小的时候。设想一下,如果上述 计算中的每一项都等于零会怎样。那时 将等于 −0.25,而算得的 Z 将取 −1.95 的值,尚不足以拒绝独立性的假设。
当 N 较大时,一组数据中可以形成许多种序列。例如,从序列的第一个数开始,可能的选择包括:(a) 全部数字构成的序列;(b) 由第 1、3、5、……个数字构成的序列;(c) 由第 1、4、……个数字构成的序列,依此类推。若 ,则拒绝一个真假设的概率为 0.05。若考察 10 条相互独立的序列,则仅凭偶然而未发现显著自相关的概率为 ,即 0.60。因此,在自相关并不存在的情况下,有 40% 的概率会检测到显著的自相关。若 α 取 0.10 并进行 10 项检验,则仅有 65% 的把握不会仅凭偶然而发现自相关。结论是:通过做大量检验来"搜寻"自相关,最终可能会检测出自相关来,甚至可能仅仅是出于偶然,即便原本并不存在自相关。
5 小结
本章介绍了随机数的生成,以及随后对所生成数字所作的均匀性与独立性检验。随机数用于产生随机变量。
在现有的众多随机数发生器类型中,基于线性同余法的发生器应用最为广泛,但它们正被组合线性同余发生器所取代。在用于检验随机数发生器的众多统计检验类型中,本章介绍了两种不同的类型:一种检验均匀性,另一种检验独立性。
仿真分析人员可能永远不会直接接触随机数发生器,也不会直接参与发生器输出数字的检验。大多数计算机和仿真语言都备有能够按需产生随机数或随机数流的方法。但即便是使用多年的发生器——其中一些至今仍在使用——也已被发现是不合格的。因此,本章提请仿真分析人员注意这类可能性,并提醒应调查并确认所用的发生器已经过充分的检验。一些研究者已在开发随机数的生成与检验方法以及这些方法的后续应用方面积累了高深的专长。本章仅对该主题作基本介绍;若要成为该领域的专家,读者还需要更深的探究和更广的视野。一份重要的奠基性参考文献是 Knuth [1998];另可参见 Bratley、Fox 与 Schrage [1996]、Law [2007]、L’Ecuyer [1998] 和 Ripley [1987] 中的评述。
最后还需要提醒一点。即便所生成的数字通过了所有检验(本章所涵盖的检验以及本章中提及的其他检验),仍可能有某种潜在的规律未被察觉,而发生器也并未因此被判为有缺陷。不过,广泛使用的仿真语言中所提供的那些发生器,已经过充分的检验与确认。
参考文献
BRATLEY, P., B. L. FOX, AND L. E. SCHRAGE [1996], A Guide to Simulation, 2d ed., Springer-Verlag, New York.
COX, D. R., AND P. A. W. LEWIS [1966], The Statistical Analysis ofSeries ofEvents, Methuen, London.
DURBIN, J. [1967], “Tests of Serial Independence Based on the Cumulated Periodogram,” Bulletin of the International Institute ofStatistics, vol. 42, pp. 1039–1049.
GOOD, I. J. [1953], “The Serial Test for Sampling Numbers and Other Tests of Randomness,” Proceedings of the Cambridge Philosophical Society, Vol. 49, pp. 276–284.
GOOD, I. J. [1967], “The Generalized Serial Test and the Binary Expansion of 4,” Journal ofthe Royal Statistical Society, Ser. A, Vol. 30, No. 1, pp. 102–107.
KNUTH, D. W. [1998], TheArt ofComputer Programming:Vol. 2, Semi-numericalAlgorithms, 2d ed.,Addison– Wesley, Reading, MA.
LAW, A. M. [2007], Simulation Modeling and Analysis, 4th ed., McGraw-Hill, New York.
LEARMONTH, G. P., AND P. A. W. LEWIS [1973], “Statistical Tests of Some Widely Used and Recently Proposed Uniform Random Number Generators,” Proceedings ofthe Conference on Computer Science and Statistics: Seventh Annual Symposium on the Interface, Western Publishing, North Hollywood, CA, pp. 163–171.
L’ECUYER, P. [1988], “Efficient and Portable Combined Random Number Generators,” Communications of the ACM, Vol. 31, pp. 742–749, 774.
L’ECUYER, P. [1996], “Combined Multiple Recursive Random Number Generators,” Operations Research, Vol. 44, pp. 816–822.
L’ECUYER, P. [1998], “Random Number Generation,” Chapter 4 in Handbook of Simulation, J. Banks, ed., pp. 93–137. Wiley, New York.
L’ECUYER, P. [1999], “Good Parameters and Implementations for Combined Multiple Recursive Random Number Generators,” Operations Research, Vol. 47, pp. 159–164.
L’ECUYER, P., R. SIMARD, E. J. CHEN,AND W. D. KELTON [2002], “An Object-Oriented Random-Number Package with Many Long Streams and Substreams,” Operations Research, Vol. 50, pp. 1073–1075.
LEHMER, D. H. [1951], “Mathematical Methods in large-Scale Computing Units,” Proceedings ofthe Second Symposium on Large-Scale Digital Calculating Machinery, Harvard University Press, Cambridge, MA, pp. 141–146.
LEWIS, P. A. W., A. S. GOODMAN, AND J. M. MILLER [1969], “A Pseudo-Random Number Generator for the System/360,” IBM Systems Journal, Vol. 8, pp. 136–145.
RIPLEY, B. D. [1987], Stochastic Simulation, Wiley, New York.
SCHMIDT, J. W., and R. E. TAYLOR [1970], Simulation and Analysis of Industrial Systems, Irwin, Home wood, IL.
习题
设计一种方法,在区间 [0, 1] 上以 2 位精度实际产生随机数。[提示:考虑从帽子里抽取某物。]
列举伪随机数除系统仿真之外的一些应用——例如视频博彩游戏。
如何把在区间 [0, 1] 上均匀的随机数,转换成在区间 [−11, 17] 上均匀的随机数?
用线性同余法生成一串三个两位随机整数及相应的随机数。令 ,,,。
若 ,在上一题中是否会遇到问题?
用乘法同余法生成一串四个三位随机整数及相应的随机数。令 ,,。
已生成数字序列 0.54、0.73、0.98、0.11 和 0.68。用 的 Kolmogorov–Smirnov 检验,判断"这些数字在区间 [0, 1] 上均匀分布"这一假设能否被拒绝。
把例 7 中的 100 个两位随机数倒序排列,得到一组新的随机数。于是新集合中的第一个随机数为 0.43。用 的卡方检验,判断"这些数字在区间 [0, 1] 上均匀分布"这一假设能否被拒绝。
查明下列线性同余发生器能否达到最大周期;同时说明为获得该周期对 有何限制:
- (a) 混合同余法,取
- (b) 乘法同余发生器,取
- (c) 混合同余发生器,取
- (d) 乘法同余发生器,取
用混合同余法生成一串三个两位随机整数及相应的随机数,取 ,。
用混合同余法生成一串介于 0 与 24 之间的三个两位随机整数及相应的随机数,取 ,。
编写一个计算机程序,用乘法同余法产生四位随机数。允许用户输入 和 的取值。
若在习题 中 ,生成该序列中的第一个随机数。计算到小数点后四位。
调查你可接触到的一台计算机上的电子表格程序中的随机数发生器。在许多电子表格中,随机数是由名为 RAND 或 @RAND 的函数产生的。
- (a) 查阅用户手册,看它是否说明了随机数是如何生成的。
- (b) 编写宏来实施本章所述的每一项检验。生成 100 组随机数,每组含 1000 个随机数。对每组随机数实施每一项检验。得出结论。
考虑在下列情形下的乘法同余发生器:
- (a)
- (b)
- (c)
- (d)
在每种情形下生成足够的取值以完成一个循环。可以得出什么结论?是否达到了最大周期?
L’Ecuyer [1988] 给出了一个组合三个乘法发生器的发生器,其中 157,,且 。该发生器的周期约为 。用这个组合发生器生成 5 个随机数,各基本发生器的初始种子取 和 。
把本章所述的检验应用于上一习题给出的发生器。
利用本章所述的原理,设计你自己的线性同余随机数发生器。
利用本章所述的原理,设计你自己的组合线性同余随机数发生器。
用本章中学到的程序,对下列数字序列作均匀性与独立性检验:0.594, 0.928, 0.515, 0.055, 0.507, 0.351, 0.262, 0.797, 0.788, 0.442, 0.097, 0.798, 0.227, 0.127, 0.474, 0.825, 0.007, 0.182, 0.929, 0.852.
在某些应用中,有必要能够快速地在伪随机数序列中向前跳跃,而不必实际生成其间的全部取值。
- (a) 对 的线性同余发生器,证明 mod 。
- (b) 接着证明 mod mod mod m(这一结果很有用,因为 mod m 可以预先算出,从而便于从序列中任意一点向前跳跃 n 个随机数)。
- (c) 在例 3 中,利用这一结果计算 ,起始条件为 。用通常的方法计算 以核对你的答案。
产生良好的伪随机数发生器,远比看上去困难。例如,数学天才 John Von Neumann 提出了平方法(middle-square method)。要用平方法产生六位伪随机数,先以一个六位整数作为种子。把该数平方,抽取其中间的六位数字作为序列中的下一个数。通过反复平方当前数字并抽取中间六位数字来继续这一过程。若要得到 0 与 1 之间的数,可以在这六位数字之前放一个小数点。试算几个例子,以说明该方法可能如何遭遇惊人的失败(Von Neumann 本人已意识到这些问题)。
www.bcnn.net 上提供的资料清单
RandomNumberTools.xls