8 随机变量生成本章讨论从各种常用的连续分布与离散分布中抽样的方法。此前的讨论和示例表明,概率分布在刻画那些一般无法预测或存在不确定性的建模活动时很有用。例如,队列处的到达间隔时间(interarrival time)和服务时间(service time)以及产品需求,在相当程度上常常是无法预测的。通常,这类变量被建模为服从某个给定概率分布的随机变量(random variable),并且已有标准的统计程序可用于估计所假设分布的参数,以及检验所假定统计模型的有效性。
在本章中,我们假定一个分布已经完全指定,并寻求从该分布生成样本的方法,以用作仿真模型(simulation model)的输入。本章的目的是解释并举例说明若干广泛使用的随机变量生成(random variate generation)技术,而不是要对最高效的技术作一份最新进展的综述。在实践中,大多数仿真建模人员会使用编程库中已有的例程,或者仿真语言内置的例程。然而,有些编程语言并未为所有常用分布提供内置例程,有些计算机配置也没有随机变量生成库;在这些情况下,建模者必须自行构造一个可接受的例程。尽管发生这种情况的可能性很小,但了解随机变量生成究竟是如何进行的,仍然是值得的。
本章讨论逆变换法(inverse-transform technique),并较为简要地讨论接受-拒绝法(acceptance-rejection technique)和特殊性质。另一种技术——组合法(composition method)——由 Devroye [1986]、Dagpunar [1988] 和 Law [2007] 讨论。本章所有技术都假定可以方便地获得 [0, 1] 上的均匀随机数源 R 1 , R 2 , … R_{1} , R_{2} , \ldots R 1 , R 2 , … R i R_{i} R i
f R ( x ) = { 1 , 0 ≤ x ≤ 1 0 , otherwise
f_{R} (x) = \left\{\begin{array}{l l} 1, & 0 \leq x \leq 1 \\ 0, & \text{otherwise} \end{array} \right.
f R ( x ) = { 1 , 0 , 0 ≤ x ≤ 1 otherwise cdf 为
F R ( x ) = { 0 , x < 0 x , 0 ≤ x ≤ 1 1 , x > 1
F_{R} (x) = \left\{\begin{array}{l l} 0, & x < 0 \\ x, & 0 \leq x \leq 1 \\ 1, & x > 1 \end{array} \right.
F R ( x ) = ⎩ ⎨ ⎧ 0 , x , 1 , x < 0 0 ≤ x ≤ 1 x > 1 在本章中,R 与 R 1 , R 2 , … R_{1} , R_{2} , \ldots R 1 , R 2 , … www.bcnn.net 上的电子表格 RandomNumberTools.xls 中找到。
1 逆变换法 逆变换法可用于从指数分布、均匀分布、Weibull 分布和三角分布中抽样,也可用于从经验分布中抽样。此外,它还是从大量离散分布中抽样的基本原理。本节先以指数分布为例详细说明该方法,然后再将其应用于其他分布。就计算而言,它是最直接的方法,但并不总是最高效的方法。
1.1 指数分布 指数分布的概率密度函数(pdf)为
f ( x ) = { λ e − λ x , x ≥ 0 0 , x < 0
f (x) = \left\{\begin{array}{l l} \lambda e^{- \lambda x}, & x \geq 0 \\ 0, & x < 0 \end{array} \right.
f ( x ) = { λ e − λ x , 0 , x ≥ 0 x < 0 累积分布函数(cdf)为
F ( x ) = ∫ − ∞ x f ( t ) d t = { 1 − e − λ x , x ≥ 0 0 , x < 0
F (x) = \int_{- \infty} ^ {x} f (t) d t = \left\{\begin{array}{l l} 1 - e^{- \lambda x}, & x \geq 0 \\ 0, & x < 0 \end{array} \right.
F ( x ) = ∫ − ∞ x f ( t ) d t = { 1 − e − λ x , 0 , x ≥ 0 x < 0 参数 λ 可以解释为单位时间内发生次数的均值。例如,若到达间隔时间 X 1 , X 2 , X 3 , . . . X_{1} , X_{2} , X_{3} , . . . X 1 , X 2 , X 3 , ...
E ( X i ) = 1 λ
E (X_{i}) = \frac {1}{\lambda}
E ( X i ) = λ 1 因此 1 / λ 1 / \lambda 1/ λ X 1 , X 2 , X 3 , . . . X_{1} , X_{2} , X_{3} , . . . X 1 , X 2 , X 3 , ...
原则上,逆变换法可以用于任何分布,但只有当 cdf(F ( x ) F ( x ) F ( x ) F − 1 F^{- 1} F − 1 F − 1 F^{- 1} F − 1 r = F ( x ) r = F ( {\boldsymbol {x}} ) r = F ( x ) 1 / F 1 / F 1/ F
步骤 1. 计算所求随机变量 X X X
对于指数分布,cdf 为 F ( x ) = 1 − e − λ x , x ≥ 0 F ( x ) = 1 - e^{- \lambda x} , x \geq 0 F ( x ) = 1 − e − λ x , x ≥ 0
步骤 2. 在 X 的取值范围内令 F ( X ) = R F ( X ) = R F ( X ) = R
对于指数分布,它变为在范围 X ≥ 0 X \geq 0 X ≥ 0 1 − e − λ X = R 1 - e^{- \lambda X} = R 1 − e − λ X = R 1 − e − λ X 1 - e^{- \lambda X} 1 − e − λ X
步骤 3. 将方程 F ( X ) = R F ( X ) = R F ( X ) = R
对于指数分布,求解过程如下:
1 − e − λ X = R e − λ X = 1 − R − λ X = ln ( 1 − R ) X = − 1 λ ln ( 1 − R ) (1)
\begin{array}{c} 1 - e^{- \lambda X} = R \\ e^{- \lambda X} = 1 - R \\ - \lambda X = \ln (1 - R) \\ X = - \frac {1}{\lambda} \ln (1 - R) \end{array}\tag{1}
1 − e − λ X = R e − λ X = 1 − R − λ X = ln ( 1 − R ) X = − λ 1 ln ( 1 − R ) ( 1 ) 式 (1) 称为指数分布的随机变量生成器(random-variate generator)。一般地,式 (1) 写作 X = F − 1 ( R ) X = F^{- 1} ( R ) X = F − 1 ( R )
步骤 4. 生成(按需要)均匀随机数 R 1 , R 2 , R 3 , . . . R_{1} , R_{2} , R_{3} , . . . R 1 , R 2 , R 3 , ...
X i = F − 1 ( R i )
X_{i} = F^{- 1} (R_{i})
X i = F − 1 ( R i ) 对于指数情形,由式 (1) 得 F − 1 ( R ) = ( − 1 / λ ) ln ( 1 − R ) F^{- 1} ( R ) = ( - 1 / \lambda ) \ln ( 1 - R ) F − 1 ( R ) = ( − 1/ λ ) ln ( 1 − R )
X i = − 1 λ ln ( 1 − R i ) (2)
X_{i} = - \frac {1}{\lambda} \ln (1 - R_{i})\tag{2}
X i = − λ 1 ln ( 1 − R i ) ( 2 ) 其中 i = 1 , 2 , 3 , … i = 1 , 2 , 3 , \dots i = 1 , 2 , 3 , … 1 − R i 1 - R_{i} 1 − R i R i R_{i} R i
X i = − 1 λ ln R i (3)
X_{i} = - \frac {1}{\lambda} \ln R_{i}\tag{3}
X i = − λ 1 ln R i ( 3 ) 这一替代做法之所以合理,是因为 R i R_{i} R i 1 − R i 1 - R_{i} 1 − R i
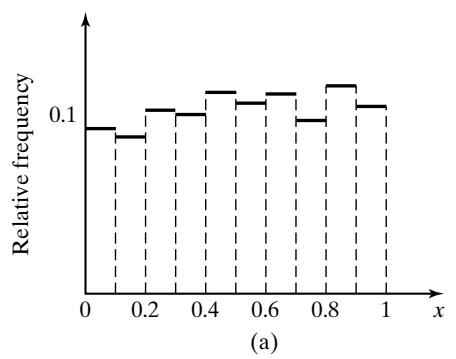
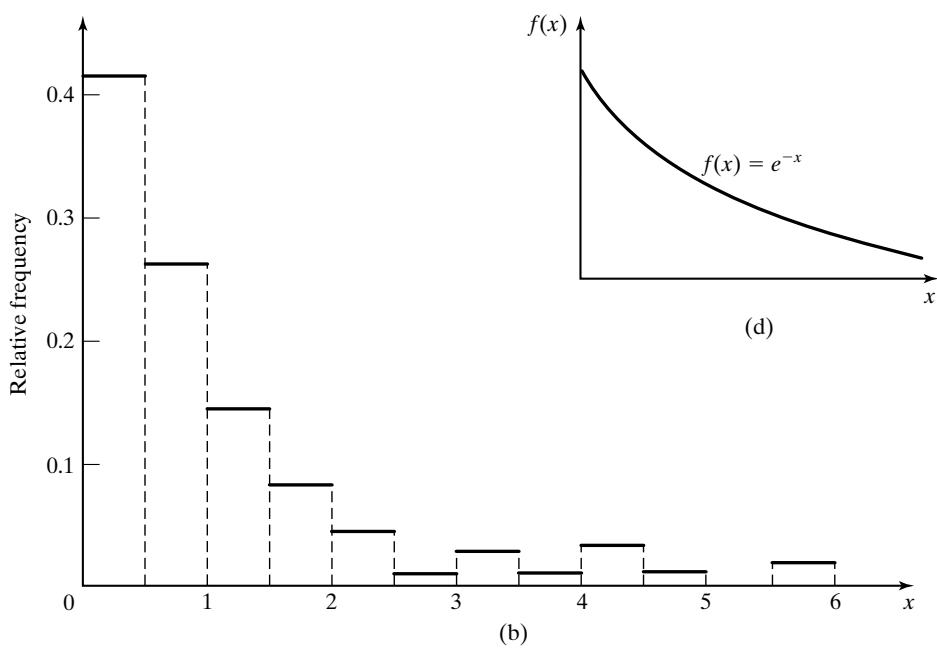
例 1 表 1 给出了取自表 A.1 的一串随机数,以及由式 (2)(取 λ = 1 \lambda = 1 λ = 1 X i , X_{i} , X i , R 1 , R 2 , … , R 200 R_{1} , R_{2} , \ldots , R_{200} R 1 , R 2 , … , R 200 X 1 , X 2 , … , X 200 X_{1} , X_{2} , \ldots , X_{200} X 1 , X 2 , … , X 200
表 1 给定随机数 R i R_{i} R i X i X_{i} X i
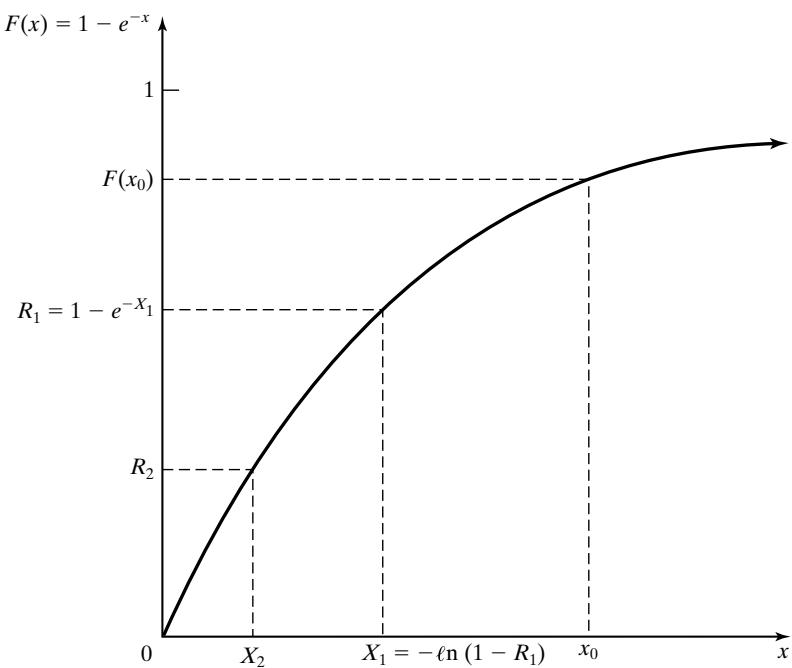
图 2 给出了逆变换法的图解解释。图中所示的 cdf 为 F ( x ) = 1 − e − x F ( x ) = 1 - e^{- x} F ( x ) = 1 − e − x λ = 1 \lambda = 1 λ = 1 F ( x ) F ( x ) F ( x ) X 1 X_{1} X 1 R 1 R_{1} R 1 R 1 R_{1} R 1 X 1 X_{1} X 1 R 1 R_{1} R 1 X 1 X_{1} X 1
R 1 = 1 − e − X 1
R_{1} = 1 - e ^ {- X_{1}}
R 1 = 1 − e − X 1 以及
X 1 = − ln ( 1 − R 1 )
X_{1} = - \ln (1 - R_{1})
X 1 = − ln ( 1 − R 1 ) 一般地,该关系写作
R 1 = F ( X 1 )
R_{1} = F (X_{1})
R 1 = F ( X 1 ) 以及
X 1 = F − 1 ( R 1 )
X_{1} = F^{- 1} (R_{1})
X 1 = F − 1 ( R 1 ) 由这一过程生成的随机变量 X 1 X_{1} X 1 x 0 x_{0} x 0
P ( X 1 ≤ x 0 ) = P ( R 1 ≤ F ( x 0 ) ) = F ( x 0 ) (4)
P (X_{1} \leq x_{0}) = P (R_{1} \leq F (x_{0})) = F (x_{0})\tag{4}
P ( X 1 ≤ x 0 ) = P ( R 1 ≤ F ( x 0 )) = F ( x 0 ) ( 4 ) 要理解式 (4) 中的第一个等号,请参见图 2,其中固定的数 x 0 x_{0} x 0 F ( x 0 ) F ( x_{0} ) F ( x 0 ) X 1 ≤ x 0 X_{1} \leq x_{0} X 1 ≤ x 0 R 1 ≤ F ( x 0 ) R_{1} \leq F ( x_{0} ) R 1 ≤ F ( x 0 ) 0 ≤ F ( x 0 ) ≤ 1 0 \leq F ( x_{0} ) \leq 1 0 ≤ F ( x 0 ) ≤ 1 R 1 R_{1} R 1 X 1 X_{1} X 1 F F F X 1 X_{1} X 1
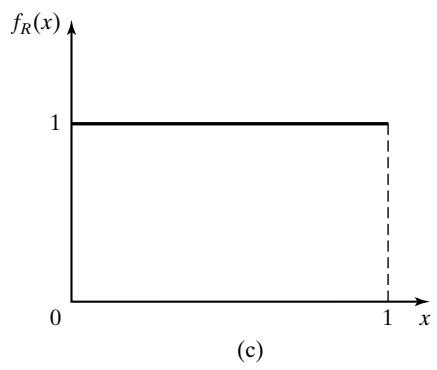
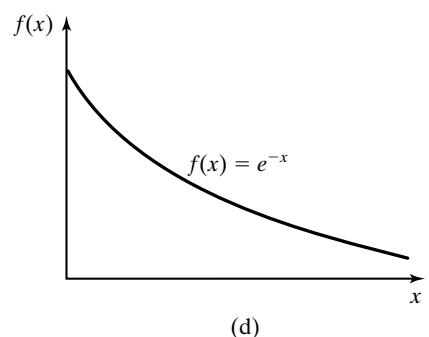
图 1 (a) 200 个均匀随机数的经验直方图;(b) 200 个指数随机变量的经验直方图;(c) [0, 1] 上的理论均匀密度;(d) 均值为 1 的理论指数密度。
1.2 均匀分布 考虑一个在区间 [a, b] 上均匀分布的随机变量 X。生成 X 的一个合理设想是
X = a + ( b − a ) R (5)
X = a + (b - a) R\tag{5}
X = a + ( b − a ) R ( 5 ) 图 2 逆变换法的图解。
(请记住,R 始终是 [0, 1] 上的随机数。)X 的 pdf 为
f ( x ) = { 1 b − a , a ≤ x ≤ b 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {1}{b - a}, & a \leq x \leq b \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = { b − a 1 , 0 , a ≤ x ≤ b otherwise 式 (5) 的推导沿用第 1.1 节的步骤 1 至步骤 3:
步骤 1. cdf 为
F ( x ) = { 0 , x < a x − a b − a , a ≤ x ≤ b 1 , x > b
F (x) = \left\{\begin{array}{l l} 0, & x < a \\ \frac {x - a}{b - a}, & a \leq x \leq b \\ 1, & x > b \end{array} \right.
F ( x ) = ⎩ ⎨ ⎧ 0 , b − a x − a , 1 , x < a a ≤ x ≤ b x > b 步骤 2. 令 F ( X ) = ( X − a ) / ( b − a ) = R F ( X ) = ( X - a ) / ( b - a ) = R F ( X ) = ( X − a ) / ( b − a ) = R
步骤 3. 就 R 解出 X 得 X = a + ( b − a ) R , X = a + ( b - a ) R , X = a + ( b − a ) R ,
1.3 Weibull 分布 Weibull 分布是作为机器或电子元件失效时间的模型而引入的。当位置参数 ν 取 0 时:
f ( x ) = { β α β x β − 1 e − ( x / α ) β , x ≥ 0 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {\beta}{\alpha^{\beta}} x^{\beta - 1} e ^ {- (x / \alpha) ^ {\beta}}, & x \geq 0 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = { α β β x β − 1 e − ( x / α ) β , 0 , x ≥ 0 otherwise 其中 α > 0 \alpha > 0 α > 0 β > 0 \beta > 0 β > 0
步骤 1. cdf 为 F ( X ) = 1 − e − ( x / α ) β , x ≥ 0 F ( X ) = 1 - e ^ {- (x / \alpha) ^ {\beta}} , x \geq 0 F ( X ) = 1 − e − ( x / α ) β , x ≥ 0
步骤 2. 令 F ( X ) = 1 − e − ( X / α ) β = R . F ( X ) = 1 - e ^ {- ( X / \alpha) ^ {\beta}} = R . F ( X ) = 1 − e − ( X / α ) β = R .
步骤 3. 就 R 解出 X 得
X = α [ − ln ( 1 − R ) ] 1 / β (6)
X = \alpha [ - \ln (1 - R) ] ^ {1 / \beta}\tag{6}
X = α [ − ln ( 1 − R ) ] 1/ β ( 6 ) 式 (6) 的推导留给读者作为习题 10。比较式 (6) 与式 (1) 可以看出,若 X 是 Weibull 随机变量,则 X β X^{\beta} X β α β \alpha^{\beta} α β μ , \mu , μ , Y 1 / β Y^{1 / \beta} Y 1/ β β \beta β α = μ 1 / β \alpha = \mu^{1 / \beta} α = μ 1/ β
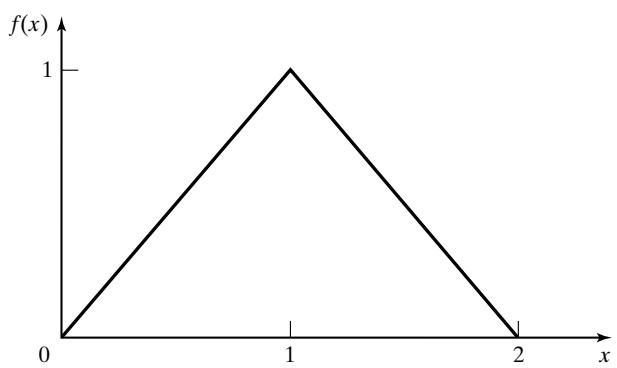
1.4 三角分布 考虑一个 pdf 为
f ( x ) = { x , 0 ≤ x ≤ 1 2 − x , 1 < x ≤ 2 0 , otherwise
f (x) = \left\{\begin{array}{l l} x, & 0 \leq x \leq 1 \\ 2 - x, & 1 < x \leq 2 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = ⎩ ⎨ ⎧ x , 2 − x , 0 , 0 ≤ x ≤ 1 1 < x ≤ 2 otherwise 的随机变量 X,如图 3 所示。这个分布称为三角分布(triangular distribution),其端点为 ( 0 , 2 ) ( 0 , 2 ) ( 0 , 2 )
F ( x ) = { 0 , x ≤ 0 x 2 2 , 0 < x ≤ 1 1 − ( 2 − x ) 2 2 , 1 < x ≤ 2 1 , x > 2
F (x) = \left\{\begin{array}{l l} 0, & x \leq 0 \\ \frac {x^{2}}{2}, & 0 < x \leq 1 \\ 1 - \frac {(2 - x) ^ {2}}{2}, & 1 < x \leq 2 \\ 1, & x > 2 \end{array} \right.
F ( x ) = ⎩ ⎨ ⎧ 0 , 2 x 2 , 1 − 2 ( 2 − x ) 2 , 1 , x ≤ 0 0 < x ≤ 1 1 < x ≤ 2 x > 2 对于 0 ≤ X ≤ 1 0 \leq X \leq 1 0 ≤ X ≤ 1
R = X 2 2 (7)
R = \frac {X^{2}}{2}\tag{7}
R = 2 X 2 ( 7 ) 图 3 某一特定三角分布的密度函数。
而对于 1 ≤ X ≤ 2 1 \leq X \leq 2 1 ≤ X ≤ 2
R = 1 − ( 2 − X ) 2 2 (8)
R = 1 - \frac {(2 - X) ^ {2}}{2}\tag{8}
R = 1 − 2 ( 2 − X ) 2 ( 8 ) 在式 ( 7 ) ( 7 ) ( 7 ) 0 ≤ X ≤ 1 0 \leq X \leq 1 0 ≤ X ≤ 1 0 ≤ R ≤ 1 2 \begin{array} {r} {0 \leq R \leq \frac {1} {2}} \end{array} 0 ≤ R ≤ 2 1 X = 2 R X = {\sqrt {2 R}} X = 2 R 1 ≤ X ≤ 2 1 \leq X \leq 2 1 ≤ X ≤ 2 1 2 ≤ R ≤ 1 \begin{array} {r} {\frac {1} {2} \leq R \leq 1} \end{array} 2 1 ≤ R ≤ 1 X = 2 − 2 ( 1 − R ) X = 2 - \sqrt {2 ( 1 - R )} X = 2 − 2 ( 1 − R )
X = { 2 R , 0 ≤ R ≤ 1 2 2 − 2 ( 1 − R ) , 1 2 < R ≤ 1 (9)
X = \left\{\begin{array}{l l} \sqrt {2 R}, & 0 \leq R \leq \frac {1}{2} \\ 2 - \sqrt {2 (1 - R)}, & \frac {1}{2} < R \leq 1 \end{array} \right.\tag{9}
X = { 2 R , 2 − 2 ( 1 − R ) , 0 ≤ R ≤ 2 1 2 1 < R ≤ 1 ( 9 ) 习题 2、3 和 4 让读者练习处理其他三角分布。注意,若随机变量 X 的 pdf 和 cdf 是分段给出的(即在 X 取值范围的不同部分需要不同的公式),那么应用逆变换法生成 X 时,将得到在 R 取值范围的不同部分上各不相同的公式,如式 (9) 所示。
1.5 经验连续分布 若建模者未能找到一个能为输入数据提供良好模型的理论分布,那么就有必要使用数据的经验分布(empirical distribution)。一种可能做法是直接对观测到的数据本身重抽样。这称为使用经验分布,当已知输入过程只取有限多个值时,这样做尤其合理。本章第 1.7 节给出了这类情形的一个例子,以及生成随机输入的一种方法。
另一方面,若数据被认为取自一个连续取值的输入过程,那么在观测数据点之间作插值以填补空缺就是合理的做法。本节描述一种定义连续经验分布并从中生成数据的方法。
例 2 已经收集到五组消防队响应时间(以分钟计)的观测值,用以开展一项仿真研究,考察可能的备选人员配置与班组排班政策。数据为
2.76 1.83 0.80 1.45 1.24
\begin{array}{c c c c c} 2. 76 & 1. 83 & 0. 80 & 1. 45 & 1. 24 \end{array}
2.76 1.83 0.80 1.45 1.24 在收集更多数据之前,希望先建立一个初步的仿真模型,其中的响应时间分布基于这五组观测值。因此,需要一种从响应时间分布中生成随机变量的方法。初步假定响应时间 X 的取值范围为 0 ≤ X ≤ c . 0 \leq X \leq c . 0 ≤ X ≤ c . c ^ = max { X i : i = 1 , … , n } = 2.76 \widehat {c} = \operatorname* {m a x} \{X_{i} : i = 1 , \ldots , n \} = 2 . 76 c = max { X i : i = 1 , … , n } = 2.76 { X i , i = 1 , … , n } \{X_{i} , i = 1 , \dots , n \} { X i , i = 1 , … , n } n = 5 n = 5 n = 5
把数据由小到大排列,令 x ( 1 ) ≤ x ( 2 ) ≤ ⋅ ⋅ ⋅ ≤ x ( n ) x_{( 1 )} \leq x_{( 2 )} \leq \cdot \cdot \cdot \leq x_{( n )} x ( 1 ) ≤ x ( 2 ) ≤ ⋅ ⋅ ⋅ ≤ x ( n ) x ( 0 ) = 0 x_{( 0 )} = 0 x ( 0 ) = 0 x ( i − 1 ) < x ≤ x ( i ) x_{( i - 1 )} < x \leq x_{( i )} x ( i − 1 ) < x ≤ x ( i ) 1 / n = 1 / 5 1 / n = 1 / 5 1/ n = 1/5 F ^ ( x ) \widehat F ( x ) F ( x )
a i = x ( i ) − x ( i − 1 ) i / n − ( i − 1 ) / n = x ( i ) − x ( i − 1 ) 1 / n
a_{i} = \frac {x_{(i)} - x_{(i - 1)}}{i / n - (i - 1) / n} = \frac {x_{(i)} - x_{(i - 1)}}{1 / n}
a i = i / n − ( i − 1 ) / n x ( i ) − x ( i − 1 ) = 1/ n x ( i ) − x ( i − 1 ) 逆 cdf 由下式计算:
X = F ^ − 1 ( R ) = x ( i − 1 ) + a i ( R − ( i − 1 ) n ) (10)
X = \widehat {F} ^ {- 1} (R) = x_{(i - 1)} + a_{i} \left(R - \frac {(i - 1)}{n}\right)\tag{10}
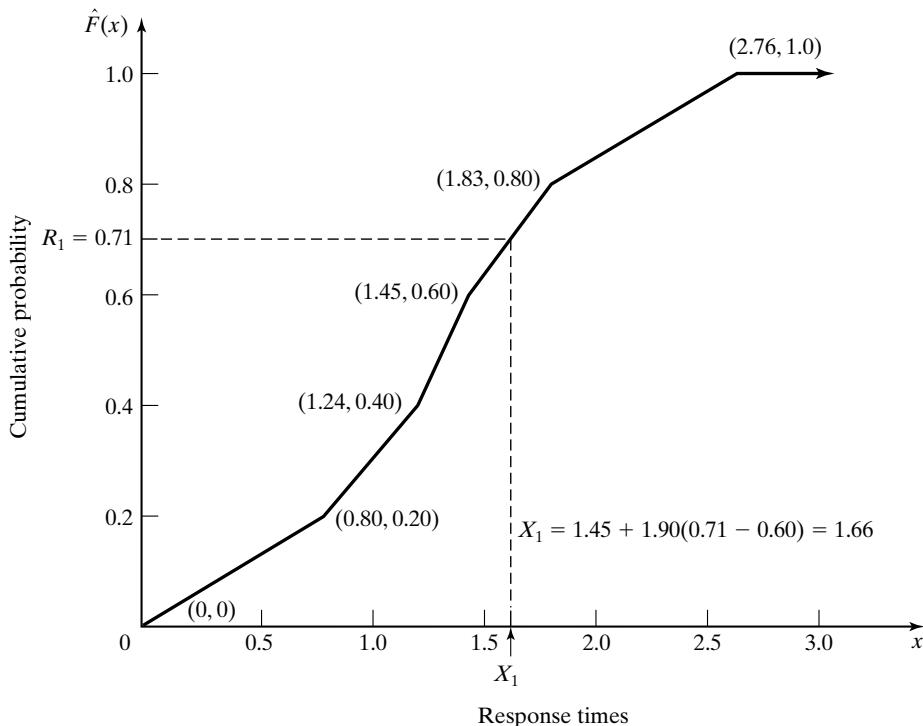
X = F − 1 ( R ) = x ( i − 1 ) + a i ( R − n ( i − 1 ) ) ( 10 ) 其中 ( i − 1 ) / n < R ≤ i / n ( i - 1 ) / n < R \leq i / n ( i − 1 ) / n < R ≤ i / n R 1 = 0.71 R_{1} = 0 . 71 R 1 = 0.71 R 1 R_{1} R 1 3 / 5 = 0.60 3 / 5 = 0 . 60 3/5 = 0.60 4 / 5 = 0.80 4 / 5 = 0 . 80 4/5 = 0.80
X 1 = x ( 4 − 1 ) + a 4 ( R 1 − ( 4 − 1 ) / n ) = 1.45 + 1.90 ( 0.71 − 0.60 ) = 1.66
\begin{array}{r l} X_{1} & = x_{(4 - 1)} + a_{4} (R_{1} - (4 - 1) / n) \\ & = 1. 45 + 1. 90 (0. 71 - 0. 60) = 1. 66 \end{array}
X 1 = x ( 4 − 1 ) + a 4 ( R 1 − ( 4 − 1 ) / n ) = 1.45 + 1.90 ( 0.71 − 0.60 ) = 1.66 生成过程的图解说明请参见图 4。
表 2 消防队响应时间数据汇总
图 4 消防队响应时间的经验 cdf。
在例 2 中,经验 cdf 把每一个数据点都表示了出来。若可以获得很大的样本(借助自动化数据采集,样本量可以达到数百乃至数万),那么先把数据汇总成区间数少得多的频数分布(frequency distribution),再对该频数分布拟合一条连续经验 cdf,可能更为方便(计算效率也更高)。为此只需对式 (10) 作一点点推广。现在第 i 段线段的斜率为:
a i = x ( i ) − x ( i − 1 ) c i − c i − 1
a_{i} = \frac {x_{(i)} - x_{(i - 1)}}{c_{i} - c_{i - 1}}
a i = c i − c i − 1 x ( i ) − x ( i − 1 ) 其中 c i c_{i} c i x ( i − 1 ) < x ≤ x ( i ) x_{( i - 1 )} < x \leq x_{( i )} x ( i − 1 ) < x ≤ x ( i )
X = F ^ − 1 ( R ) = x ( i − 1 ) + a i ( R − c i − 1 ) (11)
X = \widehat {F} ^ {- 1} (R) = x_{(i - 1)} + a_{i} (R - c_{i - 1})\tag{11}
X = F − 1 ( R ) = x ( i − 1 ) + a i ( R − c i − 1 ) ( 11 ) 其中 c i − 1 < R ≤ c i c_{i - 1} < R \leq c_{i} c i − 1 < R ≤ c i
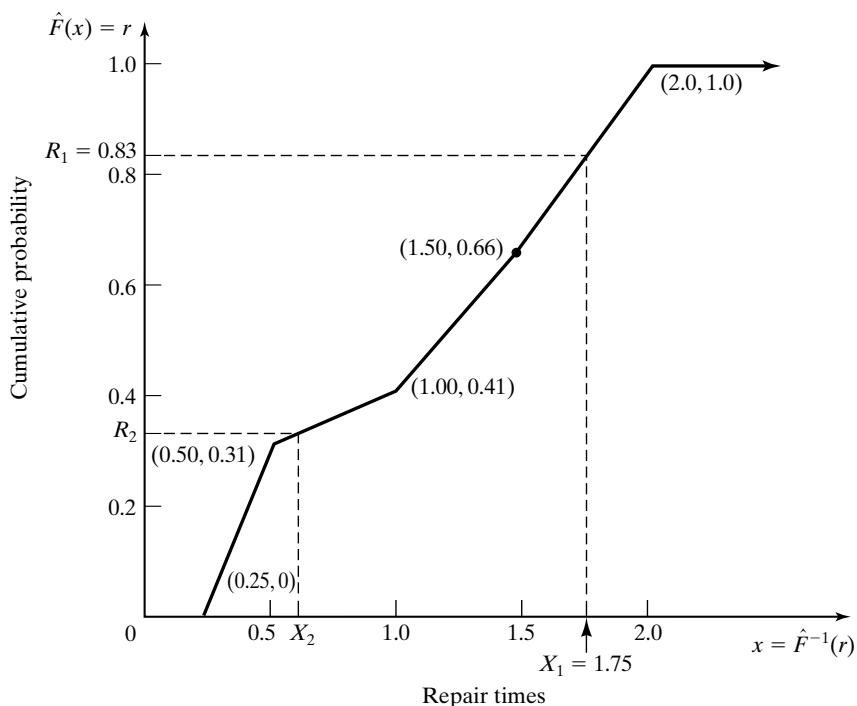
例 3 假定已经收集到 100 个机器修理时间。数据按各个区间中的观测值个数汇总于表 3。例如,0 至 0.5 小时之间有 31 个观测值,0.5 至 1 小时之间有 10 个,依此类推。假定已知所有修理至少需要 15 分钟,因而总有 X ≥ 0.25 X \geq 0 . 25 X ≥ 0.25 x ( 0 ) = 0.25 x_{( 0 )} = 0 . 25 x ( 0 ) = 0.25
表 3 修理时间数据汇总
图 5 由修理时间数据的经验分布函数生成随机变量(X ≥ 0.25 X \geq 0 . 25 X ≥ 0.25
例如,假定所生成的第一个随机数为 R 1 = 0.83 R_{1} = 0 . 83 R 1 = 0.83 R 1 R_{1} R 1 c 3 = 0.66 c_{3} = 0 . 66 c 3 = 0.66 c 4 = 1.00 c_{4} = 1 . 00 c 4 = 1.00
X 1 = x ( 4 − 1 ) + a 4 ( R 1 − c 4 − 1 ) = 1.5 + 1.47 ( 0.83 − 0.66 ) = 1.75 (12)
X_{1} = x_{(4 - 1)} + a_{4} \left(R_{1} - c_{4 - 1}\right) = 1. 5 + 1. 47 (0. 83 - 0. 66) = 1. 75\tag{12}
X 1 = x ( 4 − 1 ) + a 4 ( R 1 − c 4 − 1 ) = 1.5 + 1.47 ( 0.83 − 0.66 ) = 1.75 ( 12 ) 再举一个例子,假定 R 2 = 0.33 R_{2} = 0 . 33 R 2 = 0.33 c 1 = 0.31 < R 2 ≤ 0.41 = c 2 c_{1} = 0 . 31 < R_{2} \leq 0 . 41 = c_{2} c 1 = 0.31 < R 2 ≤ 0.41 = c 2
X 2 = x ( 1 ) + a 2 ( R 2 − c 1 ) = 0.5 + 5.0 ( 0.33 − 0.31 ) = 0.6
\begin{array}{r l} X_{2} & = x_{(1)} + a_{2} (R_{2} - c_{1}) \\ & = 0. 5 + 5. 0 (0. 33 - 0. 31) \\ & = 0. 6 \end{array}
X 2 = x ( 1 ) + a 2 ( R 2 − c 1 ) = 0.5 + 5.0 ( 0.33 − 0.31 ) = 0.6 点 ( R 2 = 0.33 , X 2 = 0.6 ) ( R_{2} = 0 . 33 , X_{2} = 0 . 6 ) ( R 2 = 0.33 , X 2 = 0.6 )
现在重新审视表 3 中的数据。数据的取值被限制在 0.25 ≤ X ≤ 2.0 0 . 25 \leq X \leq 2 . 0 0.25 ≤ X ≤ 2.0 0 ≤ X < ∞ 0 \leq X < \infty 0 ≤ X < ∞
当数据以频数区间的形式汇总时,建议采用相对较短的区间,因为这样做能更准确地刻画底层的 cdf。例如,对于表 3 中的修理时间数据,其观测值个数为 n = 100 n = 100 n = 100
以下几点值得注意:
这一过程的计算机化版本会随着区间个数 n 的增加而变得低效。系统化的计算机版本常称为查表生成方案(table-lookup generation scheme),因为给定一个 R 的取值,计算机程序必须在一组 c i c_{i} c i c i − 1 < R ≤ c i
c_{i - 1} < R \leq c_{i}
c i − 1 < R ≤ c i 的区间 i。区间越多,若按这里所述的粗略方式实现,查找所需的时间平均而言就越长。编程实现该过程时,分析人员应当权衡估计 cdf 的准确性与计算效率之间的取舍。若可以获得大量的观测值,分析人员很可能决定把观测值归入 20 至 50 个区间,然后采用例 3 的过程——或者也可以采用更高效的查表过程,例如 Law [2007] 所描述的那种。
在例 2 中,假定响应时间 X 满足 0 ≤ X ≤ 2.76 0 \leq X \leq 2 . 76 0 ≤ X ≤ 2.76 x ( 0 ) = 0 x_{( 0 )} = 0 x ( 0 ) = 0 x ( 5 ) = 2.76 x_{( 5 )} = 2 . 76 x ( 5 ) = 2.76 0.25 ≤ X ≤ 3.0
0. 25 \leq X \leq 3. 0
0.25 ≤ X ≤ 3.0 ——那么就应当用点 x ( 0 ) = 0.25 x_{( 0 )} = 0 . 25 x ( 0 ) = 0.25 x ( 6 ) = 3.0 x_{( 6 )} = 3 . 0 x ( 6 ) = 3.0 x ( 6 ) x_{( 6 )} x ( 6 ) 1 / 6 = 0.167 1 / 6 = 0 . 167 1/6 = 0.167
1.6 无闭式逆函数的连续分布 有不少有用的连续分布,其 cdf 或其逆函数没有闭式表达式;例子包括正态分布、伽马分布和贝塔分布。因此,人们常说逆变换法不能用于这些分布的随机变量生成。但只要我们愿意近似逆 cdf,或者对 cdf 作数值积分并加以搜索,这一方法实际上是可以用的。尽管这种做法听上去不够精确,请注意即使是闭式逆函数,在计算机上求值时也需要作数值近似。例如,通过逆 cdf X = F − 1 ( R ) = − ln ( 1 − R ) / λ X = F^{- 1} ( R ) = - \ln ( 1 - R ) / \lambda X = F − 1 ( R ) = − ln ( 1 − R ) / λ
为说明这一思想,考虑 Schmeiser [1979] 提出的标准正态分布逆 cdf 的一个简单近似:
X = F − 1 ( R ) ≈ R 0.135 − ( 1 − R ) 0.135 0.1975
X = F^{- 1} (R) \approx \frac {R^{0 . 135} - (1 - R) ^ {0 . 135}}{0 . 1975}
X = F − 1 ( R ) ≈ 0.1975 R 0.135 − ( 1 − R ) 0.135 当 0.0013499 ≤ R ≤ 0.9986501 0 . 0013499 \leq R \leq 0 . 9986501 0.0013499 ≤ R ≤ 0.9986501
表 4 标准正态分布的近似逆函数与精确值(保留四位小数)比较
1.7 离散分布 所有离散分布都可以用逆变换法生成,或者通过查表过程以数值方式生成,或者在某些情况下以代数方式生成(最终的生成方案为一个公式)。对某些分布还会使用其他技术,例如用于二项分布的卷积技术(convolution technique)。其中一些方法将在后面几节讨论。本小节给出若干例子,涵盖经验分布以及两个标准离散分布——(离散)均匀分布和几何分布。Bratley、Fox 和 Schrage [1996] 以及 Ripley [1987] 给出了这些分布和其他分布的高效查表过程。
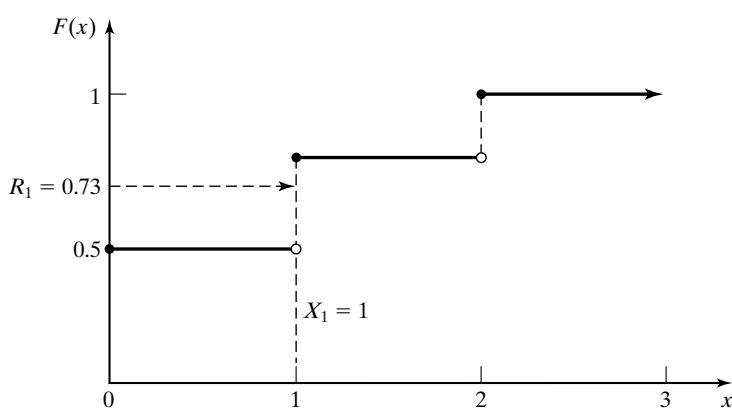
例 4:经验离散分布 每天结束时,IHW 公司装卸码头上的发货批次要么是 0,要么是 1,要么是 2,其观察到的相对频数分别为 0.50、0.30 和 0.20。公司内部的顾问(consultants)受命开发一个模型,以改进装卸与搬运作业的效率;作为该模型的一部分,他们需要能够生成代表每天结束时码头发货批次数的取值 X。顾问们决定把 X 建模为一个离散随机变量,其分布如表 5 所示、见图 6。
表 5 发货批次 X 的分布
概率质量函数(pmf)p ( x ) p(x) p ( x )
p ( 0 ) = P ( X = 0 ) = 0.50 p ( 1 ) = P ( X = 1 ) = 0.30 p ( 2 ) = P ( X = 2 ) = 0.20
\begin{array}{l} p (0) = P (X = 0) = 0. 50 \\ p (1) = P (X = 1) = 0. 30 \\ p (2) = P (X = 2) = 0. 20 \end{array}
p ( 0 ) = P ( X = 0 ) = 0.50 p ( 1 ) = P ( X = 1 ) = 0.30 p ( 2 ) = P ( X = 2 ) = 0.20 cdf(F ( x ) = P ( X ≤ x ) F ( x ) = P ( X \leq x ) F ( x ) = P ( X ≤ x )
F ( x ) = { 0 x < 0 0.5 0 ≤ x < 1 0.8 1 ≤ x < 2 1.0 2 ≤ x
F (x) = \left\{\begin{array}{l l} 0 & x < 0 \\ 0. 5 & 0 \leq x < 1 \\ 0. 8 & 1 \leq x < 2 \\ 1. 0 & 2 \leq x \end{array} \right.
F ( x ) = ⎩ ⎨ ⎧ 0 0.5 0.8 1.0 x < 0 0 ≤ x < 1 1 ≤ x < 2 2 ≤ x 请记住,离散随机变量的 cdf 总是由若干水平线段组成,在该随机变量可能取到的各个点 x 上,线段发生大小为 p ( x ) p(x) p ( x ) x = 0 x = 0 x = 0 p ( 0 ) = 0.5 p ( 0 ) = 0 . 5 p ( 0 ) = 0.5 x = 1 x = 1 x = 1 p ( 1 ) = 0.3 p ( 1 ) = 0 . 3 p ( 1 ) = 0.3 x = 2 x = 2 x = 2 p ( 2 ) = 0.2 p ( 2 ) = 0 . 2 p ( 2 ) = 0.2
图 6 发货批次 X 的 cdf。
对于离散随机变量的生成,逆变换法变成一个查表过程,但与连续变量的情形不同,它不需要插值。为说明这一过程,假定生成了 R 1 = 0.73 R_{1} = 0 . 73 R 1 = 0.73 R 1 = 0.73 R_{1} = 0 . 73 R 1 = 0.73 R 1 = 0.73 R_{1} = 0 . 73 R 1 = 0.73 X 1 = 1 X_{1} = 1 X 1 = 1
构造类似于表 6 的表格有助于实现这一查表过程。当生成 R 1 = 0.73 R_{1} = 0 . 73 R 1 = 0.73 R 1 R_{1} R 1 R = R 1 R = R_{1} R = R 1
F ( x i − 1 ) = r i − 1 < R ≤ r i = F ( x i ) (13)
F (x_{i - 1}) = r_{i - 1} < R \leq r_{i} = F (x_{i})\tag{13}
F ( x i − 1 ) = r i − 1 < R ≤ r i = F ( x i ) ( 13 ) 则置 X 1 = x i X_{1} = x_{i} X 1 = x i r 0 = 0 ; x 0 = − ∞ ; r_{0} = 0 ; x_{0} = - \infty ; r 0 = 0 ; x 0 = − ∞ ; x 1 , x 2 , … , x n x_{1} , x_{2} , \ldots , x_{n} x 1 , x 2 , … , x n r k = p ( x 1 ) + ⋅ ⋅ ⋅ + p ( x k ) , k = 1 , 2 , ⋅ ⋅ ⋅ , n . r_{k} = p ( x_{1} ) + \cdot \cdot \cdot + p ( x_{k} ) , k = 1 , 2 , \cdot \cdot \cdot , n . r k = p ( x 1 ) + ⋅ ⋅ ⋅ + p ( x k ) , k = 1 , 2 , ⋅ ⋅ ⋅ , n . n = 3 , x 1 = 0 , x 2 = 1 , n = 3 , x_{1} = 0 , x_{2} = 1 , n = 3 , x 1 = 0 , x 2 = 1 , x 3 = 2 ; x_{3} = 2 ; x 3 = 2 ; r 1 = 0.5 , r 2 = 0.8 , r_{1} = 0 . 5 , r_{2} = 0 . 8 , r 1 = 0.5 , r 2 = 0.8 , r 3 = 1.0 r_{3} = 1 . 0 r 3 = 1.0 r n = 1.0 r_{n} = 1 . 0 r n = 1.0
表 6 用于生成离散随机变量 X 的表
由于 r 1 = 0.5 < R 1 = 0.73 ≤ r 2 = 0.8 r_{1} = 0 . 5 < R_{1} = 0 . 73 \leq r_{2} = 0 . 8 r 1 = 0.5 < R 1 = 0.73 ≤ r 2 = 0.8 X 1 = x 2 = 1 X_{1} = x_{2} = 1 X 1 = x 2 = 1
X = { 0 , R ≤ 0.5 1 , 0.5 < R ≤ 0.8 2 , 0.8 < R ≤ 1.0
X = \left\{\begin{array}{l l} 0, & R \leq 0. 5 \\ 1, & 0. 5 < R \leq 0. 8 \\ 2, & 0. 8 < R \leq 1. 0 \end{array} \right.
X = ⎩ ⎨ ⎧ 0 , 1 , 2 , R ≤ 0.5 0.5 < R ≤ 0.8 0.8 < R ≤ 1.0 例 4 说明了查表过程;下一个例子说明可用于某些分布的代数方法。
例 5:离散均匀分布 考虑集合 { 1 , 2 , … , k } \{1 , 2 , \ldots , k \} { 1 , 2 , … , k }
p ( x ) = 1 k , x = 1 , 2 , … , k
p (x) = \frac {1}{k}, \quad x = 1, 2, \ldots , k
p ( x ) = k 1 , x = 1 , 2 , … , k 以及
F ( x ) = { 0 , x < 1 1 k , 1 ≤ x < 2 2 k , 2 ≤ x < 3 ⋮ ⋮ k − 1 k , k − 1 ≤ x < k 1 , k ≤ x
F (x) = \left\{\begin{array}{l l} 0, & x < 1 \\ \frac {1}{k}, & 1 \leq x < 2 \\ \frac {2}{k}, & 2 \leq x < 3 \\ \vdots & \vdots \\ \frac {k - 1}{k}, & k - 1 \leq x < k \\ 1, & k \leq x \end{array} \right.
F ( x ) = ⎩ ⎨ ⎧ 0 , k 1 , k 2 , ⋮ k k − 1 , 1 , x < 1 1 ≤ x < 2 2 ≤ x < 3 ⋮ k − 1 ≤ x < k k ≤ x 令 x i = i x_{i} = i x i = i r i = p ( 1 ) + ⋅ ⋅ ⋅ + p ( x i ) = F ( x i ) = i / k r_{i} = p ( 1 ) + \cdot \cdot \cdot + p ( x_{i} ) = F ( x_{i} ) = i / k r i = p ( 1 ) + ⋅ ⋅ ⋅ + p ( x i ) = F ( x i ) = i / k i = 1 , 2 , … , k i = 1 , 2 , \dots , k i = 1 , 2 , … , k
r i − 1 = i − 1 k < R ≤ r i = i k (14)
r_{i - 1} = \frac {i - 1}{k} < R \leq r_{i} = \frac {i}{k}\tag{14}
r i − 1 = k i − 1 < R ≤ r i = k i ( 14 ) 则通过令 X = i X = i X = i
i − 1 < R k ≤ i R k ≤ i < R k + 1 (15)
\begin{array}{c} i - 1 < R k \leq i \\R k \leq i < R k + 1 \end{array}\tag{15}
i − 1 < R k ≤ i R k ≤ i < R k + 1 ( 15 ) 记 ⌈ y ⌉ \lceil y \rceil ⌈ y ⌉ ⌈ 7.82 ⌉ = 8 , ⌈ 5.13 ⌉ = 6 \left\lceil 7 . 82 \right\rceil = 8 , \left\lceil 5 . 13 \right\rceil = 6 ⌈ 7.82 ⌉ = 8 , ⌈ 5.13 ⌉ = 6 ⌈ − 1.32 ⌉ = − 1 \lceil - 1 . 32 \rceil = - 1 ⌈ − 1.32 ⌉ = − 1 y ≥ 0 y \geq 0 y ≥ 0 ⌈ y ⌉ \lceil y \rceil ⌈ y ⌉
X = ⌈ R k ⌉ (16)
X = \lceil R k \rceil\tag{16}
X = ⌈ R k ⌉ ( 16 ) 例如,考虑生成一个在 { 1 , 2 , … , 10 } \{1 , 2 , \ldots , 10 \} { 1 , 2 , … , 10 } k = 10 k = 10 k = 10
R 1 = 0.78 X 1 = ⌈ 7.8 ⌉ = 8 R 2 = 0.03 X 2 = ⌈ 0.3 ⌉ = 1 R 3 = 0.23 X 3 = ⌈ 2.3 ⌉ = 3 R 4 = 0.97 X 4 = ⌈ 9.7 ⌉ = 10
\begin{array}{l l} R_{1} = 0. 78 & X_{1} = \lceil 7. 8 \rceil = 8 \\ R_{2} = 0. 03 & X_{2} = \lceil 0. 3 \rceil = 1 \\ R_{3} = 0. 23 & X_{3} = \lceil 2. 3 \rceil = 3 \\ R_{4} = 0. 97 & X_{4} = \lceil 9. 7 \rceil = 10 \end{array}
R 1 = 0.78 R 2 = 0.03 R 3 = 0.23 R 4 = 0.97 X 1 = ⌈ 7.8 ⌉ = 8 X 2 = ⌈ 0.3 ⌉ = 1 X 3 = ⌈ 2.3 ⌉ = 3 X 4 = ⌈ 9.7 ⌉ = 10 这里讨论的过程稍加修改即可生成取值范围为任意一组连续整数的离散均匀随机变量。习题 13 要求学生为这样一个情形设计生成过程。
例 6:几何分布 考虑 pmf 为
p ( x ) = p ( 1 − p ) x , x = 0 , 1 , 2 , …
p (x) = p (1 - p) ^ {x}, \quad x = 0, 1, 2, \dots
p ( x ) = p ( 1 − p ) x , x = 0 , 1 , 2 , … 的几何分布,其中 0 < p < 1 0 < p < 1 0 < p < 1
F ( x ) = ∑ j = 0 x p ( 1 − p ) j = p { 1 − ( 1 − p ) x + 1 } 1 − ( 1 − p ) = 1 − ( 1 − p ) x + 1
\begin{array}{l} F (x) = \sum_{j = 0} ^ {x} p (1 - p) ^ {j} \\ = \frac {p \{1 - (1 - p) ^ {x + 1} \}}{1 - (1 - p)} \\ = 1 - (1 - p) ^ {x + 1} \end{array}
F ( x ) = ∑ j = 0 x p ( 1 − p ) j = 1 − ( 1 − p ) p { 1 − ( 1 − p ) x + 1 } = 1 − ( 1 − p ) x + 1 其中 x = 0 , 1 , 2 , . . . x = 0 , 1 , 2 , . . . x = 0 , 1 , 2 , ...
F ( x − 1 ) = 1 − ( 1 − p ) x < R ≤ 1 − ( 1 − p ) x + 1 = F ( x ) (17)
F (x - 1) = 1 - (1 - p) ^ {x} < R \leq 1 - (1 - p) ^ {x + 1} = F (x)\tag{17}
F ( x − 1 ) = 1 − ( 1 − p ) x < R ≤ 1 − ( 1 − p ) x + 1 = F ( x ) ( 17 ) 其中 R 是所生成的随机数,假定 0 < R < 1 0 < R < 1 0 < R < 1
( 1 − p ) x + 1 ≤ 1 − R < ( 1 − p ) x ( x + 1 ) ln ( 1 − p ) ≤ ln ( 1 − R ) < x ln ( 1 − p )
\begin{array}{c} (1 - p) ^ {x + 1} \leq 1 - R < (1 - p) ^ {x} \\ (x + 1) \ln (1 - p) \leq \ln (1 - R) < x \ln (1 - p) \end{array}
( 1 − p ) x + 1 ≤ 1 − R < ( 1 − p ) x ( x + 1 ) ln ( 1 − p ) ≤ ln ( 1 − R ) < x ln ( 1 − p ) 但 1 − p < 1 1 - p < 1 1 − p < 1 ln ( 1 − p ) < 0 \ln \left( 1 - p \right) < 0 ln ( 1 − p ) < 0
ln ( 1 − R ) ln ( 1 − p ) − 1 ≤ x < ln ( 1 − R ) ln ( 1 − p ) (18)
\frac {\ln (1 - R)}{\ln (1 - p)} - 1 \leq x < \frac {\ln (1 - R)}{\ln (1 - p)}\tag{18}
ln ( 1 − p ) ln ( 1 − R ) − 1 ≤ x < ln ( 1 − p ) ln ( 1 − R ) ( 18 ) 于是,对满足不等式 (18) 的那个整数 x,取 X = x X = x X = x ⌈ ⋅ ⌉ \lceil \cdot \rceil ⌈ ⋅ ⌉
X = ⌈ ln ( 1 − R ) ln ( 1 − p ) − 1 ⌉ (19)
X = \left\lceil \frac {\ln (1 - R)}{\ln (1 - p)} - 1 \right\rceil\tag{19}
X = ⌈ ln ( 1 − p ) ln ( 1 − R ) − 1 ⌉ ( 19 ) 由于 p p p β = − 1 / ln ( 1 − p ) \beta = - 1 / \ln ( 1 - p ) β = − 1/ ln ( 1 − p ) β > 0 \beta > 0 β > 0 X = ⌈ − β ln ( 1 − R ) − 1 ⌉ X = \lceil - \beta \ln ( 1 - R ) - 1 \rceil X = ⌈ − β ln ( 1 − R ) − 1 ⌉ ( 1 ) ( 1 ) ( 1 ) − β ln ( 1 − R ) - \beta \ln ( 1 - R ) − β ln ( 1 − R ) β ; \beta ; β ; p p p β − 1 = − ln ( 1 − p ) \beta^{- 1} = - \ln ( 1 - p ) β − 1 = − ln ( 1 − p )
有时人们需要的几何随机变量 X 的可能取值为 { q , q + 1 , q + 2 , … } \{ q , q + 1 , q + 2 , \ldots \} { q , q + 1 , q + 2 , … } p ( x ) = p ( 1 − p ) x − q p ( x ) = p ( 1 - p ) ^ {x - q} p ( x ) = p ( 1 − p ) x − q x = q , q + 1 , … x = q , q + 1 , \ldots x = q , q + 1 , …
X = q + ⌈ ln ( 1 − R ) ln ( 1 − p ) − 1 ⌉ (20)
X = q + \left\lceil \frac {\ln (1 - R)}{\ln (1 - p)} - 1 \right\rceil\tag{20}
X = q + ⌈ ln ( 1 − p ) ln ( 1 − R ) − 1 ⌉ ( 20 ) 最常见的情形之一是 q = 1 q = 1 q = 1
例 7 生成取值范围为 { X ≥ 1 } \{X \ge 1 \} { X ≥ 1 } p ( x ) = p ( 1 − p ) x − 1 p ( x ) = p ( 1 - p ) ^ {x - 1} p ( x ) = p ( 1 − p ) x − 1 x = 1 , 2 , … x = 1 , 2 , \dots x = 1 , 2 , … 1 / p = 2 , 1 / p = 2 , 1/ p = 2 , p = 1 / 2 p = 1 / 2 p = 1/2 q = 1 , p = 1 / 2 q = 1 , p = 1 / 2 q = 1 , p = 1/2 1 / ln ( 1 − p ) = − 1.443 1 / \ln ( 1 - p ) = - 1 . 443 1/ ln ( 1 − p ) = − 1.443 A .1 \mathrm{A} . 1 A .1 R 1 = 0.932 , R 2 = 0.105 , R_{1} = 0 . 932 , R_{2} = 0 . 105 , R 1 = 0.932 , R 2 = 0.105 , R 3 = 0.687 R_{3} = 0 . 687 R 3 = 0.687
X 1 = 1 + ⌈ − 1.443 ln ( 1 − 0.932 ) − 1 ⌉ = 1 + ⌈ 3.878 − 1 ⌉ = 4
X_{1} = 1 + \lceil - 1. 443 \ln (1 - 0. 932) - 1 \rceil = 1 + \lceil 3. 878 - 1 \rceil = 4
X 1 = 1 + ⌈ − 1.443 ln ( 1 − 0.932 ) − 1 ⌉ = 1 + ⌈ 3.878 − 1 ⌉ = 4 X 2 = 1 + ⌈ − 1.443 ln ( 1 − 0.105 ) − 1 ⌉ = 1
X_{2} = 1 + \lceil - 1. 443 \ln (1 - 0. 105) - 1 \rceil = 1
X 2 = 1 + ⌈ − 1.443 ln ( 1 − 0.105 ) − 1 ⌉ = 1 X 3 = 1 + ⌈ − 1.443 ln ( 1 − 0.687 ) − 1 ⌉ = 2
X_{3} = 1 + \lceil - 1. 443 \ln (1 - 0. 687) - 1 \rceil = 2
X 3 = 1 + ⌈ − 1.443 ln ( 1 − 0.687 ) − 1 ⌉ = 2 习题 15 讨论几何分布的一个应用。
2 接受-拒绝法 假设分析人员需要设计一种方法,生成在 1/4 与 1 之间均匀分布的随机变量 X。可以按如下步骤进行:
步骤 1. 生成一个随机数 R。
步骤 2a. 若 R ≥ 1 / 4 R \ge 1 / 4 R ≥ 1/4 X = R X = R X = R
步骤 2b. 若 R < 1 / 4 R < 1 / 4 R < 1/4
步骤 3. 若还需要另一个 [1/4, 1] 上的均匀随机变量,则从步骤 1 开始重复上述过程。否则停止。
每次执行步骤 1,都必须生成一个新的随机数 R。在这一接受-拒绝技术中,步骤 2a 是"接受",步骤 2b 是"拒绝"。概括来说,该技术是:生成具有某种分布(此处为 [0, 1] 上的均匀分布)的随机变量 R,直到某个条件(此处为 R > 1 / 4 R > 1 / 4 R > 1/4 X = R X = R X = R { R ≥ 1 / 4 } \{R \ge 1 / 4\} { R ≥ 1/4 } 1 / 4 ≤ a < b ≤ 1 ; 1 / 4 \leq a < b \leq 1 ; 1/4 ≤ a < b ≤ 1 ;
P ( a < R ≤ b ∣ 1 / 4 ≤ R ≤ 1 ) = P ( a < R ≤ b ) P ( 1 / 4 ≤ R ≤ 1 ) = b − a 3 / 4 (21)
P (a < R \leq b | 1 / 4 \leq R \leq 1) = \frac {P (a < R \leq b)}{P (1 / 4 \leq R \leq 1)} = \frac {b - a}{3 / 4}\tag{21}
P ( a < R ≤ b ∣1/4 ≤ R ≤ 1 ) = P ( 1/4 ≤ R ≤ 1 ) P ( a < R ≤ b ) = 3/4 b − a ( 21 ) 这正是 [1/4, 1] 上均匀分布的正确概率。式 (21) 说明,在 R 位于 1/4 与 1 之间这一条件下(R 的其他取值全部被舍去),R 的概率分布就是所期望的分布。因此,若 1 / 4 ≤ R ≤ 1 1 / 4 \le R \le 1 1/4 ≤ R ≤ 1 X = R X = R X = R
接受-拒绝技术的效率在很大程度上取决于能否把拒绝的次数降到最低。在本例中,拒绝的概率为 P ( R < 1 / 4 ) = 1 / 4 , P ( R < 1 / 4 ) = 1 / 4 , P ( R < 1/4 ) = 1/4 , p = 3 / 4 p = 3 / 4 p = 3/4 ( 1 / p − 1 ) = 4 / 3 − 1 = 1 / 3 ( 1 / p - 1 ) = 4 / 3 - 1 = 1 / 3 ( 1/ p − 1 ) = 4/3 − 1 = 1/3 4 / 3 = 1.33. 4 / 3 = 1 . 33 . 4/3 = 1.33.
在当前这种情形下,生成 [1/4, 1] 上均匀变量的另一种过程是存在的——即式 (5),它化为 X = 1 / 4 + ( 3 / 4 ) R X = 1 / 4 + ( 3 / 4 ) R X = 1/4 + ( 3/4 ) R
对于 [1/4, 1] 上的均匀分布,式 (5) 的逆变换法无疑比接受-拒绝法容易应用得多,效率也高得多。本例的主要目的是解释并阐明接受-拒绝法的基本概念。然而,对于某些重要的分布,如正态分布、伽马分布和贝塔分布,逆 cdf 没有闭式表达式,因而逆变换法难以使用。这些更为高级的技术由 Bratley、Fox 和 Schrage [1996] 以及 Law [2007] 作了总结。
在下面几小节中,将说明如何用接受-拒绝法生成泊松分布、非平稳泊松分布和伽马分布的随机变量。
2.1 泊松分布 一个均值为 α > 0 \alpha > 0 α > 0
p ( n ) = P ( N = n ) = e − α α n n ! , n = 0 , 1 , 2 , …
p (n) = P (N = n) = \frac {e^{- \alpha} \alpha^{n}}{n !}, n = 0, 1, 2, \dots
p ( n ) = P ( N = n ) = n ! e − α α n , n = 0 , 1 , 2 , … 然而更为重要的是,N 可以解释为一个单位时间内泊松到达过程(Poisson arrival process)的到达次数相继到达顾客的到达间隔时间 A 1 , A 2 , … A_{1} , A_{2} , \ldots A 1 , A 2 , …
N = n (22)
N = n\tag{22}
N = n ( 22 ) 当且仅当
A 1 + A 2 + ⋯ + A n ≤ 1 < A 1 + ⋯ + A n + A n + 1 (23)
A_{1} + A_{2} + \dots + A_{n} \leq 1 < A_{1} + \dots + A_{n} + A_{n + 1}\tag{23}
A 1 + A 2 + ⋯ + A n ≤ 1 < A 1 + ⋯ + A n + A n + 1 ( 23 ) 式 (22)(N = n N = n N = n ( n + 1 ) ( n + 1 ) ( n + 1 ) n + 1 n + 1 n + 1 N = n N = n N = n
为了高效生成,不等式 (23) 通常先借助式 (3)(A i = ( − 1 / α ) A_{i} = ( - 1 / \alpha ) A i = ( − 1/ α )
∑ i = 1 n − 1 α ln R i ≤ 1 < ∑ i = 1 n + 1 − 1 α ln R i
\sum_{i = 1} ^ {n} - \frac {1}{\alpha} \ln R_{i} \leq 1 < \sum_{i = 1} ^ {n + 1} - \frac {1}{\alpha} \ln R_{i}
i = 1 ∑ n − α 1 ln R i ≤ 1 < i = 1 ∑ n + 1 − α 1 ln R i 接下来两边同乘 − α - \alpha − α
ln ∏ i = 1 n R i = ∑ i = 1 n ln R i ≥ − α > ∑ i = 1 n + 1 ln R i = ln ∏ i = 1 n + 1 R i
\ln \prod_{i = 1} ^ {n} R_{i} = \sum_{i = 1} ^ {n} \ln R_{i} \geq - \alpha > \sum_{i = 1} ^ {n + 1} \ln R_{i} = \ln \prod_{i = 1} ^ {n + 1} R_{i}
ln i = 1 ∏ n R i = i = 1 ∑ n ln R i ≥ − α > i = 1 ∑ n + 1 ln R i = ln i = 1 ∏ n + 1 R i 最后,对任意数 x 利用关系 e ln x = x e^{\ln x} = x e l n x = x
∏ i = 1 n R i ≥ e − α > ∏ i = 1 n + 1 R i (24)
\prod_{i = 1} ^ {n} R_{i} \geq e^{- \alpha} > \prod_{i = 1} ^ {n + 1} R_{i}\tag{24}
i = 1 ∏ n R i ≥ e − α > i = 1 ∏ n + 1 R i ( 24 ) 它与不等式 (23) 等价。生成泊松随机变量 N 的过程由以下步骤给出:
步骤 1. 置 n = 0 , P = 1 n = 0 , P = 1 n = 0 , P = 1
步骤 2. 生成一个随机数 R n + 1 R_{n + 1} R n + 1 P ⋅ R n + 1 P \cdot R_{n + 1} P ⋅ R n + 1
步骤 3. 若 P < e − α \textit {P} < \textit {e} ^ {- \alpha} P < e − α N = n N = n N = n
注意,步骤 2 完成后,P 等于不等式 (24) 中最右端的表达式。拒绝技术的基本思想在这里再次得到体现:若在步骤 3 中 P ≥ e − α P \ge e^{- \alpha} P ≥ e − α
平均而言,生成一个泊松随机变量 N 需要多少个随机数呢?若 N = n N = n N = n n + 1 n + 1 n + 1
E ( N + 1 ) = α + 1
E (N + 1) = \alpha + 1
E ( N + 1 ) = α + 1 若泊松分布的均值 α 很大,这个数就相当大。
例 8 生成三个均值为 α = 0.2 \alpha = 0 . 2 α = 0.2 e − α = e − 0.2 = 0.8187 e^{- \alpha} = e^{- 0 . 2} = 0 . 8187 e − α = e − 0.2 = 0.8187
步骤 1. 置 n = 0 , P = 1 n = 0 , P = 1 n = 0 , P = 1 R 1 = 0.4357 , P = 1 ⋅ R 1 = 0.4357 R_{1} = 0 . 4357 , P = 1 \cdot R_{1} = 0 . 4357 R 1 = 0.4357 , P = 1 ⋅ R 1 = 0.4357 P = 0.4357 < e − α = 0.8187 P = 0 . 4357 < e^{- \alpha} = 0 . 8187 P = 0.4357 < e − α = 0.8187 N = 0 N = 0 N = 0
步骤 1–3.(R 1 = 0.4146 R_{1} = 0 . 4146 R 1 = 0.4146 N = 0 N = 0 N = 0 n = 0 , P = 1 n = 0 , P = 1 n = 0 , P = 1 R 1 = 0.8353 , P = 1 ⋅ R 1 = 0.8353. R_{1} = 0 . 8353 , P = 1 \cdot R_{1} = 0 . 8353 . R 1 = 0.8353 , P = 1 ⋅ R 1 = 0.8353. P ≥ e − α P \ge e^{- \alpha} P ≥ e − α n = 0 n = 0 n = 0 n = 1 n = 1 n = 1
步骤 2. R 2 = 0.9952 , P = R 1 R 2 = 0.8313. R_{2} = 0 . 9952 , P = R_{1} R_{2} = 0 . 8313 . R 2 = 0.9952 , P = R 1 R 2 = 0.8313. P ≥ e − α P \ge e^{- \alpha} P ≥ e − α n = 1 n = 1 n = 1 n = 2 n = 2 n = 2
步骤 2. R 3 = 0.8004 , P = R 1 R 2 R 3 = 0.6654. R_{3} = 0 . 8004 , P = R_{1} R_{2} R_{3} = 0 . 6654 . R 3 = 0.8004 , P = R 1 R 2 R 3 = 0.6654. P < e − α P < e^{- \alpha} P < e − α N = 2 N = 2 N = 2
生成这三个泊松随机变量所需的计算汇总如下:
这里生成三个泊松随机变量(N = 0 , N = 0 , N = 0 , N = 0 , N = 0 , N = 0 , N = 2 N = 2 N = 2 α = 0.2 \alpha = 0 . 2 α = 0.2 1000 ( α + 1 ) 1000 ( \alpha + 1 ) 1000 ( α + 1 )
例 9 在 Peachtree 与 North Avenue 交叉口的公交站,公交车按泊松过程到达,平均每 15 分钟一辆。生成一个随机变量 N,表示某个 1 小时时段内到达的公交车数。现在,N 服从均值为每小时四辆车的泊松分布。首先计算 e − α = e − 4 = 0.0183 e^{- \alpha} = e^{- 4} = 0 . 0183 e − α = e − 4 = 0.0183
可以立即看出,α 的取值越大(此处 α = 4 \alpha = 4 α = 4 1000 ( α + 1 ) = 5000 1000 ( \alpha + 1 ) = 5000 1000 ( α + 1 ) = 5000
当 α 较大时(比如 α ≥ 15 \alpha \geq 15 α ≥ 15
Z = N − α α
Z = \frac {N - \alpha}{\sqrt {\alpha}}
Z = α N − α 近似服从均值为零、方差为 1 的正态分布;这一观察提示我们采用一种近似技术。首先按第 3.1 节的式 (28) 生成一个标准正态随机变量 Z,然后按下式生成所求的泊松随机变量 N:
N = ⌈ α + α Z − 0.5 ⌉ (25)
N = \lceil \alpha + \sqrt {\alpha} Z - 0. 5 \rceil\tag{25}
N = ⌈ α + α Z − 0.5 ⌉ ( 25 ) 其中 ⌈ ⋅ ⌉ \lceil \cdot \rceil ⌈ ⋅ ⌉ α + α Z − 0.5 < 0 \alpha + {\sqrt {\alpha}} Z - 0 . 5 < 0 α + α Z − 0.5 < 0 N = 0 N = 0 N = 0 " 0.5 ′ " 0 . 5 ' "0. 5 ′
2.2 非平稳泊松过程 另一类接受-拒绝方法(称为抽稀法,thinning)可用于生成非平稳泊松过程(nonstationary Poisson process, NSPP)的到达间隔时间,该过程的到达率为 λ ( t ) , 0 ≤ t ≤ T \lambda ( t ) , 0 \leq t \leq T λ ( t ) , 0 ≤ t ≤ T
例如,考虑表 7 给出的、每小时发生变化的到达率函数。抽稀法的思路是:以最快的速率(在本例中为每分钟 1/5 位顾客)生成一个平稳泊松到达过程,但只"接受"或保留其中一部分到达,抽稀的幅度恰好足以得到所期望的时变速率。下面给出通用算法,它生成 T i \mathcal {T} _ {i} T i
步骤 1. 令
λ ∗ = max 0 ≤ t ≤ T λ ( t )
\lambda^{*} = \operatorname* {m a x} _ {0 \leq t \leq T} \lambda ( t )
λ ∗ = 0 ≤ t ≤ T max λ ( t ) 为到达率函数的最大值,并置 t = 0 t = 0 t = 0 i = 1 i = 1 i = 1
步骤 2. 从速率为 λ ∗ \lambda^{*} λ ∗ t = t + E t = t + E t = t + E
步骤 3. 从 U ( 0 , 1 ) U ( 0 , 1 ) U ( 0 , 1 ) R ≤ λ ( t ) / λ ∗ R \leq \lambda ( t ) / \lambda^{*} R ≤ λ ( t ) / λ ∗ T i = t \mathcal {T} _ {i} = t T i = t i = i + 1. i = i + 1 . i = i + 1.
若典型到达率与最大到达率之间的差异很大,抽稀算法可能效率不高。不过,抽稀法的优点在于它适用于任何可积的到达率函数,而不只是像本例这样分段为常数的函数。
表 7 NSPP 示例的到达率
例 10 对于表 7 中的到达率函数,生成前两个到达时刻。
步骤 1. λ ∗ = max 0 ≤ t ≤ T λ ( t ) = 1 / 5 , t = 0 \lambda^{*} = \operatorname* {m a x} _ {0 \leq t \leq T} \lambda ( t ) = 1 / 5 , t = 0 λ ∗ = max 0 ≤ t ≤ T λ ( t ) = 1/5 , t = 0 i = 1 i = 1 i = 1 R = 0.2130 R = 0 . 2130 R = 0.2130 E = − 5 ln ( 0.213 ) = 13.13 E = - 5 \ln ( 0 . 213 ) = 13 . 13 E = − 5 ln ( 0.213 ) = 13.13 t = 0 + 13.13 = 13.13 t = 0 + 13 . 13 = 13 . 13 t = 0 + 13.13 = 13.13
步骤 3. 生成 R = 0.8830 R = 0 . 8830 R = 0.8830 R = 0.8830 ≰ λ ( 13.13 ) / λ ∗ = ( 1 / 15 ) / ( 1 / 5 ) = 1 / 3 R = 0 . 8830 \not\leq \lambda ( 13 . 13 ) / \lambda^{*} = ( 1 / 15 ) / ( 1 / 5 ) = 1 / 3 R = 0.8830 ≤ λ ( 13.13 ) / λ ∗ = ( 1/15 ) / ( 1/5 ) = 1/3
步骤 4. 转到步骤 2。
步骤 2. 对随机数 R = 0.5530 R = 0 . 5530 R = 0.5530 E = − 5 ln ( 0.553 ) = 2.96 E = - 5 \ln ( 0 . 553 ) = 2 . 96 E = − 5 ln ( 0.553 ) = 2.96 t = 13.13 + 2.96 = 16.09 t = 13 . 13 + 2 . 96 = 16 . 09 t = 13.13 + 2.96 = 16.09 R = 0.0240 R = 0 . 0240 R = 0.0240 R = 0.0240 ≤ λ ( 16.09 ) / λ ∗ = ( 1 / 15 ) / ( 1 / 5 ) = 1 / 3 R = 0 . 0240 \leq \lambda ( 16 . 09 ) / \lambda^{*} = ( 1 / 15 ) / ( 1 / 5 ) = 1 / 3 R = 0.0240 ≤ λ ( 16.09 ) / λ ∗ = ( 1/15 ) / ( 1/5 ) = 1/3 T 1 = t = 16.09 T_{1} = t = 16 . 09 T 1 = t = 16.09 i = i + 1 = 2 i = i + 1 = 2 i = i + 1 = 2
步骤 4. 转到步骤 2。
步骤 2. 对随机数 R = 0.0001 R = 0 . 0001 R = 0.0001 E = − 5 ln ( 0.0001 ) = 46.05 E = - 5 \ln ( 0 . 0001 ) = 46 . 05 E = − 5 ln ( 0.0001 ) = 46.05 t = 16.09 + 46.05 = 62.14 t = 16 . 09 + 46 . 05 = 62 . 14 t = 16.09 + 46.05 = 62.14
步骤 3. 生成 R = 0.1443 R = 0 . 1443 R = 0.1443 R = 0.1443 ≤ λ ( 62.14 ) / λ ∗ = ( 1 / 12 ) / ( 1 / 5 ) = 5 / 12 R = 0 . 1443 \leq \lambda ( 62 . 14 ) / \lambda^{*} = ( 1 / 12 ) / ( 1 / 5 ) = 5 / 12 R = 0.1443 ≤ λ ( 62.14 ) / λ ∗ = ( 1/12 ) / ( 1/5 ) = 5/12 T 2 = t = 62.14 T_{2} = t = 62 . 14 T 2 = t = 62.14 i = i + 1 = 3 i = i + 1 = 3 i = i + 1 = 3
步骤 4. 转到步骤 2。
2.3 伽马分布 人们已经开发出若干用于生成伽马随机变量的接受-拒绝技术。(参见 Bratley、Fox 和 Schrage [1996] 以及 Law [2007]。)其中较为高效的一种由 Cheng [1977] 提出;对形状参数 β 的任意取值 β ≥ 1 \beta \geq 1 β ≥ 1 β = k , \beta = k , β = k , β = k \beta = k β = k 1 / θ 1 / \theta 1/ θ 1 / β θ 2 1 / \beta \theta^{2} 1/ β θ 2
步骤 1. 计算 a = 1 / ( 2 β − 1 ) 1 / 2 , b = β − ln 4 a = 1 / ( 2 \beta - 1 ) ^ {1 / 2} , b = \beta - \ln 4 a = 1/ ( 2 β − 1 ) 1/2 , b = β − ln 4
步骤 2. 生成 R 1 R_{1} R 1 R 2 R_{2} R 2 V = R 1 / ( 1 − R 1 ) V = R_{1} / ( 1 - R_{1} ) V = R 1 / ( 1 − R 1 )
步骤 3. 计算 X = β V a X = \beta V^{a} X = β V a
步骤 4a. 若
X > b + ( β a + 1 ) ln ( V ) − ln ( R 1 2 R 2 )
X > b + ( \beta a + 1 ) \ln ( V ) - \ln ( R_{1} ^ {2} R_{2} )
X > b + ( β a + 1 ) ln ( V ) − ln ( R 1 2 R 2 ) 则拒绝 X 并返回步骤 2。
步骤 4b. 若
X ≤ b + ( β a + 1 ) ln ( V ) − ln ( R 1 2 R 2 )
X \le b + ( \beta a + 1 ) \ln ( V ) - \ln ( R_{1} ^ {2} R_{2} )
X ≤ b + ( β a + 1 ) ln ( V ) − ln ( R 1 2 R 2 ) 则把 X 作为所求的随机变量。
步骤 4b 所生成的随机变量,其均值与方差都等于 β . \beta . β . 1 / θ 1 / \theta 1/ θ 1 / β θ 2 1 / \beta \theta^{2} 1/ β θ 2
(步骤 5. 把 X 替换为 X / ( β θ ) . X / ( \beta \theta ) . X / ( β θ ) .
所有接受-拒绝方法的基本思想在这里再次得到说明,但本例的证明超出了本书的范围。在步骤 3 中,X = β V a = β [ R 1 / ( 1 − R 1 ) ] a X = \beta V^{a} = \beta [ R_{1} / ( 1 - R_{1} ) ] ^ {a} X = β V a = β [ R 1 / ( 1 − R 1 ) ] a
例 11 已发现某高产量糖果制造机的停机时间服从伽马分布,均值为 2.2 分钟,方差为 2.10 分钟^2。因此,1 / θ = 2.2 1 / \theta = 2 . 2 1/ θ = 2.2 1 / β θ 2 = 2.10 1 / \beta \theta^{2} = 2 . 10 1/ β θ 2 = 2.10 β = 2.30 \beta = 2 . 30 β = 2.30 θ = 0.4545 \theta = 0 . 4545 θ = 0.4545
步骤 1. a = 0.53 , b = 0.91 a = 0 . 53 , b = 0 . 91 a = 0.53 , b = 0.91
步骤 2. 生成 R 1 = 0.832 , R 2 = 0.021 R_{1} = 0 . 832 , R_{2} = 0 . 021 R 1 = 0.832 , R 2 = 0.021 V = 0.832 / ( 1 − 0.832 ) = 4.952 V = 0 . 832 / ( 1 - 0 . 832 ) = 4 . 952 V = 0.832/ ( 1 − 0.832 ) = 4.952
步骤 3. 计算 X = 2.3 ( 4.952 ) 0.53 = 5.37 X = 2 . 3 ( 4 . 952 ) ^ {0 . 53} = 5 . 37 X = 2.3 ( 4.952 ) 0.53 = 5.37
步骤 4. X = 5.37 > 0.91 + [ 2.3 ( 0.53 ) + 1 ] ln ( 4.952 ) − ln [ ( 0.832 ) 2 ( 0.021 ) ] = 8.68 X = 5 . 37 > 0 . 91 + [ 2 . 3 ( 0 . 53 ) + 1 ] \ln ( 4 . 952 ) - \ln [ ( 0 . 832 ) ^ {2} ( 0 . 021 ) ] = 8 . 68 X = 5.37 > 0.91 + [ 2.3 ( 0.53 ) + 1 ] ln ( 4.952 ) − ln [( 0.832 ) 2 ( 0.021 )] = 8.68
步骤 2. 生成 R 1 = 0.434 , R 2 = 0.716 R_{1} = 0 . 434 , R_{2} = 0 . 716 R 1 = 0.434 , R 2 = 0.716 V = 0.434 / ( 1 − 0.434 ) = 0.767 V = 0 . 434 / ( 1 - 0 . 434 ) = 0 . 767 V = 0.434/ ( 1 − 0.434 ) = 0.767 X = 2.3 ( 0.767 ) 0.53 = 2.00 X = 2 . 3 ( 0 . 767 ) ^ {0 . 53} = 2 . 00 X = 2.3 ( 0.767 ) 0.53 = 2.00
步骤 4. 由于 X = 2.00 ≤ 0.91 + [ 2.3 ( 0.53 ) + 1 ] ln ( 0.767 ) − ln [ ( 0.434 ) 2 ( 0.716 ) ] = 2.32 X = 2 . 00 \leq 0 . 91 + [ 2 . 3 ( 0 . 53 ) + 1 ] \ln ( 0 . 767 ) - \ln [ ( 0 . 434 ) ^ {2} ( 0 . 716 ) ] = 2 . 32 X = 2.00 ≤ 0.91 + [ 2.3 ( 0.53 ) + 1 ] ln ( 0.767 ) − ln [( 0.434 ) 2 ( 0.716 )] = 2.32
步骤 5. 用 β θ = 1.045 \beta \theta = 1 . 045 β θ = 1.045 X = 1.91 X = 1 . 91 X = 1.91
本例用了两次试探(即一次拒绝)才生成一个可接受的服从伽马分布的随机变量;但平均而言,若要生成比如 1000 个伽马随机变量,该方法将需要 1130 到 1470 次试探,或者等价地需要 2260 到 2940 个随机数。该方法用于手工计算稍嫌繁琐,但在计算机上编程很容易,并且是已知的最有效的伽马发生器之一。
3 特殊性质 “特殊性质"正如其名称所暗示的那样:它们是一些基于概率分布特定族之特征的随机变量生成技术,而不是像逆变换法或接受-拒绝法那样的通用技术。
3.1 正态分布与对数正态分布的直接变换 人们已经开发出多种生成正态分布随机变量的方法。然而,逆变换法难以应用,因为逆 cdf 无法写成闭式形式。标准正态 cdf 为
Φ ( x ) = ∫ − ∞ x 1 2 π e − t 2 / 2 d t , − ∞ < x < ∞
\Phi (x) = \int_{- \infty} ^ {x} \frac {1}{\sqrt {2 \pi}} e ^ {- t^{2} / 2} d t, - \infty < x < \infty
Φ ( x ) = ∫ − ∞ x 2 π 1 e − t 2 /2 d t , − ∞ < x < ∞ 本节描述一种直观而吸引人的直接变换,它产生一对相互独立的、均值为零方差为 1 的标准正态随机变量。该方法由 Box 与 Muller [1958] 提出。尽管它不如许多更现代的技术高效,但用科学计算语言(如 FORTRAN、C、C++、Visual Basic 或 Java)编写程序十分容易。随后我们说明如何把一个标准正态随机变量变换为均值为 μ \mu μ σ 2 \sigma^{2} σ 2 N ( μ , σ 2 ) N ( \mu , \sigma^{2} ) N ( μ , σ 2 ) X X X Y = e X Y = e^{X} Y = e X μ \mu μ σ 2 \sigma^{2} σ 2 μ \mu μ σ 2 \sigma^{2} σ 2
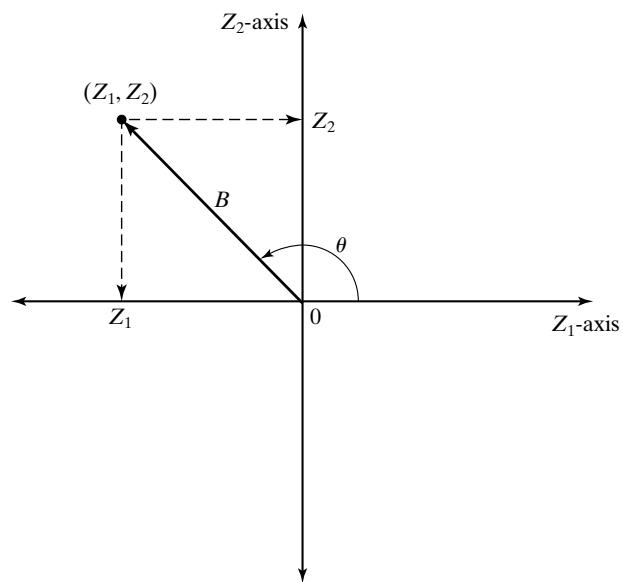
考虑两个标准正态随机变量 Z 1 Z_{1} Z 1 Z 2 Z_{2} Z 2
Z 1 = B cos θ Z 2 = B sin θ (26)
\begin{array}{l} {Z_{1} = B \cos \theta} \\ {Z_{2} = B \sin \theta} \end{array}\tag{26}
Z 1 = B cos θ Z 2 = B sin θ ( 26 ) 图 7 一对标准正态变量的极坐标表示。
已知 B 2 = Z 1 2 + Z 2 2 B^{2} = Z_{1} ^ {2} + Z_{2} ^ {2} B 2 = Z 1 2 + Z 2 2
B = ( − 2 ln R ) 1 / 2 (27)
B = (- 2 \ln R) ^ {1 / 2}\tag{27}
B = ( − 2 ln R ) 1/2 ( 27 ) 由正态分布的对称性,可以合理地推测(事实也确实如此)角度在 0 到 2π 弧度之间均匀分布。此外,半径 B 与角度 θ \theta θ R 1 R_{1} R 1 R 2 R_{2} R 2 Z 1 Z_{1} Z 1 Z 2 . Z_{2} . Z 2 .
Z 1 = ( − 2 ln R 1 ) 1 / 2 cos ( 2 π R 2 ) Z 2 = ( − 2 ln R 1 ) 1 / 2 sin ( 2 π R 2 ) (28)
\begin{array}{r l} {Z_{1} =} & {(- 2 \ln R_{1}) ^ {1 / 2} \cos (2 \pi R_{2})} \\ {Z_{2} =} & {(- 2 \ln R_{1}) ^ {1 / 2} \sin (2 \pi R_{2})} \end{array}\tag{28}
Z 1 = Z 2 = ( − 2 ln R 1 ) 1/2 cos ( 2 π R 2 ) ( − 2 ln R 1 ) 1/2 sin ( 2 π R 2 ) ( 28 ) 为说明这一生成方案,考虑式 (28) 中 R 1 = 0.1758 R_{1} = 0 . 1758 R 1 = 0.1758 R 2 = 0.1489 R_{2} = 0 . 1489 R 2 = 0.1489
Z 1 = [ − 2 ln ( 0.1758 ) ] 1 / 2 cos ( 2 π 0.1489 ) = 1.11 Z 2 = [ − 2 ln ( 0.1758 ) ] 1 / 2 sin ( 2 π 0.1489 ) = 1.50
\begin{array}{l} Z_{1} = [ - 2 \ln (0. 1758) ] ^ {1 / 2} \cos (2 \pi 0. 1489) = 1. 11 \\ Z_{2} = [ - 2 \ln (0. 1758) ] ^ {1 / 2} \sin (2 \pi 0. 1489) = 1. 50 \end{array}
Z 1 = [ − 2 ln ( 0.1758 ) ] 1/2 cos ( 2 π 0.1489 ) = 1.11 Z 2 = [ − 2 ln ( 0.1758 ) ] 1/2 sin ( 2 π 0.1489 ) = 1.50 为得到均值为 μ \mu μ σ 2 \sigma^{2} σ 2 X i X_i X i
X i = μ + σ Z i (29)
X_{i} = \mu + \sigma Z_{i}\tag{29}
X i = μ + σ Z i ( 29 ) 例如,要把这两个标准正态随机变量变换为均值为 μ = 10 \mu = 10 μ = 10 σ 2 = 4 \sigma^{2} = 4 σ 2 = 4
X 1 = 10 + 2 ( 1.11 ) = 12.22 X 2 = 10 + 2 ( 1.50 ) = 13.00
\begin{array}{l} X_{1} = 10 + 2 (1. 11) = 12. 22 \\ X_{2} = 10 + 2 (1. 50) = 13. 00 \end{array}
X 1 = 10 + 2 ( 1.11 ) = 12.22 X 2 = 10 + 2 ( 1.50 ) = 13.00 请记住,要由正态随机变量 X 得到对数正态随机变量 Y,置 Y = e X Y = e^{X} Y = e X
3.2 卷积法 两个或多个相互独立随机变量之和的概率分布,称为原有各变量分布的卷积(convolution)。因此,卷积法是指把两个或多个随机变量相加,以得到具有所期望分布的新随机变量。这一技术可用于获得厄兰随机变量和二项随机变量。重要的并不是所求随机变量的 cdf,而是它与那些更易生成的随机变量之间的关系。
例 12:厄兰分布 具有参数 ( k , θ ) ( k , \theta ) ( k , θ ) X i , i = 1 , 2 , … , k , X_{i} , i = 1 , 2 , \ldots , k , X i , i = 1 , 2 , … , k , 1 / k θ ⋅ 1 / k \theta \cdot 1/ k θ ⋅
X = ∑ i = 1 k X i
X = \sum_{i = 1} ^ {k} X_{i}
X = i = 1 ∑ k X i 卷积方法的思路是生成 X 1 , X 2 , … , X k X_{1} , X_{2} , \ldots , X_{k} X 1 , X 2 , … , X k X i X_i X i 1 / λ = 1 / k θ 1 / \lambda = 1 / k \theta 1/ λ = 1/ k θ
X = ∑ i = 1 k − 1 k θ ln R i
X = \sum_{i = 1} ^ {k} - \frac {1}{k \theta} \ln R_{i}
X = i = 1 ∑ k − k θ 1 ln R i = − 1 k θ ln ( ∏ i = 1 k R i ) (30)
= - \frac {1}{k \theta} \ln \left(\prod_{i = 1} ^ {k} R_{i}\right)\tag{30}
= − k θ 1 ln ( i = 1 ∏ k R i ) ( 30 ) 从计算效率看,先把所有随机数相乘、然后只算一次对数,会更加高效。
例 13 卡车以完全随机的方式到达一座大型仓库,这可用到达率为 λ = 10 \lambda = 10 λ = 10 k = 2 k = 2 k = 2 1 / θ = 2 / λ = 0.2 1 / \theta = 2 / \lambda = 0 . 2 1/ θ = 2/ λ = 0.2 X , X , X , k = 2 k = 2 k = 2 R 1 = 0.937 R_{1} = 0 . 937 R 1 = 0.937 R 2 = 0.217 R_{2} = 0 . 217 R 2 = 0.217
X = − 0.1 ln [ ( 0.937 ) ( 0.217 ) ] = 0.159 hour = 9.56 minutes
\begin{array}{r l} X & = - 0. 1 \ln [ (0. 937) (0. 217) ] \\ & = 0. 159 \text{hour} = 9. 56 \text{minutes} \end{array}
X = − 0.1 ln [( 0.937 ) ( 0.217 )] = 0.159 hour = 9.56 minutes 一般而言,式 (30) 意味着每生成一个厄兰随机变量都需要 k 个均匀随机数。若 k 较大,用其他技术生成厄兰随机变量会更高效,例如第 2.3 节给出的许多伽马分布接受-拒绝技术之一,或者 Bratley、Fox 和 Schrage [1996] 以及 Law [2007] 所述的技术。
3.3 更多特殊性质 概率分布之间存在许多关系,可以被利用来生成随机变量。第 3.2 节的卷积法就是其中一个例子。另一个特别有用的例子是贝塔分布与伽马分布之间的关系。
假定 X 1 X_{1} X 1 β 1 \beta_{1} β 1 θ 1 = 1 / β 1 \theta_{1} = 1 / \beta_{1} θ 1 = 1/ β 1 X 2 X_{2} X 2 β 2 \beta_{2} β 2 θ 2 = 1 / β 2 \theta_{2} = 1 / \beta_{2} θ 2 = 1/ β 2
Y = X 1 X 1 + X 2
Y = \frac {X_{1}}{X_{1} + X_{2}}
Y = X 1 + X 2 X 1 在区间 [0, 1] 上服从参数为 β 1 \beta_{1} β 1 β 2 \beta_{2} β 2 Y Y Y [ a , b ] [ a , b ] [ a , b ]
Y = a + ( b − a ) ( X 1 X 1 + X 2 )
Y = a + (b - a) \left(\frac {X_{1}}{X_{1} + X_{2}}\right)
Y = a + ( b − a ) ( X 1 + X 2 X 1 ) 于是,利用上一节定义的伽马随机变量接受-拒绝技术,我们就可以生成贝塔随机变量,每生成一个贝塔随机变量需要两个伽马随机变量。
虽然这种生成贝塔随机变量的方法很方便,但还有基于接受-拒绝思想的更快方法。例如可参见 Devroye [1986] 或 Dagpunar [1988]。
4 小结 本章通过实例介绍并说明了用逆变换法、接受-拒绝法以及特殊性质进行随机变量生成的基本原理。给出了生成许多重要连续分布和离散分布以及全部经验分布的方法。极佳的综述参见 Schmeiser [1980];更深入的处理请读者参阅 Devroye [1986] 或 Dagpunar [1988]。
参考文献 BRATLEY, P., B. L. FOX, AND L. E. SCHRAGE [1996], A Guide to Simulation, 2d ed., Springer-Verlag, New York.
BOX, G. E. P., AND M. F. MULLER [1958], “A Note on the Generation of Random Normal Deviates,” Annals of Mathematical Statistics , Vol. 29, pp. 610–611.
CHENG, R. C. H. [1977], “The Generation of Gamma Variables with Nonintegral Shape Parameter,” Applied Statistics , Vol. 26, No. 1, pp. 71–75.
DAGPUNAR, J. [1988], Principles of Random Variate Generation , Clarendon Press, Oxford.
DEVROYE, L. [1986], Non-Uniform Random Variate Generation , Springer-Verlag, New York.
LAW, A. M. [2007], Simulation Modeling and Analysis , 4th ed., McGraw-Hill, New York.
RIPLEY, B. D. [1987], Stochastic Simulation , Wiley, New York.
SCHMEISER, B. W. [1979], “Approximations to the Inverse Cumulative Normal Function for Use on Hand Calculators,” Applied Statistics , Vol. 28, pp. 175–176.
SCHMEISER, B. W. [1980], “Random Variate Generation: A Survey,” in Simulation with Discrete Models: A State of the Art View , T. I. Oren, C. M. Shub, and P. F. Roth, eds., IEEE, NY, pp. 79–104.
习题 本节许多习题要求读者为给定分布开发一个生成方案并生成取值。结果应当用某种编程语言或电子表格来实现,以便能够生成大量的随机变量。
为随机变量 X 开发一个随机变量生成器,其 pdf 为 f ( x ) = { e 2 x , − ∞ < x ≤ 0 e − 2 x , 0 < x < ∞
f (x) = \left\{\begin{array}{l l} e^{2 x}, & - \infty < x \leq 0 \\ e^{- 2 x}, & 0 < x < \infty \end{array} \right.
f ( x ) = { e 2 x , e − 2 x , − ∞ < x ≤ 0 0 < x < ∞ 为具有下列 pdf 的三角分布开发一个生成方案: f ( x ) = { 1 2 ( x − 2 ) , 2 ≤ x ≤ 3 1 2 ( 2 − x 3 ) , 3 < x ≤ 6 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {1}{2} (x - 2), & 2 \leq x \leq 3 \\ \frac {1}{2} \left(2 - \frac {x}{3}\right), & 3 < x \leq 6 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = ⎩ ⎨ ⎧ 2 1 ( x − 2 ) , 2 1 ( 2 − 3 x ) , 0 , 2 ≤ x ≤ 3 3 < x ≤ 6 otherwise 生成 1000 个随机变量的取值,计算样本均值,并与该分布的真实均值作比较。
为取值范围为 (1, 10)、众数在 x = 4 x = 4 x = 4
为取值范围为 (1, 10)、均值为 4 的三角分布开发一个生成器。生成 1000 个随机变量的取值,计算样本均值,并与该分布的真实均值作比较。
给定一个取值范围为 −3 到 4 的连续变量,其 cdf 如下:
F ( x ) = { 0 , x ≤ − 3 1 2 + x 6 , − 3 < x ≤ 0 1 2 + x 2 32 , 0 < x ≤ 4 1 , x > 4
F (x) = \left\{\begin{array}{l l} 0, & x \leq - 3 \\ \frac {1}{2} + \frac {x}{6}, & - 3 < x \leq 0 \\ \frac {1}{2} + \frac {x^{2}}{32}, & 0 < x \leq 4 \\ 1, & x > 4 \end{array} \right.
F ( x ) = ⎩ ⎨ ⎧ 0 , 2 1 + 6 x , 2 1 + 32 x 2 , 1 , x ≤ − 3 − 3 < x ≤ 0 0 < x ≤ 4 x > 4 开发该变量的生成器,生成 1000 个取值,并作直方图。
给定 cdf F ( x ) = x 4 / 16 F ( x ) = x^{4} / 16 F ( x ) = x 4 /16 0 ≤ x ≤ 2 0 \leq x \leq 2 0 ≤ x ≤ 2
给定 pdf f ( x ) = x 2 / 9 f ( x ) = x^{2} / 9 f ( x ) = x 2 /9 0 ≤ x ≤ 3 0 \leq x \leq 3 0 ≤ x ≤ 3
为 pdf 为下列形式的随机变量开发一个生成器:
f ( x ) = { 1 3 , 0 ≤ x ≤ 2 1 24 , 2 < x ≤ 10 0 , otherwise
f (x) = \left\{\begin{array}{l l} \frac {1}{3}, & 0 \leq x \leq 2 \\ \frac {1}{24}, & 2 < x \leq 10 \\ 0, & \text{otherwise} \end{array} \right.
f ( x ) = ⎩ ⎨ ⎧ 3 1 , 24 1 , 0 , 0 ≤ x ≤ 2 2 < x ≤ 10 otherwise 生成 1000 个取值并作直方图。
离散随机变量 X 的 cdf 为 F ( x ) = x ( x + 1 ) ( 2 x + 1 ) n ( n + 1 ) ( 2 n + 1 ) , x = 1 , 2 , … , n
F (x) = \frac {x (x + 1) (2 x + 1)}{n (n + 1) (2 n + 1)}, x = 1, 2, \dots , n
F ( x ) = n ( n + 1 ) ( 2 n + 1 ) x ( x + 1 ) ( 2 x + 1 ) , x = 1 , 2 , … , n 当 n = 4 n = 4 n = 4 R 1 = 0.83 , R 2 = 0.24. R_{1} = 0 . 83 , R_{2} = 0 . 24 . R 1 = 0.83 , R 2 = 0.24. R 3 = 0.57 R_{3} = 0 . 57 R 3 = 0.57
某自动化生产过程的失效时间被发现服从参数为 β = 2 \beta = 2 β = 2 α = 10 \alpha = 10 α = 10
已收集到 Shady Lane National Bank 某个免下车银行窗口的服务时间数据。这些数据汇总为如下区间:
建立一张类似于表 3 的表,用查表法生成服务时间,并使用取自表 A.1 的四位随机数生成五个服务时间取值。
在例 2 中,假定消防队响应时间满足 0.25 ≤ x ≤ 3 0 . 25 \leq x \leq 3 0.25 ≤ x ≤ 3
在仿真模型的一个初步版本中,假定装上一辆卡车的托盘数 X 在 8 与 24 之间均匀分布。假定相继各卡车所载货物相互独立,设计一个生成 X 的方法。请使用例 5 中离散均匀分布的技术。最后用取自表 A.1 的四位随机数,生成相继 10 辆卡车所载的货物。
开发一个从参数为 p 和 k 的负二项分布生成取值的方法。当 p = 0.8 p = 0 . 8 p = 0.8 k = 2 k = 2 k = 2
某种滞销商品的周需求 X 被发现可以很好地用取值范围为 { 0 , 1 , 2 , … } \{0 , 1 , 2 , \ldots \} { 0 , 1 , 2 , … } { q , q + 1 , … } \{q , q + 1 , \ldots \} { q , q + 1 , … } 1 / p + q − 1 1 / p + q - 1 1/ p + q − 1
在习题 15 中,假定需求被发现服从均值为每周 2.5 件的泊松分布。使用表 A.1 中的随机数生成 10 个每周需求 X 的取值。讨论几何分布与泊松分布之间的差别。
提前期被发现服从均值为 3.7 天的指数分布。从该分布生成五个随机提前期。
某生产流程的定期维护被发现存在波动,已建模为均值 33 分钟、方差 4 分钟^2 的正态随机变量。从给定分布生成五个随机维护时间。
一台机器或者发生故障,或者在 5 小时之后,二者以先到者为准而退出生产。通过运行同类机器直至发生故障,发现失效时间 X 服从 Weibull 分布,其中 α = 8 , β = 0.75 \alpha = 8 , \beta = 0 . 75 α = 8 , β = 0.75 ν = 0 \nu = 0 ν = 0 Y = min ( X , 5 ) Y = \operatorname* {m i n} ( X , 5 ) Y = min ( X , 5 )
某个部件退出服役之前的时间在 0 到 8 小时之间均匀分布。两个这样的相互独立的部件串联,只要其中一个故障,整个系统就停止。若 X i ( i = 1 , 2 ) X_{i} ~ ( i = 1 , 2 ) X i ( i = 1 , 2 ) Y = min ( X 1 , X 2 ) Y = \operatorname* {m i n} ( X_{1} , X_{2} ) Y = min ( X 1 , X 2 ) F Y ( y ) = P ( Y ≤ y ) = 1 − P ( Y > y ) F_{Y} ( y ) = P ( Y \leq y ) = 1 - P ( Y > y ) F Y ( y ) = P ( Y ≤ y ) = 1 − P ( Y > y ) 0 ≤ y ≤ 8 0 \leq y \leq 8 0 ≤ y ≤ 8 { Y > y } = { X 1 > y \{Y > y \} = \{X_{1} > y { Y > y } = { X 1 > y X 2 > y } X_{2} ~ > ~ y \} X 2 > y } X 1 X_{1} X 1 X 2 X_{2} X 2 F Y ( y ) F_{Y} ( y ) F Y ( y )
在习题 20 中,假定部件寿命服从指数分布,一个均值为 2 小时,另一个均值为 6 小时。在这一新假定下重做习题 20。讨论所设计的两种生成方案的相对效率。
开发一种用卷积技术生成二项随机变量 X 的方法。[提示:X 可以表示为 n 次相互独立的伯努利试探中的成功次数,每次成功的概率为 p。因此,X = ∑ i = 1 n X i X = \sum_{i = 1} ^ {n} X_{i} X = ∑ i = 1 n X i P ( X i = 1 ) = p P ( X_{i} = 1 ) = p P ( X i = 1 ) = p P ( X i = 0 ) = 1 − p P ( X_{i} = 0 ) = 1 - p P ( X i = 0 ) = 1 − p
开发一种接受-拒绝技术,用于生成取值范围为 { 0 , 1 , 2 , … } \{0 , 1 , 2 , \ldots \} { 0 , 1 , 2 , … }
编写一个计算机例程,用本章讨论的精确方法生成标准正态随机变量。用它生成 10,000 个取值。把取值落在 ( − ∞ , z ) ( - \infty , z ) ( − ∞ , z ) Φ ( z ) . \Phi ( z ) . Φ ( z ) . ≤ z \leq z ≤ z z = − 4 , − 3 , − 2 , − 1 , 0 , 1 , 2 , 3 , z = - 4 , - 3 , - 2 , - 1 , 0 , 1 , 2 , 3 , z = − 4 , − 3 , − 2 , − 1 , 0 , 1 , 2 , 3 ,
编写一个计算机例程,生成形状参数为 β \beta β β = 2.5 \beta = 2 . 5 β = 2.5 θ = 0.2 \theta = 0 . 2 θ = 0.2 1 / θ = 5 1 / \theta = 5 1/ θ = 5
编写一个计算机例程,从习题 1 至 23 中的某个随机变量生成 2000 个取值。把这 2000 个取值作成直方图,并与理论密度函数(或对离散随机变量而言为概率质量函数)作比较。
许多电子表格、符号计算和统计分析程序都带有用于从标准分布生成随机变量的内置例程。查阅其中一个软件包的文档,看看它使用了什么样的随机变量生成方法。如果某个随机变量发生器的方法没有文档说明,你是否应当信任它?
假定我们不知怎的获得了一个均值为 1 的指数分布随机变量的来源。编写一个算法,通过变换指数分布随机变量来生成三角分布的随机变量。[提示:先作变换以得到均匀分布的随机变量。]
令时刻 t = 0 对应于上午 6 点,并假定某家早餐餐厅(营业时间为上午 6 点至 9 点)的顾客到达率(以每小时到达数计)为
λ ( t ) = { 30 , 0 ≤ t < 1 45 , 1 ≤ t < 2 20 , 2 ≤ t ≤ 4
\lambda (t) = \left\{\begin{array}{l l} 30, & 0 \leq t < 1 \\ 45, & 1 \leq t < 2 \\ 20, & 2 \leq t \leq 4 \end{array} \right.
λ ( t ) = ⎩ ⎨ ⎧ 30 , 45 , 20 , 0 ≤ t < 1 1 ≤ t < 2 2 ≤ t ≤ 4 推导一个抽稀算法,用于从该 NSPP 生成到达,并生成前 100 个到达时刻。
从区间 [0, 1] 上参数为 β 1 = 1.47 \beta_{1} = 1 . 47 β 1 = 1.47 β 2 = 2.16 \beta_{2} = 2 . 16 β 2 = 2.16
假定某个离散分布可取值为 ν 1 , ν 2 , … , ν k \nu_{1} , \nu_{2} , \dots , \nu_{k} ν 1 , ν 2 , … , ν k 1 , 2 , … , k 1 , 2 , \ldots , k 1 , 2 , … , k
假定某网站的点击到达率为 λ ( t ) = 1000 + 50 sin ( 2 π t / 24 ) \lambda ( t ) = 1000 + 50 \sin ( 2 \pi t / 24 ) λ ( t ) = 1000 + 50 sin ( 2 π t /24 )
www.bcnn.net 上提供的资料清单
RandomNumberTools.xls