10 仿真模型的验证、校准与确认
模型开发者所面临的最重要、也是最困难的任务之一,就是对仿真模型进行验证(verification)与确认(validation)。那些利用模型输出辅助提出设计建议的工程师与分析师,以及依据这些建议作出决策的管理者,出于理应对模型的有效性抱有一定程度的怀疑。模型开发者的职责在于,在开发与确认的整个过程中与最终用户密切合作,以减少这种怀疑并提高模型的可信度。
确认过程的目标有两重:(a) 造出一个能够足够贴近地再现真实系统行为的模型,使得该模型可以充当实际系统的替代物,用于对系统进行试验、分析系统行为、预测系统性能;(b) 把模型的可信度提高到可接受的水平,从而使模型能被管理者及其他决策者所采用。
确认不应当被视为模型开发之后一系列孤立的做法,而应当被视为模型开发不可分割的一部分。不过,从概念上说,验证与确认过程由下列组成部分构成:
验证(verification)关注的是把模型建造正确(building the model correctly)。它通过把概念模型(conceptual model)与实现这一概念的计算机表示进行对比来推进。它提出的问题是:模型在仿真软件中是否被正确地实现?模型的输入参数和逻辑结构是否得到了正确的表示?
确认(validation)关注的是建造正确的模型(building the correct model)。它试图证实模型是对真实系统的准确表示。确认通常通过模型的校准(calibration)来实现——这是一个迭代过程:把模型与实际系统行为作比较,利用两者之间的差异以及由此获得的见解来改进模型。这一过程反复进行,直到模型精度被认为可以接受。
本章描述在验证与确认过程中已被推荐和实际使用的各种方法。这些方法大多数是非形式化的主观比较,少数是形式化的统计程序。使用后面这些程序会牵涉到与输出分析有关的问题。输出分析(output analysis)是指对仿真所产生的数据进行分析,并从这些数据出发,就真实系统的行为作出推断。概括它们之间的关系:确认正是模型使用者获得信心的过程——即相信输出分析正在对所研究的真实系统作出有效的推断。
关于验证与确认,已有大量文章和教材章节可供阅读。关于主要问题的讨论,读者可参阅 Balci [1994, 1998, 2003]、Carson [1986, 2002]、Gass [1983]、Kleijnen [1995]、Law 与 Kelton [2000]、Naylor 与 Finger [1967]、Oren [1981]、Sargent [2003]、Shannon [1975] 以及 van Horn [1969, 1971]。关于与确认各方面相关的统计技术,读者除可获取上述文献外,还可查阅 Balci 与 Sargent [1982a,b; 1984a]、Kleijnen [1987] 和 Schruben [1980] 的文献。关于以确认为重点的案例研究,读者可参阅 Carson 等 [1981a,b]、Gafarian 与 Walsh [1970]、Kleijnen [1993] 以及 Shechter 与 Lucas [1980]。关于确认的文献书目已由 Balci 与 Sargent [1984b] 以及 Youngblood [1993] 出版。
1 模型构建、验证与确认
模型构建的第一步,是观察真实系统及其各组成部分之间的相互作用,并收集关于其行为的数据。但单靠观察很少能产生对系统行为的充分理解。应当询问熟悉该系统或其中任一子系统的人员,以利用他们的专门知识。操作员、技术员、维修与保养人员、工程师、主管和管理者都了解系统的某些方面,而这些方面可能是他人所不熟悉的。随着模型开发的推进,可能出现新的问题,模型开发者会返回这一步,以进一步了解系统的结构与行为。
模型构建的第二步,是构造概念模型——一组关于系统各组成部分及其结构的假设,外加关于模型输入参数取值的假设。如图 1 所示,概念确认(conceptual validation)就是真实系统与概念模型之间的比较。
第三步是运行模型(operational model)的实现,通常通过使用仿真软件,把概念模型中的各项假设并入仿真软件的世界观和概念之中。
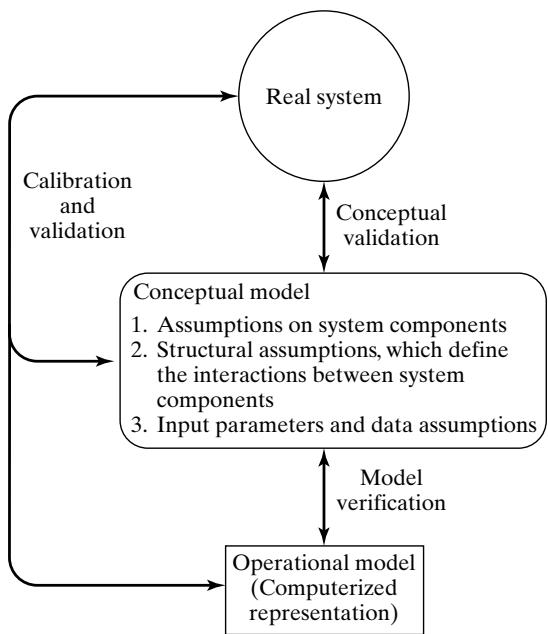
图 1 模型构建、验证与确认。
实际上,模型构建并不是一个由三个步骤构成的线性过程。相反,在构建、验证和确认模型的过程中,模型构建者会多次返回上述每一个步骤。图 1 描绘的是持续进行的模型构建过程:对验证与确认的需要,促使人们不断地把真实系统与概念模型和运行模型两者进行比较,并促使人们反复修改模型以提高其精度。
2 仿真模型的验证
模型验证的目的是保证概念模型在运行模型中得到准确反映。概念模型往往涉及对系统运行的某种程度的抽象,或对实际操作作某种程度的简化。验证要提出以下问题:概念模型(关于系统组成部分与系统结构的假设、参数取值、抽象与简化)是否被运行模型准确地表示?
在验证过程中可以采用许多常识性的建议:
应当由其开发者之外的他人来检查运行模型,最好是仿真软件方面的专家。
绘制一张流程图,其中包含事件发生时系统可能采取的每一种逻辑上可能的动作,并针对每一种事件类型、沿着模型逻辑逐一跟踪每个动作。
在输入参数的各种设定下,仔细检查模型输出是否合理。让已实现的模型显示多种多样的输出统计量,并把其中每一项都仔细检查一遍。
让运行模型在仿真结束时打印出输入参数,以确保这些参数取值没有被无意改动。
尽可能使运行模型具备自我文档化的能力。对所用的每一个变量给出精确定义,并对每一个子模型、过程(或代码的主要部分)、部件或其他模型细分给出其用途的一般性说明。
如果运行模型带有动画,应核实动画中所见的情形是否模仿了实际系统。通过动画可以观察到的错误例子包括:自动导引车(AGV)在单行通道上或在交叉口处相互穿越,以及实体在仿真过程中(无意地)消失。
交互式运行控制器(Interactive Run Controller, IRC)或调试器是成功构建仿真模型不可或缺的组成部分。即使是最优秀的仿真分析师,在构建模型时也会犯错误或出现逻辑错误。IRC 通过以下方式帮助发现并纠正这些错误:
(a) 可以在仿真推进的过程中对其进行监控。做法可以是:把仿真推进到经过所期望的时间为止,然后显示该时刻的模型信息。另一种做法是:把仿真推进到某一特定条件成立为止,然后显示信息。
(b) 可以把注意力集中到某个特定实体、代码行或过程上。例如,每当一个实体进入指定过程时,仿真就会暂停,以便收集信息。再如,每当某个特定实体变为活动状态时,仿真也会暂停。
(c) 可以观察所选模型分量的取值。当仿真暂停时,可以观察变量、属性、队列、资源、计数器等的当前取值或状态。
(d) 可以暂时挂起或暂停仿真,不仅是为了查看信息,也可以是为了重新赋值或改变实体的流向。
建议使用图形界面来完成验证与确认 [Bortscheller and Saulnier, 1992]。模型的图形表示本质上就是自我文档化的一种形式,它简化了理解模型这项工作的难度。
这些建议基本上与任何软件工程师都会遵循的建议相同。
在这些常识性建议之中,有一条非常容易实现、却常常被忽视——尤其是被正在学习仿真的学生所忽视——那就是仔细而彻底地检查模型输出是否合理(即建议 3)。例如,考虑一个由许多串联和并联配置的服务中心构成的复杂排队网络模型。假定建模者主要关注响应时间(response time),其定义为顾客通过网络中某个指定部分所需的时间。在模型开发的验证(以及校准)阶段,建议程序除响应时间之外,还收集并打印出许多统计量,例如服务台的利用率、各子系统中的顾客时间平均数。例如,对某个服务台利用率的检查,可能揭示其值不合理地偏低(或偏高),这可能是一种错误,而错误的原因可能是平均服务时间规定有误,也可能是模型逻辑上的失误——它把过少(或过多)的顾客派送给了这个特定的服务台,或者是其他种种可能的参数规定不当或逻辑错误。
在能够自动收集许多标准统计量(平均队长、平均等待时间等)的仿真语言中,显示几乎所有感兴趣的统计量所需额外编程工作极少,甚至无需额外工作。而在 C、C++ 或 Java 这样的通用语言中,所需工作量就要大得多,因为它们不具备帮助程序员收集统计量的功能。
能够迅速指示模型是否合理的两组统计量是当前存量(current contents)和累计计数(total count)。这些统计量适用于任何有某种物品在其中流动的系统,不论这些物品被称为顾客、交易、库存还是车辆。当前存量是指在给定时刻系统各组成部分中物品的数量。累计计数是指在给定时刻之前进入系统各组成部分的物品总数。在某些仿真软件中,这些统计量会自动保存,并可在仿真时间的任意点显示出来。在另一些仿真软件中,则可能必须在运行模型中加入简单的计数器,并在适当的时刻显示它们。如果系统某一部分的当前存量很高,这一状况表明有大量实体被延误了。如果针对逐渐加长的仿真运行时间显示输出,并发现当前存量或多或少呈线性增长,那么极有可能某个队列是不稳定的,而服务台将随时间推移而愈发落后。这可能表明服务台的数量太少,或者某个服务时间规定有误。另一方面,若某个子系统的累计计数为零,则表明没有任何物品进入该子系统——这同样是一个极可疑的现象。另一种可能是当前计数与累计计数都等于一。这可能表明某个实体占用了某项资源却从未释放该资源。针对不同运行长度对这些统计量作仔细评估,有助于发现模型逻辑错误和数据规定不当。检查输出的合理性通常无法发现较为隐蔽的错误,但它是发现严重错误最快的方式之一。为了有助于错误检测,最好的做法是在运行模型之前,先由模型开发者预测所选输出统计量的合理取值范围。这样的预测可以减少对偏差强加合理化解释、从而不去调查异常输出原因的可能。
对于某些模型,可以考虑的不只是某一特定统计量是否合理,还可以计算某些长期性能度量。例如,分析人员可以对大量排队系统计算长期服务台利用率,而无须对到达间隔时间或服务时间分布作任何特殊假设。通常所需的信息仅仅是网络配置加上到达率与服务率。任何能够用解析方法计算、然后与其仿真值相比较的性能度量,都为验证提供了又一件有用的工具。推测仿真仿真的目标是估计某个无法用解析方法计算的性能度量,例如平均响应时间;但是,排队系统中的所有性能度量都是相互关联的。因此,如果一个仿真模型正确地预测了某一项度量(例如利用率),那么对模型预测其他相关度量(例如响应时间)之能力的信心也会随之增强(尽管这两项度量之间的确切关系一般说来是未知的,并且因模型而异)。反过来,如果一个模型错误地预测了利用率,那么它对其他量(例如平均响应时间)的预测就极值得怀疑。
有助于验证过程的另一项重要方式,是常被忽视的文档编制阶段。如果模型构建者在运行模型中写上简要注释,再加上所有变量和参数的定义,再加上运行模型各个主要部分的说明,那么他人(或日后模型构建者本人)验证模型逻辑就要容易得多。文档编制对于澄清模型逻辑、核实其完备性同样重要。
一种更为精巧的技术是使用跟踪(trace)。一般来说,跟踪给出带时间戳的详细仿真输出,表示每当事件发生时某一组选定系统状态、实体属性和模型变量的取值。也就是说,在事件发生时刻,模型会把详细的状态信息写入文件,供模型开发者事后查阅,以辅助模型验证和建模错误的发现。
例 1
在验证《电子表格中的仿真示例》一章例 5 中单服务台排队模型的运行模型时(在 C、C++ 或 Java 这样的通用语言中,或在大多数仿真语言中),一位分析人员运行了 16 个时间单位,并观察到排队线的时间平均长度为 位顾客;对于一次仅 16 个时间单位的短运行来说,这当然是合理的。尽管如此,该分析人员仍认为作一次更为细致的验证是有价值的。
图 2 中的跟踪给出了从仿真时刻 CLOCK 0 到 CLOCK 16 的假想跟踪输出,所针对的是《电子表格中的仿真示例》一章例 5 中那个简单的单服务台队列。本例说明,当从汇总输出统计量(如 )的检查中看不出任何错误时,如何借助跟踪发现错误。请注意,在仿真时刻 CLOCK 3,系统中的顾客数为 ,但服务台却是空闲的(STATUS 0)。这一错误的来源可能是逻辑不正确,也可能仅仅是没有把属性 STATUS 置为取值 1(在通用语言或大多数仿真语言中编码时)。
无论如何,这一错误必须被发现并纠正。请注意,检查汇总度量(即输出)这种较为不精细的做法并未能发现该错误。利用等式 ,读者可以核实 是如何由数据正确计算出来的( 是 NCUST 减去 STATUS 的时间平均值):
正如前面所提到的。因此,输出度量 的取值是合理的,并且是由数据正确计算出来的,但它的数值确实错了,因为属性 STATUS 没有取到正确的值。从图 2 可以看出,跟踪提供了关于模型实际历史的信息,其细节与信息量都超过仅有汇总度量所能提供的信息。
大多数仿真软件都内置了执行跟踪的能力,程序员无须作大量编程。此外,在通用语言中,可以使用一条 ‘print’(打印)或 ‘write’(写出)语句来实现跟踪功能。
不难想象,跨越很长一段仿真时间的跟踪会迅速产生极其大量的输出,而逐项详细检查其正确性将是极其麻烦的。跟踪的目的在于通过进行详尽的纸笔计算来验证计算机程序的正确性。为了使这一点切实可行,带有跟踪的仿真通常被限制在一个很短的时间段内。下面给出的是这种跟踪输出的一例。
图 2 仿真跟踪(Simulation Trace)。
当然,最好是确保每一类事件(例如 Arrival)至少发生一次,以便检查其后果以及它对模型的影响是否准确。如果某一事件特别罕见,则可能必须使用人工数据来迫使它在一次短时仿真中发生。这是合理的,因为其目的在于核实该罕见事件对系统的作用是否符合预期。
有些软件允许选择性跟踪(selective trace)。例如,可以把跟踪设置在模型中的特定位置,或者设定在某个指定的仿真时刻触发跟踪。每当一个实体经过所指定的位置时,仿真软件就向跟踪文件写入一条带时间戳的消息。有些仿真软件还允许对某个选定实体进行跟踪;每当该指定实体变为活动状态时,跟踪即被启动,并写入带时间戳的消息。这种跟踪在追踪某一个实体贯穿整个模型的过程中非常有用。选择性跟踪的另一个例子,是把跟踪设置为在某个特定条件出现时触发。例如,每当某个资源前面的队列达到五个或更多时,就打开跟踪。这样就可以让仿真一直运行到出现异常情况,然后从该时刻起考察其行为。不同的仿真软件包对跟踪的支持程度各不相同。在实践中,它往往是由模型开发者在模型中的适当位置加入打印消息来实现的。
在三类技术——常识性技术、周密的文档编制和跟踪——之中,建议前两类总是要做的。对模型输出作合理性检查,尤其有价值、也尤其有信息量。通用跟踪可能产生大量数据,远远超出可用或可供仔细检查的规模。而选择性跟踪则可以就关键模型分量提供有用信息,并把数据量维持在可管理的水平上。
3 模型的校准与确认
校准与确认虽然在概念上彼此不同,但通常是由建模者同时进行的。确认是把模型及其行为与真实系统及其行为进行对比的总体过程。校准则是把模型与真实系统作比较、对模型作出调整(甚至作出重大修改)、再把修改后的模型与现实作比较、再作进一步调整、再次比较,如此往复的迭代过程。图 3 展示了模型校准与整个确认过程之间的关系。把模型与现实作比较,是通过各种不同的检验来进行的——有些是主观的,有些是客观的。主观检验通常涉及那些对系统的一个或多个方面有所了解的人,由他们对模型及其输出作出判断。客观检验则总是需要系统行为的数据,以及模型所产生的相应数据。然后进行一项或多项统计检验,把系统数据集的某个方面与模型数据集的同一方面进行比较。这一"把模型与系统作比较、再修改概念模型和运行模型以适应所察觉到的模型缺陷"的迭代过程,将一直持续下去,直到模型被认为足够准确为止。
对校准阶段可能提出的一种批评是:如果校准就此为止,那么模型仅仅是针对所用的那一组数据完成了确认——也就是说,模型被"拟合"到了单一数据集上。减轻这一批评的一种办法,是收集一组新的系统数据(或预留原系统数据的一部分),以便在确认的最后阶段使用。也就是说,在用原系统数据集完成校准之后,用第二个系统数据集进行一次"最终"确认。如果在"最终"确认工作中发现模型与真实系统之间存在不可接受的差异,建模者就必须返回校准阶段并修改模型,直到模型变得可以接受为止。
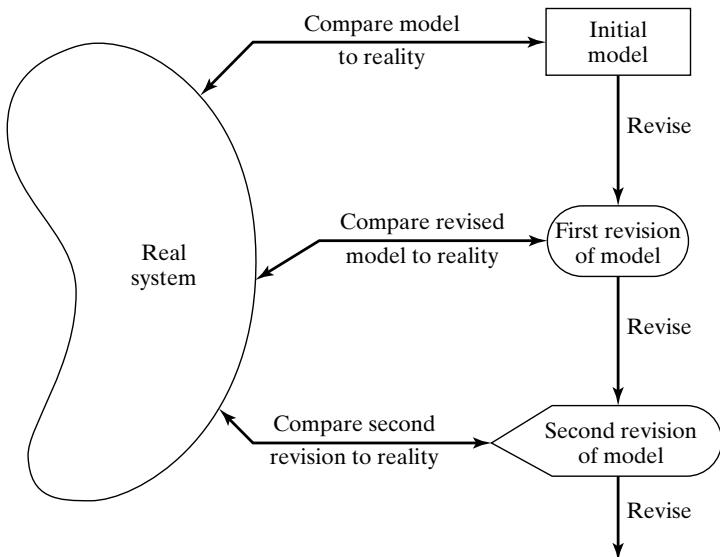
图 3 模型的迭代校准过程。
确认不是非此即彼的命题——任何模型都不可能完全代表所研究的系统。此外,如图 3 所示,模型的每一次修订都要花费一定的成本、时间和精力。建模者必须权衡模型精度可能提高(但并无保证)与确认工作成本增加之间的得失。通常,建模者(以及模型使用者)对模型预测与系统行为之间可以容忍的最大偏差有某种约定。如果在预算约束内无法达到这一精度水平,那么要么必须降低对模型精度的期望,要么必须放弃该模型。
作为确认过程中的一种辅助手段,Naylor 与 Finger [1967] 提出了一个被广泛遵循的三步方法:
步骤 1. 构建一个具有很高表面效度(face validity)的模型。
步骤 2. 确认模型假设。
步骤 3. 把模型的输入—输出变换与真实系统相应的输入—输出变换作比较。
接下来的五个小节将详细考察这三个步骤。
3.1 表面效度
仿真建模者的第一个目标,是构造一个在表面上看对模型使用者以及其他熟悉所仿真真实系统的人而言显得合理的模型。模型的潜在使用者应当从模型概念化直到实现的整个过程中都参与模型构建,以确保通过关于系统结构的合理假设和可靠数据,把高度的现实性融入模型之中。潜在使用者以及熟悉情况的人也可以评价模型输出是否合理,并有助于识别模型的缺陷。因此,随着模型因初始模型缺陷被识别而得到的见解而迭代改进,使用者可以参与校准过程。用户参与的另一项好处,是模型被感知到的有效性与可信度得以提高;没有这种可信度,管理者便不会愿意把仿真结果作为决策的依据。
敏感性分析也可以用来检验模型的表面效度。向模型使用者提出这样的问题:当一个或多个输入变量发生改变时,模型的行为是否符合预期。例如,在大多数排队系统中,如果顾客到达率(或对服务的需求)上升,那么可以预期服务台的利用率、排队长度和延误都会趋于增加(尽管增加多少可能无从知晓)。凭经验以及对真实系统(或类似的相关系统)的观察,建模者与模型使用者大概至少对输入变量增减时模型输出变化的方向有某种概念。对大多数大规模仿真模型而言,输入变量很多,因而可能的敏感性测试也很多。如果改变所有输入变量的代价过高或耗时过长,模型构建者就必须设法选出最关键的输入变量进行测试。如果至少有两种输入参数设定下的真实系统数据可用,那么就可以通过适当的统计技术进行客观的、科学性的敏感性测试。
3.2 模型假设的确认
模型假设大致分为两类:结构假设和数据假设。结构假设涉及系统如何运行的问题,通常涉及对现实的简化与抽象。例如,考虑一家银行的顾客排队与服务设施。顾客可以排成一条队列,也可以为每个柜台员各设一条单独的队列。如果有多条队列,顾客可以严格按先到先服务接受服务,也可能在某条队列移动更快时改换队列。柜台员的数量可以是固定的,也可以是可变的。这些结构假设应通过在适当的时间段内进行实地观察,以及通过与银行管理者和柜台员就银行政策及这些政策的实际执行情况进行讨论来加以核实。
数据假设应当建立在收集可靠数据以及对数据作正确统计分析的基础上。例如,在前面提到的银行研究中,所收集的数据包括:
高峰负荷(“rush-hour”)的几个 2 小时时段内顾客的到达间隔时间;
非高峰时段内的到达间隔时间;
商业账户的服务时间;
个人账户的服务时间。
数据的可靠性通过与银行管理者协商来核实,由他们指出典型的高峰时段和典型的非高峰时段。当把两个或两个以上在不同时刻收集的数据集合并起来时,还可以借助数据同质性的客观统计检验进一步增强数据的可靠性。(在不同时刻收集的两个个人账户服务时间数据集 X 和 Y,是否来自同一个母体?若是,则这两组数据可以合并。)此外还可能需要其他检验,以检验数据中是否存在相关性。只要分析人员确信所处理的是一个随机样本(即不存在相关性),统计分析就可以开始。
无论手工完成还是借助专用软件完成,分析都由三个步骤构成:
步骤 1. 确定一个合适的概率分布。
步骤 2. 估计所假设分布的参数。
步骤 3. 用拟合优度(goodness-of-fit)检验(如卡方检验或 Kolmogorov-Smirnov 检验)以及图示方法,确认所假定的统计模型。
使用拟合优度检验是数据假设确认中的一项重要内容。
3.3 输入—输出变换的确认
对一个模型而言最根本的检验,实际上也是就整个模型而言唯一的客观检验,就是这样一项能力:当模型输入数据与实际输入相符、且模型中实现的一项政策也将在系统的某个时点得到实施时,模型能够预测真实系统未来的行为。而且,如果某些输入变量的水平(例如,到服务设施的顾客到达率)上升或下降,模型应当准确预测在类似情形下真实系统中会发生什么。换句话说,模型的结构应当足够准确,使模型不仅能针对一组输入数据作出良好预测,而且能针对所关注的一系列输入数据作出良好预测。
在确认过程的这一阶段,模型被视为一种输入—输出变换——也就是说,模型接受输入参数的取值,并把这些输入变换为输出性能度量。所确认的正是这种对应关系。
建模者也可以不去用"预测未来"的方式来确认模型的输入—输出变换,而改用专供确认之用的历史数据——也就是说,如果已有一组数据集用于开发和校准模型,那么建议另用一组独立的数据集作为最终的确认检验。这样,为了确认模型的目的,准确的"对过去的预测"就可以取代对未来的预测。
模型通常是围绕一组特定的系统响应而开发的,这些响应需要在某个输入条件范围下测量。例如,在排队系统中,响应可能是服务台利用率和顾客延误,而输入条件(或输入变量)范围可能包括某个站点有两三个服务台以及若干可选的调度规则。在生产系统中,响应可能是产出量(即每小时产量),而输入条件可能是若干台以不同速度运转的机器的可选组合,每台机器又有各自的故障与保养特性。
无论如何,建模者都应当以主要的关注响应作为确认模型的首要判据。如果模型后来被用于与其原始用途不同的目的,就应当针对新的关注响应、在可能已变化的输入条件下对模型重新确认。
确认输入—输出变换的一个必要条件是:所研究系统的某个版本必须已经存在,从而能够收集至少一组输入条件下的系统数据,以便与模型预测作比较。如果该系统尚处在规划阶段、无法收集系统运行数据,那么完整的输入—输出确认就不可能进行。此时应在可能的范围内采用其他类型的确认。在某些情形下,规划系统的某些子系统可能已经存在,从而可以进行局部的输入—输出确认。
推测该模型将被用于比较备选的系统设计,或用于考察一系列新输入条件下的系统行为。现在暂且假定系统的某个版本正在运行,并且既有系统的模型已经完成了确认。那么,当使用不同的输入时,关于模型的有效性又能说些什么呢?也就是说,如果改变模型输入以代表一种新的系统设计、一种新的系统运行方式,甚至某种假想的未来情形,那么,对于这个新的但尚不存在的拟建系统,或者对于处于新输入条件下的系统,模型的有效性能说些什么呢?
第一,在相似输入条件下两个模型的响应,将被用作比较既有系统与拟建系统的判据。确认会增强建模者对既有系统模型准确性的信心。第二,在许多情形下,拟建系统是既有系统的某种修改,建模者希望对既有系统模型的信心能够转移到新系统的模型上。若新模型相对于旧模型在运行模型方面的改动属于相对较小的改动,这种信心的转移通常是可以成立的(对实际系统而言,这可能是一次重大改动)。运行模型方面的改动从相对较小到相对较大,包括以下几类:
单个数值参数的微小改动,例如机器的速度、顾客到达率(到达间隔时间的分布形式不变)、并联服务中心的服务台数量,或机器的平均失效时间与平均修复时间;
统计分布形式的微小改动,例如服务时间的分布或机器失效时间的分布;
某个子系统逻辑结构的重大改动,例如排队模型中排队规则的改变,或作业车间模型中调度规则的改变;
涉及新系统采用不同设计的重大改动,例如用计算机化库存控制系统取代旧的非计算机化系统,或用自动存储与检索系统取代由工人使用叉车人工取件的仓库系统。
如果对运行模型的改动属于微小改动,例如第 1 项或第 2 项,那么这些改动可以经过仔细验证,新模型的输出可以相当有把握地被接受。如果别处存在足够相似的子系统,那么或许可以先确认代表该子系统的子模型,再把这个子模型与其他已确认的子模型结合起来,构成一个完整的模型。这样一来,第 3 项和第 4 项中那些实质性模型改动的部分确认就有可能实现。遗憾的是,对于一个尚不存在的系统,其模型的输入—输出变换无法得到完全确认。无论如何,在时间与预算约束之内,建模者都应当尽可能多地采用各种确认技术;如果能够收集到这类子系统的运行数据,还应当对子模型进行输入—输出确认。
例 2 将说明输入—输出确认可能采用的某些技术,并将更详细地讨论输入变量、不可控变量、决策变量、输出(响应)变量和输入—输出变换这些概念。
例 2:贾斯帕尔第五国民银行
如图 4 所示,贾斯帕尔第五国民银行正计划扩充其位于主街街角的免下车(drive-in)服务。目前只有一个免下车窗口,由一名柜台员提供服务。免下车窗口只允许一笔或两笔交易同时进行,因此曾假定每次服务时间都是来自某个潜在总体的随机样本。针对某个星期五上午 11:00 至下午 1:00 之间到达的 90 位顾客,收集了服务时间 和到达间隔时间 。这一时段是在与管理层和柜台员协商之后选定的,因为人们认为它能代表一个典型的高峰期。
数据分析得出结论:到达可用速率为每小时 45 位顾客的泊松过程来建模,而服务时间近似服从正态分布,其均值为 1.1 分钟,标准差为 0.2 分钟。
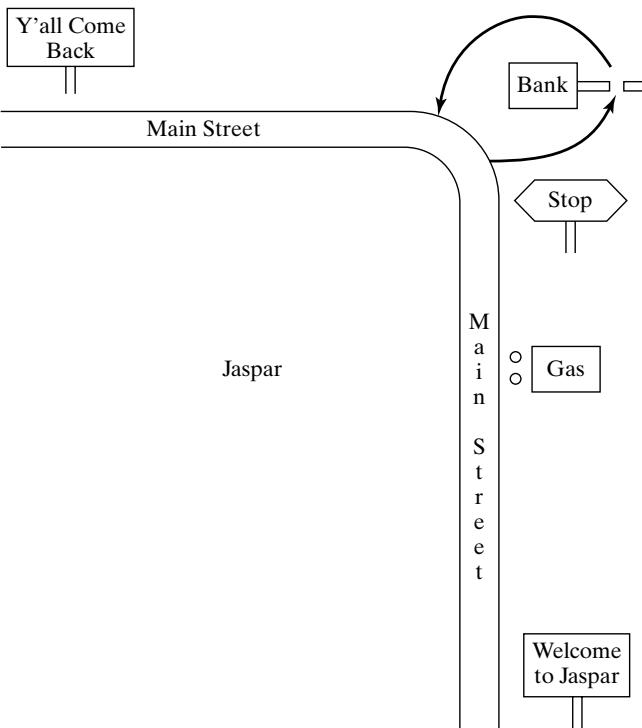
图 4 第五国民银行的免下车窗口。
因此,模型有两个输入变量:
- 到达间隔时间,服从速率为 /小时的指数分布(即泊松到达过程);
- 服务时间,假定为
每个输入变量都有一个水平:到达间隔时间的速率为 /小时,服务时间的均值为 1.1 分钟、标准差为 0.2 分钟。到达间隔时间是不可控变量(uncontrollable variable,即在真实系统中管理者无法控制)的例子。服务时间同样被当作不可控变量处理,尽管服务时间的水平可能是部分可控的。如果通过安装一台计算机终端可以把平均服务时间降低到 0.9 分钟,那么服务时间变量的水平就成为一个决策变量或可控参数。把所有决策变量都设定在某个水平上即构成一项政策。例如,当前的银行政策是:一名柜台员 、平均服务时间 分钟、以及一条供等候车辆使用的排队线 。( 用来表示决策变量。)决策变量处于管理者的控制之下;而不可控变量(如到达率和实际到达时刻)则不受管理者控制。到达率可能随时间而变化,但这种变化被视为由管理者控制之外的外部因素所造成。
表 1 当前银行运营模型的输入变量与输出变量
| 输入变量 | 模型输出变量 Y |
|---|---|
| D = 决策变量 | 管理者主要关注的变量(Y1, Y2, Y3) |
| X = 其他变量 | |
| Y1 = 柜台员利用率 | |
| 泊松到达,速率 = 45/小时 | Y2 = 平均延误 |
| X11, X12, … | Y3 = 最大队长 |
| 服务时间,N(D2, 0.22) | 次要关注的其他输出变量 |
| X21, X22, … | |
| Y4 = 观测到的到达率 | |
| D1 = 1(一名柜台员) | Y5 = 平均服务时间 |
| D2 = 1.1 分钟(平均服务时间) | Y6 = 服务时间的样本标准差 |
| D3 = 1(一条队列) | |
| Y7 = 排队线的平均长度 |
一个关于当前银行运营的模型已经开发出来,并在与银行管理层和员工的密切协商中得到验证。模型假设已按第 3.2 节所讨论的方式得到确认。由此得到的模型现在被视为一个"黑箱"(black box),它接受所有输入变量的规定,并把它们变换为一组输出(响应)变量。输出变量由仿真所生成的全部感兴趣统计量组成。例如,管理者关心免下车窗口柜台员的利用率(柜台员在窗口忙碌的时间百分比)、顾客从到达至开始服务的平均延误(以分钟计),以及高峰期内的最大队长。这些输入变量与输出变量如图 5 所示,并连同若干附加的输出变量一起列于表 1。不可控的输入变量用 X 表示,决策变量用 D 表示,输出变量用 Y 表示。从"黑箱"的角度看,模型接受输入 X 和 D 并产生输出 ,即
或
这里 f 表示由模型结构所决定的变换。对于第五国民银行的研究,模型中生成的顾客 与顾客 n 之间的指数分布到达间隔时间记为 。(不要把 与 混淆;后者是对真实系统所作的观察值。)模型中为顾客 n 生成的服从正态分布的服务时间记为 。当前运营下,决策变量集合(即政策)为 。输出(响应)变量记为 ,其定义见表 1。
要使银行模型输入—输出变换的确认成为可能,必须有真实系统数据可用,并且能与表 1 中模型输出 Y 的至少一部分相比较。系统响应应当在与输入数据 收集期间相同的时段内(同一个星期五上午 11:00 至下午 1:00)收集。这一点很重要,因为如果系统响应数据是在某个较为清淡的日子收集的(比如到达率为每小时 40),那么系统响应(例如柜台员利用率 、平均延误 、最大队长 )就会低于到达率为每小时 45 的时段内所观测到的相同变量。假定相继顾客的延误是在同一个星期五上午 11:00 至下午 1:00 之间测量的,并且发现平均延误为 分钟。就确认而言,我们把它视为真实均值 。
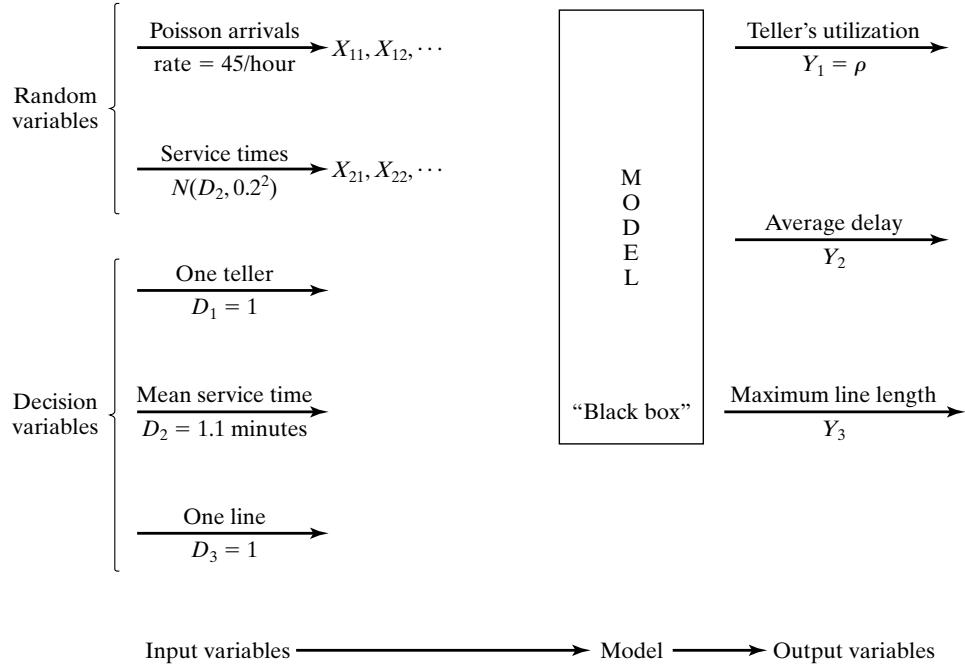
图 5 模型的输入—输出变换。
当模型以生成的随机变量 和 运行时,可以预期平均延误 的观测值应当接近 分钟。所生成的输入值 和 不能指望与真实系统的实际输入值 和 完全重合,但可以指望它们重现实际输入的统计模式。因此,由仿真生成的 值应当与所观测到的系统变量 分钟相一致。那么,建模者可以怎样检验这种一致性呢?
建模者对模型作少量统计上独立的重复(replication)。统计独立性通过使用随机数发生器所产生的互不重叠的随机数组,或为每次重复独立地选择种子(从随机数表中选取)来保证。六次独立重复(每次持续 2 小时)的结果见表 2。
每一次模型重复所观测到的到达率 和样本平均服务时间 也一并记录下来,以便分别与规定值 45/小时和 1.1 分钟作比较。确认检验由把系统响应(即平均延误 分钟)与模型响应 作比较构成。形式上,要对如下原假设与备择假设进行统计检验:
如果 不被拒绝,那么根据这一检验,没有理由认为模型无效。如果 被拒绝,则当前版本的模型被否决,建模者必须设法改进模型,如图 3 所示。按这里的表述,适当的统计检验是 t 检验,其进行方式如下:
选取显著性水平 α 和样本量 n。对于银行模型,选取
计算 n 次重复上的样本均值 和样本标准差 S:
以及
其中 如表 2 所示。
从附录中的表 A.5 查得 t 的临界值。对于式 (1) 这样的双侧检验,使用 ;对于单侧检验,视情形使用 或 (n − 1 为自由度)。由表 ,双侧检验时 。
表 2 银行模型六次重复的结果
| 重复 | (到达数/小时) | (分钟) | = 平均延误(分钟) |
|---|---|---|---|
| 1 | 51 | 1.07 | 2.79 |
| 2 | 40 | 1.12 | 1.12 |
| 3 | 45.5 | 1.06 | 2.24 |
| 4 | 50.5 | 1.10 | 3.45 |
| 5 | 53 | 1.09 | 3.13 |
| 6 | 49 | 1.07 | 2.38 |
| 样本均值 | 2.51 | ||
| 标准差 | 0.82 |
计算检验统计量
其中 是原假设 中所规定的取值。这里 分钟,因此
对于双侧检验,若 $ \left| t_{0} \right| > t_{\alpha / 2 , n - 1} $,则拒绝 ;否则不拒绝 。[对于单侧检验,若 ,则当 时拒绝 ;若 ,则当 时拒绝 。]由于 $ | t | = 5 . 34 > t_{0 . 025 , 5} = 2 . 571 $,拒绝 ,从而得出结论:该模型在预测顾客平均延误方面是不充分的。
请记住,在假设检验中,拒绝原假设 是一个很强的结论,因为
而显著性水平 α 取得很小,比如这里所取的 。式 (3) 表明,在 确实为真时错误地拒绝 的概率很低()——也就是说,在模型确实有效(就所检验的变量而言)的情况下判定模型无效的概率很小。使 t 检验成立的条件是:观测值 服从正态分布且相互独立。在本例中,这些条件是否得到满足呢?
第 i 个观测值 是第 i 次 2 小时仿真运行中所有开始接受服务的免下车顾客的平均延误;因此,根据中心极限定理可以合理地假定每个观测值 近似服从正态分布,前提是它所基于的顾客数量不太少。
观测值 在设计上就是统计独立的——即通过为每次重复独立地选择随机数种子,或通过使用互不重叠的随机数流来实现。
由式 (2) 计算的 t 统计量是一个稳健统计量——也就是说,即使 并非严格服从正态分布,它也近似服从自由度为 n − 1 的 t 分布,因而表 A.5 中的临界值可以被可靠地使用。
既然贾斯帕尔第五国民银行的模型被发现存在不足,建模者应当怎么办?经过进一步调查,建模者意识到模型中包含两条未言明的假设:
当一辆汽车到达时发现窗口正好空闲,柜台员就立即开始服务。
在有车辆等候的情况下,一次服务结束与下一次服务开始之间不存在延迟。
假定 2 被发现大致正确,因为一次服务时间被认为从柜台员实际开始服务时算起,但直到那辆汽车驶出免下车窗口、且下一辆汽车(如果有的话)开始服务、或者柜台员看到队列为空时,才认为服务结束。另一方面,假定 1 被发现是不正确的,因为柜台员还有其他职责——主要是在没有车辆排队时服务步行进店的顾客——而且柜台员总是先服务完上一位顾客,然后才开始为汽车服务。调查发现,高峰期内始终有步行进店的顾客在场;这些交易大多是商业性质的,所需时间比服务免下车顾客所需的时间长得多;并且,当一辆到达的汽车发现窗口前没有其他汽车时,它必须等到柜台员服务完当前的步行进店顾客之后才能接受服务。为纠正这一模型缺陷,模型的结构作了改变,把对柜台员时间的额外需求纳入其中,并收集了步行进店顾客的服务时间数据。对这些数据的分析发现,它们近似服从均值为 3 分钟的指数分布。
修改后的模型再次运行,所得结果见表 3。按照前面所列的步骤,再次对原假设 : 分钟进行检验。
选取 和 (样本量)。
计算 分钟, 分钟。
查表 A.5,得临界值 。计算检验统计量 由于 $ | t_{0} | < t_{0 . 025 , 5} = 2 . 571 $,不拒绝 ,从而暂时接受该模型为有效的。
除非已经估计出检验的功效(power)并发现其很高(接近 1),否则不拒绝 必须被视为一个薄弱的结论——也就是说,只能得出这样的结论:手头的数据 不足以拒绝假设 分钟。换言之,该检验没有发现样本数据 与所规定的均值 之间存在不一致。检验的功效是指:在确实存在偏离 的情况下,把这种偏离检测出来的概率。在确认的语境中,检验的功效就是检测出一个无效模型的概率。功效也可以表示为 1 减去第二类错误(即 错误)的概率,其中 to reject $ H_{0} | H_{1}$ is true) 是在模型无效时把模型接受为有效的概率。
表 3 修改后银行模型六次重复的结果
| 重复 | (到达数/小时) | (分钟) | = 平均延误(分钟) |
|---|---|---|---|
| 1 | 51 | 1.07 | 5.37 |
| 2 | 40 | 1.11 | 1.98 |
| 3 | 45.5 | 1.06 | 5.29 |
| 4 | 50.5 | 1.09 | 3.82 |
| 5 | 53 | 1.08 | 6.74 |
| 6 | 49 | 1.08 | 5.49 |
| 样本均值 | 4.78 | ||
| 标准差 | 1.66 |
要使"不拒绝 “成为一个强结论,建模者会希望 很小。现在, 取决于样本量 n,以及 与 分钟之间的真实差异,也就是取决于
其中 (单个 的总体标准差)用 S 来估计。表 A.10 和表 A.11 是典型的操作特性(operating-characteristic, OC)曲线,它们是在给定样本量 n 的条件下,第二类错误概率 随 δ 变化的图形。表 A.10 用于双侧 t 检验,表 A.11 用于单侧 t 检验。假定建模者希望:如果模型的真实平均延误 与系统中的平均延误 分钟相差 1 分钟,则以至少 0.90 的概率拒绝 (模型有效性)。于是 δ 估计为
对于 的双侧检验,使用表 A.10 得到
为了保证 (这正是建模者所期望的),表 A.10 表明约需 次独立重复——也就是说,对于样本量 并假定总体标准差为 1.66 的情形,当模型确实无效($ | E ( Y_{2} ) - \mu_{0} | = 1 $ 分钟)时,接受 (模型有效性)的概率为 ,这一概率相当高。如果 1 分钟的差异是关键的,而且建模者希望控制这样的风险——即在模型预测偏差多达 1 分钟时仍宣称模型有效——那么就需要 次重复才能达到 0.9 的功效。如果这个样本量太高,那么就必须考虑要么接受更高的 风险(更低的功效),要么考察更大的差异 δ。
一般而言,控制第二类错误(即 β 错误)的最佳办法,始终是规定一个临界差异 δ,并借助适当的 OC 曲线来选择样本量。(关于各种检验的功效计算以及 OC 曲线的使用,参见 Hines、Montgomery、Goldsman 与 Borror [2002]。)总而言之,在模型确认的语境下,第一类错误是指拒绝一个有效模型,它很容易通过规定一个很小的显著性水平 α(例如 、 或 0.01)来加以控制。第二类错误是指在模型无效时把模型接受为有效。对于固定的样本量 n,增大 α 会减小 (第二类错误的概率)。一旦 α 设定、并选定要检测的临界差异,减小 的唯一办法就是增大样本量。第二类错误是这两类错误中更为严重的一种;因此,设计仿真实验以控制接受无效模型的风险就十分重要。这两类错误汇总于表 4,该表把统计学术语与建模术语作了对照。
请注意,确认不应当被视为非此即彼的命题,而应当在图 3 所概念地展示的模型校准语境下来看。如果银行模型当前版本所给出的平均延误 估计值与真实系统行为()不够接近,就要去找出差异的来源,并根据这一新认识修订模型。这一迭代方案不断重复,直到模型精度被认为足够为止。
表 4 模型确认中的错误类型
| 统计学术语 | 建模术语 | 相关风险 |
|---|---|---|
| 第一类:当 为真时拒绝 | 拒绝一个有效模型 | |
| 第二类:当 为真时不拒绝 | 未拒绝一个无效模型 |
从哲学上说,假设检验方法试图评价仿真与真实系统在某一项或某几项输出性能度量上是否相同。另一种不同但密切相关的方法,是试图用置信区间来评价仿真与真实系统性能度量是否足够接近。
我们继续假定:既有系统有一个已知的输出性能度量,记为 ,以及仿真的一个未知性能度量 ,我们希望它与之接近。假设检验的表述检验的是 ;置信区间的表述则试图界定差异 $ | \mu - \mu_{0} |$ 的界限,看它是否 ,即差异是否小到足以使基于仿真的决策有效。ε 的取值由分析人员确定。
具体地说,如果 是仿真输出且 ,那么我们执行仿真并构造 的一个置信区间,例如 。究竟应当把模型接受为有效,还是进一步改进模型,取决于该置信区间所隐含的最好情形误差与最坏情形误差。
假定该置信区间不包含 。[参见图 6(a)。]
(a) 如果最好情形误差 ,那么即使在最好情形下,性能差异也足够大,足以表明我们需要改进该仿真模型。
(b) 如果最坏情形误差 ,那么我们可以接受该仿真模型足够接近,因而可视为有效。
(c) 如果最好情形误差 ,但最坏情形误差 ,那么就需要增加仿真重复次数,以缩小置信区间,直到能够得出结论。
假定该置信区间包含 。[参见图 6(b)。]
(a) 如果最好情形误差或最坏情形误差 ,那么就需要增加仿真重复次数,以缩小置信区间,直到能够得出结论。
(b) 如果最坏情形误差 ,那么我们可以接受该仿真模型足够接近,因而可视为有效。
在例 2 中, 分钟,而"足够接近"取为 分钟的预期顾客延误。基于表 2 中 6 次重复的一个 95% 置信区间为
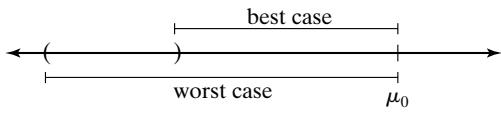
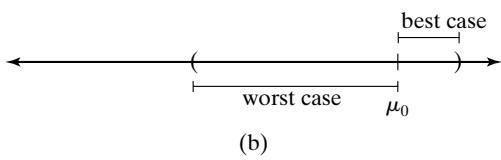
图 6 输入—输出变换的确认:(a) 已知值落在置信区间之外的情形;(b) 已知值落在置信区间之内的情形。
得到的区间为 [1.65, 3.37]。如图 6(a) 所示, 落在置信区间之外。由于最好情形下 $ | 3 . 37 - 4 . 3 | = 0 . 93 < 1 $,但最坏情形下 $ | 1 . 65 - 4 . 3 | = 2 . 65 > 1 $,因此需要增加重复次数才能作出决策。
3.4 输入—输出确认:使用历史输入数据
在使用人工生成的数据作为输入数据时——正如在第 3.3 节中检验银行模型有效性时所做的那样——建模者期望模型产生的事件模式与真实系统在数据收集期间所发生的事件模式相容,但并不完全相同。因此,在银行模型中,针对到达间隔时间和服务时间生成了人工输入数据 ,并用式 (1) 所述的假设检验把输出数据 的各次重复与真实系统中所观测到的结果作比较。生成输入数据的一种替代做法,是使用实际的历史记录 来驱动仿真模型,然后把模型输出与系统数据作比较。
要在银行模型中实施这一技术,就必须把数据 和 输入到模型中的数组,或存入文件以备需要时读取。就在顾客 n 于时刻 到达之后,顾客 n + 1 就被安排在未来事件列表上,将在未来时刻 到达(不生成任何随机数)。如果顾客 n 在时刻 开始接受服务,则把一次服务完成事件安排在时刻 发生。这种不生成随机数的事件调度,在通用编程语言或大多数仿真语言中,利用数组存储数据或从文件读取数据即可相当容易地实现。
使用这一技术时,建模者希望仿真能尽可能贴近地重现真实系统中发生的重要事件。在贾斯帕尔第五国民银行的模型中,到达时刻与服务时长将完全重现那个星期五上午 11:00 至下午 1:00 期间真实系统中实际发生的情况。如果模型足够准确,那么模型所预测的顾客延误、队长、服务台利用率和顾客离开时刻都将接近真实系统中实际发生的情况。当然,所需精度水平由模型构建者和模型使用者的判断来决定。
要利用历史输入数据开展确认检验,有一点很重要:所有输入数据 和所有系统响应数据(如平均延误 )都必须采集自同一个时间区间。否则,把模型响应与系统响应作比较(例如把模型中的平均延误 与系统中的平均延误 作比较)就可能产生误导。响应 和 既取决于输入 和 ,也取决于系统(或模型)的结构。由于需要同时收集所有输入变量以及那些主要关注的响应变量的数据,对大型系统实施这一技术可能是困难的。在有些系统中,人们会使用电子计数器和装置,通过自动记录某些类型的数据来减轻数据收集的任务。下面的例子基于 Carson 等 [1981a, b] 报告的两个仿真模型,在这两个模型中,同时数据收集与随后的确认都成功完成。
例 3:糖果工厂
位于迪凯特(Decatur)的 Sweet Lil’ Things 糖果工厂的生产线由三台机器组成,分别制造、包装和装盒其著名的糖果。第一台机器(制糖机)制造并包装单粒糖果,并用输送带把它们送往包装机。第二台机器(包装机)把单粒糖果装入盒中。第三台机器(制盒机)成型纸盒,并用输送带把它们送往包装机。系统如图 7 所示。
每台机器都会因卡料和其他原因发生随机故障。这些故障导致输送带开始变空或被装满。两台制造机器与包装机之间的输送带被用作在制品库存的临时存储缓冲器。除了随机发生的故障之外,如果糖果输送带变空,包装机的运行时间就会被打断,包装机保持空闲直到生产出更多糖果为止。如果盒子输送带因为制盒机的长时间随机故障而变空,则由操作员人工把一架子盒子放到包装机上。如果某条输送带被装满,相应的那台制造机器就会变为空闲。该模型的目的是考察:随着单机与输送带长度的各种组合,那些需要人工装上一架子盒子的操作员干预,其发生频率如何变化。不同机器有不同的生产速度和故障特性,较长的输送带可以容纳更多的在制品库存。目标是在最大化产量的同时,把操作员干预维持在可接受的水平上。机器停机(无论是由输送带装满还是变空引起)都会造成产品损坏,因此这也是生产中的一个影响因素。
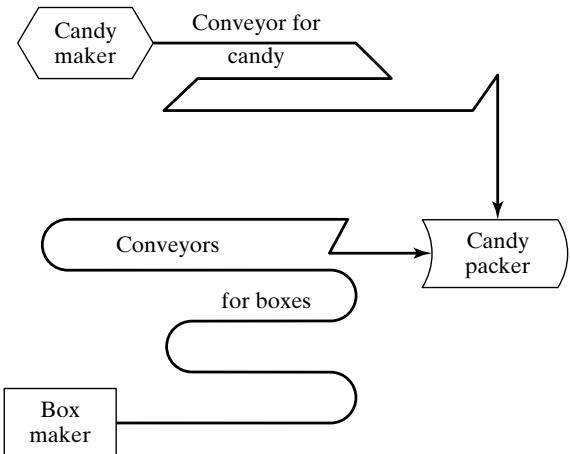
图 7 糖果工厂的生产线。
糖果工厂的仿真模型已经开发出来,并开展了使用历史输入的确认工作。糖果工厂的工程师们留出了上午 7:00 至上午 11:00 的 4 小时时段,用于收集一条既有生产线的数据。对每台机器——设机器为 i——收集了失效时间和停机时长 。对机器 , 是第 j 次运行时间(或失效时间), 是随后的停机时长。运行时间 可能因输送带装满或变空(视情况而定)而被打断,但在条件合适时会恢复。上午 7:00 的初始系统状况被记录下来,以便在模型中作为时刻 0 的初始状况予以复现。此外,还记录了主要的系统响应——生产水平 ,以及操作员干预的次数 和发生时刻 ——以便与模型预测作比较。
系统输入数据 和 被送入模型,用作运行时间和随机停机时间。模型的结构决定了因输送带装满或变空而发生停机的情形,也决定了操作员干预的发生。模型响应变量 被收集起来,以便与相应的系统响应变量 作比较。模型预测与系统实际表现之间的接近程度,大大帮助了工程人员说服管理层相信模型的有效性。这些结果如表 5 所示。像表 5 这样一份简单的对照表,在说服持怀疑态度的工程师和管理者相信模型有效性方面可能相当有效——也许比最精密的统计方法还要有效!
表 5 糖果工厂模型的确认
| 响应 i | 系统 | 模型 |
|---|---|---|
| 1. 生产水平 | 897,208 | 883,150 |
| 2. 操作员干预次数 | 3 | 3 |
| 3. 发生时刻 | 7:22, 8:41, 10:10 | 7:24, 8:42, 10:14 |
只有一组历史输入与输出数据时,只能得到一组仿真输出数据,因而无法进行基于汇总度量的简单统计检验。然而,如果收集了 K 组历史输入数据集,并且收集了某一系统响应变量 的 K 个观测值 ,使得输出度量 与第 j 组输入数据相对应,那么客观统计检验就成为可能。例如, 可以是在第 j 组输入数据收集期间所有接受服务的顾客的平均延误。有了这 K 组输入数据集,建模者现在把模型运行 K 次,每组输入数据运行一次,并观测到与 相对应的仿真结果 。继续以上面的例子, 就是模型为第 j 组输入数据所预测的平均延误。可供比较的数据如下表 6 所示。
表 6 相同历史输入下系统输出度量与模型输出度量的比较
| 输入数据集 | 系统输出 | 模型输出 | 观测差异 | 相对均值的平方偏差 |
|---|---|---|---|---|
| 1 | ||||
| 2 | ||||
| 3 | ||||
| . | . | . | . | . |
| . | . | . | . | . |
| . | . | . | . | . |
| K | ||||
如果这 K 组输入数据集是相当同质的,那么有理由认为 K 个观测差异 是同分布的。而且,如果这 K 组输入数据的收集在时间上是分开的——比如在不同日子——那么有理由认为 K 个差异 是统计独立的,因而这 K 个差异构成一个随机样本。在许多情形下,每个 和 都是对顾客的样本平均,因此(由中心极限定理)差异 近似服从均值为 、方差为 的正态分布。适当的统计检验于是就是针对"无均值差异"这一原假设的 t 检验:
以及备择假设"存在显著差异”:
恰当的检验是配对 t 检验( 与 配对,两者都由第一组输入数据产生,依此类推)。首先,用表 6 给出的公式计算样本平均差异 d¯ 和样本方差 。然后按下式计算 t 统计量
(其中 ,并从表 A.5 查得临界值 ,其中 α 是预先规定的显著性水平, 是自由度数目。若 $ | t_{0} | > t_{\alpha / 2 , K - 1} $,则拒绝"无均值差异"的假设 ,并得出模型不充分的结论。若 $ | t_{0} | \leq t_{\alpha / 2 , K - 1}$,则不拒绝 ,从而得出结论:该检验没有提供模型不充分的证据。
Sweet Lil’ Things 糖果工厂的工程师们决定扩展例 3 所报告的初步确认工作。他们安装了电子装置,用以自动监测其中一条生产线,并以 K = 5 组输入数据重复了例 3 的确认工作。系统与模型以生产水平为基准作比较,结果如表 7 所示。
进行了配对 t 检验以检验 ,等价地即检验 ,其中 是系统生产水平, 是仿真模型所预测的生产水平。取显著性水平 。利用表 7 中的结果,由式 (4) 给出检验统计量
由表 A.5,临界值为 。由于 $ | t_{0} | = 1 . 37 < t_{0 . 025 , 4} = $2.78,不能基于这一检验拒绝原假设——也就是说,就平均生产水平而言,系统响应与模型预测之间未发现不一致。如果 被拒绝,那么建模者就会本着图 3 的精神去寻找差异的原因并修订模型。
表 7 糖果工厂模型的确认(续)
| 输入数据集 j | 系统产量 | 模型产量 | 观测差异 | 相对均值的平方偏差 |
|---|---|---|---|---|
| 1 | 897,208 | 883,150 | 14,058 | |
| 2 | 629,126 | 630,550 | -1,424 | |
| 3 | 735,229 | 741,420 | -6,191 | |
| 4 | 797,263 | 788,230 | 9,033 | |
| 5 | 825,430 | 814,190 | 11,240 | |
3.5 输入—输出确认:使用图灵检验
除统计检验之外,或者在难以直接套用统计检验的情形下,还可以利用熟悉系统行为的人员来比较模型输出与系统输出。例如,假定准备了 5 份关于系统性能的报告(分别对应 5 个不同的日子),并用仿真输出数据生成 5 份"伪造"报告。这 10 份报告的格式应当完全相同,并且应当包含管理者和工程师此前在系统上见过的信息类型。这 10 份报告被随机打乱后交给那位工程师,请他判断哪些报告是伪造的、哪些是真实的。如果这位工程师识别出了相当数量的伪造报告,模型构建者就要向工程师询问情况,并利用所获得的信息改进模型。如果工程师无法有一致地区分出伪造报告与真实报告,建模者就会得出结论:该检验没有提供模型不充分的证据。关于进一步的讨论以及在一个真实仿真中的应用,读者可参阅 Schruben [1980]。这类确认检验通常称为图灵检验(Turing test)。随着模型开发的推进加以运用,它可以是发现模型缺陷、乃至在模型得到改进和精炼之后提高模型可信度的一件有价值的工具。
4 小结
仿真模型的确认极为重要。决策是基于仿真结果作出的,因此,这些结果的准确性应当成为质疑与考察的对象。
仿真在表面上常常显得很逼真,因为仿真模型与解析模型不同,它可以纳入关于真实系统的任何精细程度。为避免被这种表面逼真性所"迷惑",最好的做法是把系统数据与模型数据作比较,并且尽可能采用多种多样的技术(包括客观统计检验)来进行这种比较。
如 Van Horn [1969, 1971] 所讨论的,某些可供选用的确认技术,按成本—收益比递增的顺序排列如下:
通过向熟悉系统行为的人员咨询模型结构、模型输入和模型输出,开发具有高表面效度的模型。要利用一切已有的知识形式,包括以往的研究与调查、观察和经验。
对输入数据进行简单的统计检验,检验其同质性、随机性以及对所假定分布形式的拟合优度。
进行图灵检验。让熟悉情况的人员(工程师、管理者)比较模型输出与系统输出,力图发现其中的差别。
用统计检验把模型输出与系统输出作比较。
模型开发完成之后,收集新的系统数据,并重复第 2 至第 4 项技术。
按照仿真结果建造新系统(或重新设计旧系统),收集新系统的数据,并用这些数据来确认模型(若只采用这一项技术,则不推荐)。
几乎或完全不做确认。不经确认即实施仿真结果。(不推荐。)
对每一个所开发的模型而言,要把所有可能的确认技术都用上,通常都太困难、太昂贵或太耗时。从建模者的任务来看,选择那些最为合适的确认技术——既保证模型精度,又提升模型可信度——是一项重要的工作。
参考文献
BALCI, O. [1994], “Validation, Verification and Testing Techniques throughout the Life Cycle of a Simulation Study,” Annals of Operations Research, Vol. 53, pp. 121–174.
BALCI, O. [1998], “Verification, Validation, and Testing,” in Handbook of Simulation, J. Banks, ed., John Wiley, New York.
BALCI, O. [2003], “Verification, Validation, and Certification of Modeling and Simulation Applications,” in Proceedings of the 2003 Winter Simulation Conference, S. Chick, P. J. Sánchez, D. Ferrin, and D. J. Morrice, eds., New Orleans, LA, Dec. 7–10, pp. 150–158.
BALCI, O., AND R. G. SARGENT [1982a], “Some Examples of Simulation Model Validation Using Hypothesis Testing,” in Proceedings of the 1982 Winter Simulation Conference, H. J. Highland, Y. W. Chao, and O. S. Madrigal, eds., San Diego, CA, Dec. 6–8, pp. 620–629.
BALCI, O., AND R. G. SARGENT [1982b], “Validation of Multivariate Response Models Using Hotelling’s Two-Sample T^2 Test,” Simulation, Vol. 39, No. 6, pp. 185–192.
BALCI, O., AND R. G. SARGENT [1984a], “Validation of Simulation Models via Simultaneous Confidence Intervals,” American Journal of Mathematical Management Sciences, Vol. 4, Nos. 3 & 4, pp. 375–406.
BALCI, O., AND R. G. SARGENT [1984b], “A Bibliography on the Credibility Assessment and Validation of Simulation and Mathematical Models,” Simuletter, Vol. 15, No. 3, pp. 15–27.
BORTSCHELLER, B. J., AND E. T. SAULNIER [1992], “Model Reusability in a Graphical Simulation Package,” in Proceedings of the 24th Winter Simulation Conference, J. J. Swain, D. Goldsman, R. C. Crain, and J. R. Wilson, eds., Arlington, VA, Dec. 13–16, pp. 764–772.
CARSON, J. S. [1986], “Convincing Users of Model’s Validity is Challenging Aspect of Modeler’s Job,” Industrial Engineering, June, pp. 76–85.
CARSON, J. S. [2002], “Model Verification and Validation,” in Proceedings of the 34th Winter Simulation Conference, E. Yücesan, C.-H. Chen, J. L. Snowdon, and J. M. Charnes, eds., San Diego, Dec. 8–11, pp. 52–58.
CARSON, J. S., N. WILSON, D. CARROLL, AND C. H. WYSOWSKI [1981a], “A Discrete Simulation Model of a Cigarette Fabrication Process,” Proceedings of the Twelfth Modeling and Simulation Conference, University of Pittsburgh, PA, Apr. 30–May 1, pp. 683–689.
CARSON, J. S., N. WILSON, D. CARROLL, AND C. H. WYSOWSKI [1981b], “Simulation of a Filter Rod Manufacturing Process,” Proceedings of the 1981 Winter Simulation Conference, T. I. Oren, C. M. Delfosse, and C. M. Shub, eds., Atlanta, GA, Dec. 9–11, pp. 535–541.
GAFARIAN, A. V., AND J. E. WALSH [1970], “Methods for Statistical Validation of a Simulation Model of Freeway Traffic near an On-Ramp,” Transportation Research, Vol. 4, pp. 379–384.
GASS, S. I. [1983], “Decision-Aiding Models: Validation, Assessment, and Related Issues for Policy Analysis,” Operations Research, Vol. 31, No. 4, pp. 601–663.
HINES, W. W., D. C. MONTGOMERY, D. M. GOLDSMAN, AND C. M. BORROR [2002], Probability and Statistics in Engineering, 4th ed., Wiley, New York.
KLEIJNEN, J. P. C. [1987], Statistical Tools for Simulation Practitioners, Marcel Dekker, New York.
KLEIJNEN, J. P. C. [1993], “Simulation and Optimization in Production Planning: A Case Study,” Decision Support Systems, Vol. 9, pp. 269–280.
KLEIJNEN, J. P. C. [1995], “Theory and Methodology: Verification and Validation of Simulation Models,” European Journal of Operational Research, Vol. 82, No. 1, pp. 145–162.
LAW, A. M., AND W. D. KELTON [2000], Simulation Modeling and Analysis, 3d ed., McGraw-Hill, New York.
NAYLOR, T. H., AND J. M. FINGER [1967], “Verification of Computer Simulation Models,” Management Science, Vol. 2, pp. B92–B101.
OREN, T. [1981], “Concepts and Criteria to Assess Acceptability of Simulation Studies: A Frame of Reference,” Communications of the Association for Computing Machinery, Vol. 24, No. 4, pp. 180–189.
SARGENT, R. G. [2003], “Verification and Validation of Simulation Models,” in Proceedings of the 2003 Winter Simulation Conference, S. Chick, P. J. Sánchez, D. Ferrin, and D. J. Morrice, eds., New Orleans, LA, Dec. 7–10, pp. 37–48.
SCHECTER, M., AND R. C. LUCAS [1980], “Validating a Large Scale Simulation Model of Wilderness Recreation Travel,” Interfaces, Vol. 10, pp. 11–18.
SCHRUBEN, L. W. [1980], “Establishing the Credibility of Simulations,” Simulation, Vol. 34, pp. 101–105.
SHANNON, R. E. [1975], Systems Simulation: The Art and Science, Prentice-Hall, Englewood Cliffs, NJ.
VAN HORN, R. L. [1969], “Validation,” in The Design of Computer Simulation Experiments, T. H. Naylor, ed., pp. 232–235, Duke University Press, Durham, NC.
VAN HORN, R. L. [1971], “Validation of Simulation Results,” Management Science, Vol. 17, pp. 247–258.
YOUNGBLOOD, S. M. [1993], “Literature Review and Commentary on the Verification, Validation and Accreditation of Models,” in Proceedings of the 1993 Summer Computer Simulation Conference, J. Schoen, ed., Boston, MA, July 19–21, pp. 10–17.
习题
开发了一个作业车间(job shop)的仿真模型,用以研究不同的调度规则。为了确认该模型,把当前使用的调度规则并入模型,并把所得输出与观测到的系统行为作比较。通过查阅上一年的数据库记录,估计在某一天车间内的平均在制品(作业)数为 22.5。对模型作了 7 次独立重复,每次持续 30 天,车间内平均作业数的结果如下:
18.9 22.0 19.4 22.1 19.8 21.9 20.2
(a) 设计并实施一项统计检验,用以评价模型输出是否与系统行为一致。采用显著性水平 。
(b) 若把 2 个作业的差异视为关键差异,该检验的功效是多少?需要多大的样本量才能保证功效达到 0.8 或更高?(采用 。)
习题 1 中作业车间的系统数据表明,一个作业在车间内所花费的平均时间约为 4 个工作日。模型在 7 次独立重复中对车间内平均停留时间给出了如下预测:
3.70 4.21 4.35 4.13 3.83 4.32 4.05
(a) 模型输出与系统行为是否一致?采用显著性水平 进行统计检验。
(b) 如果检出 0.5 天的差异是重要的,则需要多大的样本量才能达到 0.90 的功效?请就模型的有效或无效来解释你的结果。(采用 。)
对于习题 1 的作业车间,在四个不同的 10 天时段内收集了四组输入数据,同时收集了每个时段车间内的平均作业数 。这些输入数据被用来驱动仿真模型,作四次各 10 天的运行,并收集到车间内平均作业数的模型预测值 ,结果如下:
| i | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 21.7 | 19.2 | 22.8 | 19.4 | |
| 24.6 | 21.1 | 19.7 | 24.9 |
(a) 进行一项统计检验,以核查系统输出与模型输出的一致性。采用显著性水平 。
(b) 若把 2 个作业的差异视为值得检出的重要差异,为保证在差异确实存在时至少有 0.80 的概率把它检出,需要多大的样本量?(采用 α = 0.05。)
获取参考文献中至少两篇论述确认与验证的论文或报告。写一篇短文,比较和对照关于验证与确认这一主题的各种理念与方法。
在文献中查找若干作者讨论了其模型确认的实际仿真实例。所给出的细节是否足以判断确认工作的充分性?如果是,请把所报告的确认工作与本章所提出的判据作比较。作者是否使用了本章未讨论的确认技术?[提示:关于仿真应用文章的若干潜在来源包括 Interfaces 和 Simulation 两刊,以及 www.informs-cs.org 上的冬季仿真会议论文集。]
比较和对照各种仿真软件包在帮助建模者完成调试与验证这一往往相当艰巨的任务方面的能力。[提示:讨论仿真软件包性质的论文可在 www.informs-cs.org 上的冬季仿真会议论文集中找到。]
(a) 把仿真中的确认与物理科学中理论的确认作比较。
(b) 比较物理系统模型的确认与社会系统模型的确认各自涉及的问题和可用的技术。
(c) 对照在确认一个使用叉车和其他人工操作车辆的仓库模型时,与确认一个配备自动导引车、输送带和自动存取系统的设施模型时,各自面临的困难并比较其技术。
(d) 对一个涉及大量人工作业和人工决策的生产系统模型,与该生产系统在实现自动化之后的模型,重复 (c)。
使用置信区间方法,利用表 3 中的输出数据评价例 2 中修改后银行模型的有效性。