11 绝对性能估计
输出分析(output analysis)是对仿真所生成数据的考察。其目的要么是预测某一系统的性能,要么是比较两个或多个备选系统设计的性能。本章讨论绝对性能(absolute performance)的估计,所谓绝对性能是指估计一个或多个系统性能度量的取值,而不是对两个或多个系统作比较——换言之,不是相对性能(relative performance)。
之所以需要统计输出分析,是基于如下观察:当使用随机数发生器生成输入变量的取值时,仿真的输出数据会表现出随机变异性——也就是说,两条不同的随机数流或随机数序列会产生两组输出,而这两组输出(很可能)彼此不同。如果用参数 来度量系统的性能,那么一组仿真实验的结果将是 θ 的一个估计量 。估计量 的精度可以用 的标准误来度量,也可以用 θ 的置信区间(confidence interval)的宽度来度量。统计分析的目的,要么是估计这一标准误或置信区间,要么是弄清楚需要多少次观察才能获得给定大小的标准误或置信区间——或者两者兼而有之。
考虑一个典型的输出变量 Y,即某库存系统每周的总成本;Y 应当被视为一个分布未知的随机变量。一段长度为 1 周的仿真运行,提供了对 Y 的所有可能观察值所构成总体的一次单样本观察。通过延长运行长度,样本量可以增加到 n 个观察值 , 这对应于 n 周的运行长度。然而,这些观察值并不构成经典意义上的随机样本,因为它们在统计上并不独立。在本例中,一周结束时的在手库存就是下一周开始时的在手库存,因此 的取值会对 的取值产生某种影响。于是,随机变量序列 可能是自相关的(autocorrelated,即与自身相关)。这种自相关是统计独立性缺失的一种度量,它意味着以独立性为前提的经典统计方法不能直接用于这些输出数据的分析。必须对这些方法作恰当的修正,并且必须对仿真实验作恰当的设计,才能作出有效的推断。
除了大多数仿真输出数据中存在的自相关之外,在时间 0 对系统初始条件的规定也会给仿真分析人员带来问题,并可能影响输出数据。所谓"时间 ",指的是仿真运行起点所代表的任一时刻。例如,时间 0(星期一早晨)的在手库存量和缺货(backorder)数量很可能会影响 的取值,即第 1 周的总成本。由于自相关的存在,这些初始条件也会影响随后各周的成本 。若初始条件选择不当,就会对仿真模型稳态(steady-state,即长期运行)性能的估计产生影响。就统计分析而言,初始条件的影响表现在:输出观察值可能不是同分布的,并且初始的若干观察值可能不能代表系统的稳态行为。
第 1 节区分两类仿真——暂态(transient)仿真与稳态(steady-state)仿真——并就每一类仿真定义常用的系统性能度量。第 2 节用例子说明随机(即概率性)离散事件仿真中固有的变异性,从而说明对输出作统计分析的必要性。第 3 节讨论性能度量的统计估计。第 4 节讨论终止型仿真的分析,第 5 节讨论稳态仿真的分析。为支持本章的计算,www.bcnn.net 上提供了一个名为 SimulationTools.xls 的电子表格。SimulationTools.xls 是一个菜单驱动的应用程序,允许用户粘贴自己的数据——由任意仿真应用所生成的——并对其执行统计分析。书籍网站上也提供了详细的用户指南,且 SimulationTools.xls 带有集成的帮助功能。
1 按输出分析划分的仿真类型
在分析仿真输出数据时,要区分终止型(terminating)或暂态仿真与稳态仿真。
终止型仿真(terminating simulation)是这样一种仿真:它运行一段持续时间 ,其中 E 是使仿真停止的指定事件(或事件集)。这样被仿真的系统在时间 0 于明确规定的初始条件下"开门营业",并在停止时刻 “关门歇业”。下面四个例子都是终止型仿真。
例 1
Shady Grove 银行于上午 8:30(时间 0)开门,此时没有顾客在场,11 名柜员中有 8 名在工作(初始条件),并于下午 4:30(时间 分钟)关门。这里,事件 E 仅仅是银行已经营业 480 分钟这一事实。仿真分析人员希望对顾客与柜员之间在整个营业日内的交互作用建模,包括开门启动和临近下班收尾的影响。
例 2
考虑例 1 中的 Shady Grove 银行,但只关注上午 11:30(时间 0)到下午 1:30 这一特别繁忙的时段。仿真运行长度为 分钟。时间 0(上午 11:30)的初始条件基本上可以用两种方式来规定:(a) 在若干不同日子的上午 11:30 观察真实系统,估计(上午 11:30 时)系统中顾客人数的分布,然后利用这些数据在时间 0 为仿真模型装入顾客;或者 (b) 从上午 8:30 到上午 11:30 对模型进行仿真而不收集输出统计量,并把上午 11:30 的结束条件用作上午 11:30 至下午 1:30 仿真的初始条件。
例 3
某通信系统由若干部件以及若干备份部件组成,其示意图见图 1。考虑该系统在一段时间 , 之内、直到系统失效为止的运行情况。停止事件 E 定义为 失效,或 D 失效,或(B 与 C 二者均失效)。初始条件是:所有部件在时间 0 都是新的。
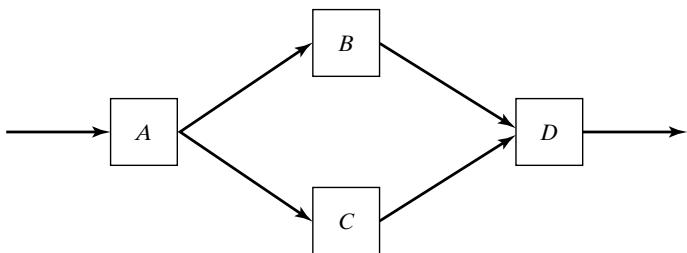
图 1 通信系统示例。
注意,在例 1 的银行模型中,停止时刻 分钟是已知的;但在例 3 中,停止时刻 一般是事先无法预测的。事实上, 很可能就是人们所关注的输出变量,因为它代表了直到系统崩溃为止的总时间。该仿真的一个目标可能是估计 , 即系统失效前的平均时间。
例 4
某制造过程从星期一早晨一直连续运行到星期六早晨。每个工作周的第一个班次用来向库存缓冲区和化学罐中装入生产最终产品所需的组分和催化剂。除星期五夜间的最后一个班次用于清理和维护之外,这些组分和催化剂在一周当中被持续不断地生产出来。因此,到一周结束时,大多数库存缓冲区都接近于空。在星期一的第一个班次,会建立起缓冲库存,以防过程中某个环节发生故障。现在希望对该系统在第一班次(时间 0 到时间 小时)内的运行作仿真,以研究装载库存缓冲区的各种调度策略。
在对一个终止型系统作仿真时,必须规定系统在时间 0 的初始条件,并且必须明确定义停止时刻 (或者等价地)停止事件 E。尽管例 1 中的 Shady Grove 银行第二天当然还会开门,但仿真分析人员选择把它当作一个终止型系统来处理,因为所关注的对象是一天的运营,包括启动与收尾。另一方面,如果仿真分析人员关心的是银行运营的另一些方面,例如资金流或自动柜员机的运行,那么该系统就可能被看作一个非终止型(nonterminating)系统。类似的说明也适用于例 3 的通信系统。如果失效的部件被更换、系统继续运行,并且最重要的是,如果仿真分析人员关心的是研究它的长期行为,那么它就可能被看作一个非终止型系统。然而在例 3 中,人们关心的是它的短期行为,即从时间 0 到首次系统失效的时刻 。因此,一个仿真是否被视为终止型,既取决于仿真研究的目标,也取决于系统本身的性质。
例 4 也是一个终止型系统。它同时还是一个暂态(transient,或非平稳 nonstationary)仿真的例子:所关注的变量是在制品库存水平,它从零或接近零(时间 0)增长到满或接近满(时间 8 小时)。
非终止型系统是指持续运行、或至少运行非常长一段时间的系统。例子包括很少停机的装配线、多种不同类型的连续生产系统、电话以及诸如互联网之类的其他通信系统、医院急诊室、警务调度与巡逻作业、消防部门,以及持续运行的计算机网络。
对一个非终止型系统所作的仿真,在仿真时间 0 于分析人员所定义的初始条件下启动,并运行分析人员指定的一段时间 。(关于这些初始条件和停止条件的规定会产生一些重大问题,这些问题我们将在后面讨论。)通常,分析人员希望研究系统的稳态即长期性质——也就是说,不受模型在时间 0 的初始条件所影响的那些性质。稳态仿真(steady-state simulation)就是以研究非终止型系统的长期或稳态行为为目标的仿真。
下面两个例子是稳态仿真。
例 5
考虑例 4 中的制造过程,但从第二个班次开始,此时完整的生产过程已经全面展开。希望估计长期的生产水平和生产效率。对于 13 个班次这一相对较长的时期,可以把它看作一次稳态仿真。为了获得足够精确的生产效率估计值以及其他响应变量的估计值,分析人员可以决定仿真任意长的时间 (甚至长于 13 个班次)。也就是说, 不是由问题的性质决定的(这与终止型仿真不同);相反,它是由分析人员设定的,是仿真实验设计中的一个参数。
例 6
HAL 公司是一家大型的基于 Web 的订单处理公司,在世界各地拥有众多客户。因此,它那由许多服务器、工作站和外设组成的大型计算机系统每天 24 小时持续运行。为了应对增加的工作负载,HAL 正在考虑以各种配置增加 CPU、内存和存储设备。尽管 HAL 计算机上的负载在一天当中不断变化,管理层希望系统能够承受持续出现的峰值负载期。此外,HAL 的业务发生任何实质性变化的时间框架是未知的,因此不存在固定的规划期。于是,在峰值负载条件下作稳态仿真是恰当的。HAL 的系统人员针对现有系统在当前峰值工作负载下建立了一个仿真模型,然后探索扩容的若干可能方案。HAL 关心的是每台计算机的长期平均吞吐量和利用率。停止时刻 不是由问题的性质决定的,而是由仿真分析人员决定的,要么是任意选定的,要么是心中带着某种统计精度来选定的。
2 输出数据的随机性质
考虑仿真模型在一段时间 T_{E} ]$ 上的一次运行。由于模型是一个输入—输出变换,并且由于模型的某些输入变量是随机变量,因此模型的输出变量也是随机变量。下面给出两个例子,用以说明随机仿真的输出数据的性质,并对这些数据的若干重要性状作初步讨论。如果初次阅读时其中某些性状和相关术语还不十分清楚,也不必担心;本章后面会仔细加以解释。
例 7:Software Made Personal
Software Made Personal(SMP)公司在两个领域为客户定制软件产品:财务跟踪和联系人管理。他们设有一个客户支持呼叫中心,在东部时间上午 8 点到下午 4 点之间处理其软件用户提出的问题。客户来电后,使用一个自动系统在两条产品线中进行选择。每条产品线都有自己的话务员,如果有合适的话务员空闲,来电就被立即转接给该话务员;否则,来电者被放入等待(hold)队列。SMP 希望通过对话务员作交叉培训,使他们能够接听任意产品线的来电,从而减少所需话务员的总数。预计这会使处理一次来电的时间增加约 10%。不过,在考虑裁减话务员之前,SMP 想知道:如果只是对现有话务员作交叉培训,其服务质量会如何。利用历史数据,来话被建模为一个非平稳泊松到达过程,并且已为话务员解答问题的时间拟合了分布。他们的服务质量度量是来电者响应时间(response time,从发起呼叫到与话务员通话的时间)以及等待中的来电者人数。超过 30 秒的响应时间差异才是重要的。
这显然是一个终止型仿真实验,时间 0 对应上午 8 点, 对应下午 4 点(另一种终止仿真的方式是:等到下午 4 点之前到达的最后一个呼叫结束时终止,此时 是一个随机值)。表 1 给出了 SMP 仿真 4 次重复实验的结果;每一行给出在一次仿真的 8 小时工作日中,来电者等待的平均分钟数以及等待的平均来电者人数。
表 1 SMP 呼叫中心四次独立重复实验的结果
| 重复实验 r | 平均等待时间 (分钟) | 平均等待人数 (人) |
|---|---|---|
| 1 | 0.88 | 0.68 |
| 2 | 5.04 | 4.18 |
| 3 | 4.13 | 3.26 |
| 4 | 0.52 | 0.34 |
该表说明,这些平均值在不同日之间存在着显著变异,这意味着可能需要相当多次的重复实验,才能精确地估计诸如均值 和 。即便重复实验次数很多,仍然会存在一定的估计误差,这正是我们不仅要报告一个单一数值(点估计),还要以置信区间或标准误的形式报告其误差度量的原因。
这些问题在第 4 节中针对例 7 这类终止型仿真加以讨论。可以使用经典统计方法,因为 和 构成一个随机样本——也就是说,它们是独立同分布的。此外, 就是待估计的参数,因此每个 都是真实平均等待时间 的无偏估计。例 7 的分析放在第 4 节的例 10 中讨论。适用于终止型仿真的统计方法综述由 Law [1980] 给出。更多的指导可见 Alexopoulos 与 Seila [1998]、Kleijnen [1987]、Law [2007] 以及 Nelson [2001]。
下一个例子说明相关性与初始条件对系统长期平均性能度量估计的影响。
例 8
半导体晶圆制造是一个极其昂贵的过程,涉及数亿美元的加工设备、物料搬运和人力资源。FastChip 公司希望用仿真来设计一座新的"晶圆厂"(fab),方法是评估在两种不同产品(称为 C 芯片和 D 芯片)的某种特定投料下所能期望的稳态平均周期时间(cycle time,从晶圆投料到完工的时间)。晶圆制造过程由扩散和光刻两个基本步骤组成,每一步又包含许多子步骤,并且制造过程需要多轮次地经历这些步骤。产品以片盒(cassette)为单位、按每小时 1 个片盒的速率投料,每周 7 天、每天 24 小时,以达到每小时 1 个片盒的期望吞吐量。希望当前设计能使 C 芯片的长期平均周期时间小于 45 小时,D 芯片小于 30 小时。
图 2 给出了该晶圆厂仿真模型一次运行所得到的前 30 个 C 芯片周期时间。目标是估计长期平均周期时间,从概念上讲,就是所生产片盒数趋于无穷时的平均周期时间。注意,最初几个周期时间看起来低于其后的那些;出现这种情况,是因为仿真启动时晶圆厂处于"空且空闲"(empty and idle)状态,而这并不代表长期或稳态条件。还要注意,当出现一个较低的周期时间(比如 40 小时左右)时,其后往往跟着几个额外的低周期时间。因此,相继片盒的周期时间可能是相关的。这些特征表明,周期时间数据不是一个随机样本,因此经典统计方法可能并不适用。例 8 的分析放在第 5 节讨论。
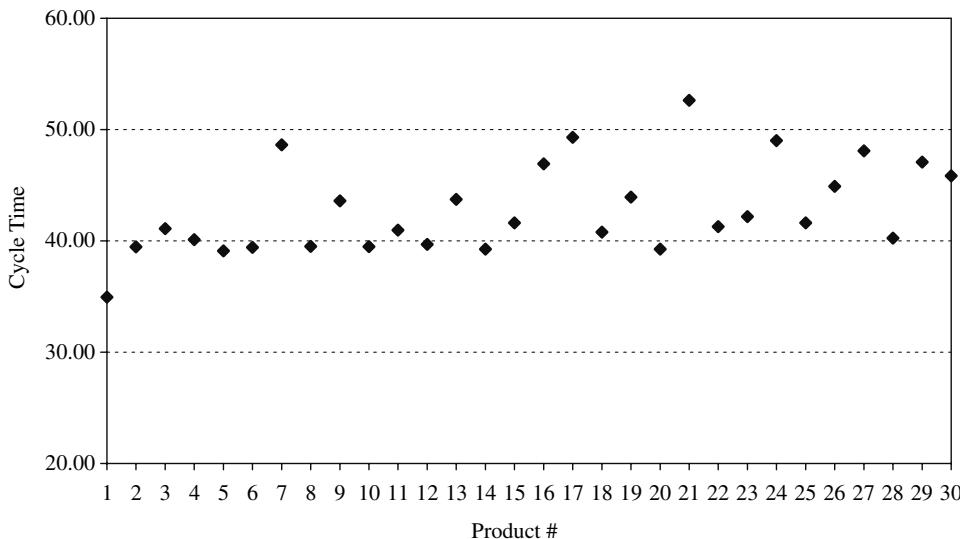
图 2 一次仿真运行的前 30 个 C 芯片周期时间。
3 绝对性能度量及其估计
考虑对被仿真系统的某个性能参数 θ(或 φ)的估计。希望得到 θ(或 φ)的点估计和区间估计。区间估计的长度是点估计误差的一种度量。用于估计 的仿真输出数据具有 的形式,我们把这类输出数据称为离散时间数据(discrete-time data),因为指标 n 取离散值。用于估计 φ 的仿真输出数据具有 的形式,我们把这类输出数据称为连续时间数据(continuous-time data),因为指标 t 取连续值。例如, 可以是顾客 i 的延误,或第 周的总成本; 可以是时刻 t 的队长,或时刻 t 的欠交订单数。参数 是一个普通均值(ordinary mean); 则被称为时间加权均值(time-weighted mean)。我们把性能参数称作 还是 其实无关紧要;这里使用两个不同的符号,只是为了区分普通均值与时间加权均值。为了使讨论更具体,我们考虑排队系统的输出度量。
3.1 点估计
基于数据 的 θ 的点估计量定义为
其中 是基于样本量为 n 的样本的样本均值。计算机仿真语言可能称之为"离散时间"(discrete-time)、“收集”(collect)、“计数”(tally)或"观察"(observational)统计量。
称点估计量 θ 对 θ 是无偏的(unbiased),如果它的期望值等于 即如果
然而一般地,
并且 称为点估计量 中的偏差(bias)。我们希望估计量是无偏的,如果做不到这一点,则希望相对于 θ 的量级而言偏差较小。形如式 (1) 的估计量的例子包括 与 ,其表达式为 和 ,当 时成立,此时 是顾客 i 在(子)系统中度过的那段时间。基于数据 、其中 为仿真运行长度的 φ 的点估计量定义为
并称为 在 上的时间平均。仿真语言可能称之为"连续时间"(continuous-time)、“离散变化”(discrete-change)或"时间持续"(time-persistent)统计量。一般地,
并且称 对 φ 是有偏的。同样,我们希望得到无偏估计量或低偏差估计量。时间平均的例子包括式 (当 时)中的 和式 (当 时)中的 ,以及式 (11.4) 中的 。
一般地,θ 和 φ 被视为被仿真系统的均值类性能度量。其他度量通常也可以纳入这一共同框架。例如,考虑估计因缺货而损失销售的天数所占的比例。在仿真中,令
当 n 等于总天数时,由式 (1) 所定义的 就是 即缺货天数比例的点估计量。第二个例子,考虑估计队长大于 10 名顾客的时间所占的比例。如果 表示仿真中时刻 的队长,那么(在仿真中)定义
于是由式 (4) 所定义的 就是 , 即队长大于 10 名顾客的时间比例的点估计量。因此,比例或概率的估计是均值估计的一个特例。
有一类性能度量不属于这一共同框架,那就是分位数(quantile)或百分位数(percentile)。分位数描述的是能够以给定概率 交付的性能水平。例如,设 Y 表示服务系统中顾客所经历的排队延误,以分钟计。那么 Y 的 分位数就是满足下式的 θ 值:
用百分比表示, 就是顾客延误的第 100p 百分位数,即第 85 百分位数。因此,85% 的顾客将经历不超过 θ 分钟的延误。换一种说法,一位顾客经历超过 θ 分钟延误的概率只有 0.15。一种被广泛使用的性能度量是中位数(median),即 0.5 分位数或第 50 百分位数。
分位数估计问题是比例或概率估计问题的逆问题。在估计比例时,给定 θ 而要估计概率 ;然而在估计分位数时,给定 而要估计 θ。
估计分位数最直观的方法是:作出 Y 的观察值的直方图,然后找出一个值 , 使得直方图的 100p% 位于 的左侧(即小于它)。例如,如果我们观察 个顾客延误 -, 那么延误的第 85 百分位数的一个估计值就是这样一个 :使得 个观察值小于或等于 - 因此,一个显然的估计是令 等于样本中第 213 小的值(这需要对数据排序)。当输出是一个连续时间过程时,例如队长过程 ,直方图给出该过程在每一个可能水平(本例中即队长)上所度过的时间比例。不过,分位数估计的方法保持不变:找出一个值 , 使得直方图的 100p% 位于 的左侧。
3.2 置信区间估计
要充分理解置信区间,重要的是理解误差度量与风险度量之间的区别。弄清这一区别的一种方法,是把置信区间与预测区间(prediction interval,另一种有用的输出分析工具)加以对照。
置信区间与预测区间都以如下前提为基础:仿真所产生的数据能够用一个概率模型很好地表示。假设该模型是均值为 θ、方差为 的正态分布,两者均未知。为使例子具体化,令 为第 i 次重复实验(代表一个生产日)中所生产零件的平均周期时间。于是, 是 的数学期望,而 σ 表示平均周期时间的日间变异。
假设我们的目标是估计 θ。如果我们打算长期经营,日复一日地生产零件,那么 就是一个有意义的参数,因为它是长期的日平均周期时间。我们的平均周期时间会随日子不同而变化,但从长期看,这些平均值的平均值会接近 θ。
θ 的自然估计量是 n 次独立重复实验的总样本均值 。但 并不等于 θ,它是一个基于样本的估计,并且带有误差。置信区间就是这一误差的度量。令
为 R 次重复实验之间的样本方差。假定 服从正态分布的通常置信区间为
其中 是自由度为 的 t 分布的分位数,它使得每个尾部截去 的面积。(见附录表 A.5。)我们无法确切知道 距离 θ 到底有多远,但置信区间试图为这一误差定界。遗憾的是,置信区间本身也可能是错的。诸如 95% 这样的置信水平告诉我们,该区间真正为 Y¯ 与 θ 之间的误差定界的把握有多大。我们作的重复实验越多, 中的误差就越小,而我们的置信区间也反映了这一点,因为 会随着 n 的增大而变小,并在 n 趋于无穷时收敛到 0。
现在假设我们需要对某一天的平均周期时间作出承诺。一个好的猜测值是我们的估计量 , 但它不太可能恰好正确。即便是 θ 本身——分布的中心——也不太可能恰好是某一天的实际平均周期时间,因为日平均周期时间是变动的。而预测区间则被设计得足够宽,能够以很高的概率包含任意某一天的实际平均周期时间。
基于正态理论的预测区间为
该区间的长度不会随着 n 的增大而趋于 0。事实上,在极限情形下它变为
这反映了如下事实:无论我们仿真多少次,我们的日平均周期时间仍然是变动的。
总之,预测区间是风险的度量,而置信区间是误差的度量。我们可以通过作越来越多的重复实验来"仿真掉"误差,但我们永远无法"仿真掉"风险,因为风险是系统所固有的。不过,我们确实可以通过作更多次重复实验来更好地评估风险。
例 9
假设某制造仿真在 120 次重复实验上所得的平均周期时间的总平均为 5.80 小时,样本标准差为 1.60 小时。由于 , 长期期望日平均周期时间的 95% 置信区间为 ,即 小时。因此,我们对日平均周期时间的长期平均值的最佳猜测是 5.80 小时,但这一估计中可能有多达 0.29 小时的误差。
对任意某一天,我们有 95% 的把握认为当天生产的所有零件的平均周期时间将为
即 小时。3.18 小时反映了日平均周期时间中固有的变异性,以及这样一个事实:我们希望以 95% 的把握覆盖某一天的实际平均周期时间,而不仅仅是覆盖长期平均值。
一点告诫:无论在哪一种情形下(预测区间还是置信区间),我们都不能对单个产品的周期时间作出论断,因为我们观察的是日平均值。要对单个产品的周期时间作出有效的论断,分析必须以单个周期时间为基础。
4 终止型仿真的输出分析
考虑在仿真时间区间 上运行、并产生观察值 的一次终止型仿真。样本量 n 可以是一个固定的数,也可以是一个随机变量(例如,在时间 内发生的观察次数)。仿真中的一个常见目标是估计
当输出数据具有 的形式时,目标是估计
两种情形下所使用的方法都是独立重复实验(independent replications)法。仿真被重复共 R 次,每次运行使用不同的随机数流和独立选择的初始条件(这也包括所有运行具有相同初始条件的情形)。下面我们就来讨论这一问题。
4.1 统计背景
仿真输出分析中最令人困惑的方面,大概就是区分重复实验内(within-replication)数据与重复实验间(across-replication)数据,并理解各自的性质与用途。而仿真语言往往只提供汇总度量——如样本均值、样本方差和置信区间——而不是全部原始数据,这一事实会使问题更加混乱。有时候,这些汇总度量就是仿真语言所能提供的全部,除非额外做大量工作。
为说明关键思想,设想对一个制造系统作仿真,并考虑该系统的两个性能度量:零件的周期时间(从投料进入工厂到完工的时间)和在制品(WIP,任一时刻工厂中零件的总数)。在计算机应用中,这两个度量可以对应于响应时间和 CPU 处任务队列的长度;在服务应用中,它们可以是满足一位顾客请求所需的时间和"待办"清单上的请求数;在供应链应用中,它们可以是订单履行时间和库存水平。类似的度量出现在许多系统中。
对于周期时间这类指标,通常的设定如下:令 为第 i 次重复实验中生产的第 j 个零件的周期时间。如果每次重复实验代表两个班次的生产,那么每次重复实验中生产的零件数可能不同。表 2 以符号方式给出了 R 次重复实验的结果。
表 2 重复实验内与重复实验间的周期时间数据
| 重复实验内数据 | 重复实验间数据 | |||
|---|---|---|---|---|
重复实验间数据是通过汇总重复实验内数据而形成的:^1 是第 i 次重复实验中 个周期时间的样本均值, 是同一批数据的样本方差,而
是基于该数据集的置信区间半宽(half-width)。
由重复实验间数据,我们计算总体统计量:日平均周期时间平均值的均值
日平均周期时间平均值的样本方差
以及最后的置信区间半宽
量 是标准误,它有时被解释为 作为 θ 的估计量时的平均误差。注意, 并不是重复实验内样本方差 的平均;相反,它是重复实验内平均值 的样本方差。
表 3 重复实验内与重复实验间的在制品数据
| 重复实验内数据 | 重复实验间数据 |
|---|---|
在一次重复实验内部,在制品是一个连续时间输出,记为 。第 i 次重复实验的停止时刻 一般地可以是一个随机变量;在本例中,它是第二个班次的结束时刻。表 3 是所产生数据的一个抽象表示。
对于连续时间数据,重复实验内的样本均值与方差有相应的定义:
以及
的定义则更成问题,但为具体起见,取它为
很难设想出 派得上用场的情形,这一点我们后面再讨论。尽管对于连续时间数据,重复实验内数据的定义发生了变化,但重复实验间的统计量并不改变,这是一个关键性的观察。
以下是必须理解的几个要点:
总样本平均 与单次重复实验的样本平均 总是期望日平均周期时间或日期望在制品数量的无偏估计量。
重复实验间数据是独立的,因为它们基于不同的随机数;是同分布的,因为我们在每次重复实验上运行同一个模型;并且往往近似服从正态分布,如果它们是重复实验内数据的平均值(此处正是如此)。这意味着置信区间 通常相当不错。
另一方面,重复实验内数据可能完全不具备这些性质。各个周期时间可能不是同分布的,如果一天当中最初几个零件到达时系统是空的;它们几乎肯定不是独立的,因为一个零件紧接着另一个零件;而且它们是否服从正态分布事先很难知道。由于这个原因,在独立同分布 数据假定下计算出来的 和 往往没有用处,尽管也有例外。
在某些情形下,Y¯ 和 是单个零件期望周期时间或任意时刻期望在制品数量的有效估计量,而不是日平均值的有效估计量。(见关于稳态仿真的第 5 节。)即便如此,置信区间 是有效的,而 却不是。困难的产生是因为 是周期时间方差的一个合理估计量,但 和 却不是 的良好估计量,关于这一点详见第 5.2 节。
例 10:Software Made Personal(续)
考虑例 7 的 SMP 呼叫中心问题,其 次重复实验的数据见表 1。四个等待人数估计值 是形如式 (11) 的时间平均,其中 -, 即时刻 t 等待的顾客数。类似地,四个平均系统时间 类似于表 2 中的 ,其中 是第 次重复实验中顾客 i 实际等待的时间。假设分析人员想要得到等待时间均值 的 95% 置信区间。利用式 (8),计算总点估计量
利用式 (9),计算其估计方差:
于是, 的标准误估计为 。由表 A.5 查得 - -3.18,并由式 (10) 计算 95% 置信区间半宽为
从而以 95% 的置信度得到 分钟。显然,4 次重复实验远远不足以对 作出任何有用的估计,因为平均等待时间为负是不可能的。本章后面我们还会回到这一问题,并确定需要多少次重复实验才能得到有意义的估计。
4.2 具有指定精度的置信区间
由式 (10),基于 t 分布的均值 θ 的 置信区间的半长 H 由下式给出:
其中 是样本方差,R 是重复实验次数。在仿真中,我们很少只是选定 R 然后就接受由此得到的置信区间半长。相反,我们可以把重复实验次数推得足够大,使 H 小到足以支持仿真本应支撑的决策。H 的可接受大小取决于手头的问题:在金融仿真中它可能是 5000 美元,对产品周期时间可能是 6 分钟,在呼叫中心可能是 1 位等待的顾客。
假设规定了一个误差准则 ,换言之,希望以 估计 θ 到 以内,且具有很高的概率——比如说至少 。于是,希望取足够大的样本量 R,使得
当样本量 R 固定时,无法对所产生的误差给出任何保证。但如果样本量可以增加,就可以规定一个误差准则(例如 、6 分钟或 1 位顾客)。
假定已经观察到规模为 次重复实验的初始样本——也就是说,仿真分析人员首先作了 次独立重复实验。必须有 ,而 10 次或更多则是较为理想的。这 次重复实验将用于获得总体方差 的一个初始估计 。为了满足半长准则,必须选择样本量 R,使得 且
就不等式 (14) 解出 R 可知,R 是满足 和
的最小整数。R 的一个初始估计由下式给出:
其中 是标准正态分布的 百分位点,取自附录表 A.3。并且由于当 R 较大时(比如 )有 ,因此在 R 较大时,关于 R 的第二个不等式是足够好的。在确定了最终样本量 R 之后,收集 个追加观察值(即再作 次追加重复实验,或者从头开始共作 R 次重复实验),并由下式构造 θ 的 置信区间:
其中 和 是依据全部 R 次重复实验计算的, 按式 (8) 计算, 按式 (9) 计算。由不等式 (17) 给出的置信区间半长应当近似等于 或更小;然而,随着追加了 个观察值,方差估计量 可能与初始估计 有某种差异,从而可能导致半长大于所期望的值。如果由不等式 (17) 得到的置信区间过大,则可以重复上述过程,利用不等式 (15) 确定一个更大的样本量。
例 11
假设希望以 95% 的置信度把例 7 中 SMP 等待队列的平均等待时间估计到 0.5 分钟以内。我们将用 SimulationTools.xls 的"获取样本量(Get Sample “工具来演示这一计算。输入对话框如图 3 所示,结果如图 4 所示。注意,“绝对精度(Absolute Precision)“是指直接指定置信区间的半宽(本例中为 0.5 分钟);“相对精度(Relative Precision)“则把半宽的长度指定为均值的某个比例。
取规模为 的初始样本,程序确定 是满足不等式 (16) 的最小整数。因此,还需要 次追加重复实验。在获得追加的输出之后,我们还需要再次计算半宽 H,以确保它小到所期望的程度。本例中的结果(也可在 www.bcnn.net 上找到)为 分钟。
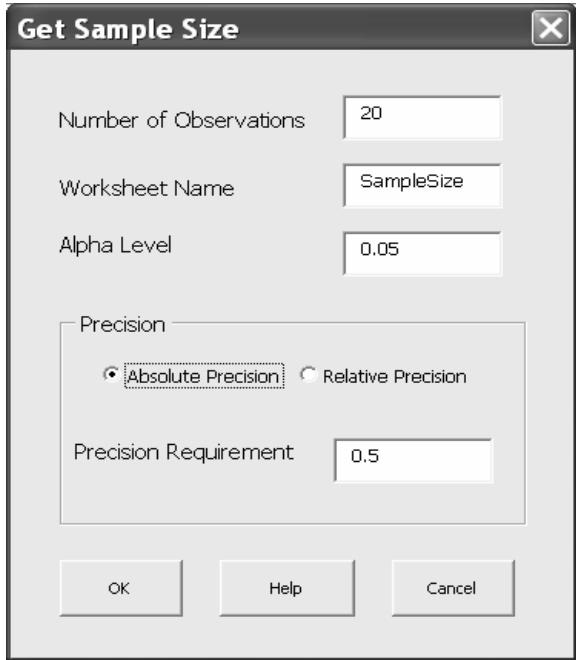
图 3 SimulationTools.xls 中"获取样本量"工具的输入对话框。
| 获取样本量 | 已完成 | 数据列 | 最小样本量 | ||||
|---|---|---|---|---|---|---|---|
| 1 | 0.880897931 | 175 | |||||
| 观察值个数 | 20 | 2 | 5.04340304 | ||||
| Alpha | 0.05 | 3 | 4.132638545 | ||||
| 精度类型 | 1 | 4 | 0.517418075 | ||||
| 精度值 | 0.5 | 5 | 2.584490259 | ||||
| 6 | 0.860547939 | ||||||
| 7 | 1.544612493 | ||||||
| 8 | 1.762676832 | ||||||
| 9 | 6.925242515 | ||||||
| 10 | 2.201491896 | ||||||
| 11 | 2.915438392 | ||||||
| 12 | 0.486246064 | ||||||
| 13 | 1.792947434 | ||||||
| 14 | 1.244455641 | ||||||
| 15 | 4.278579049 | ||||||
| 16 | 13.91696167 | ||||||
| 17 | 0.235565331 | ||||||
| 18 | 0.685156864 | ||||||
| 19 | 1.577792626 | ||||||
| 20 | 1.070626537 |
图 4 用 SimulationTools.xls 中的"获取样本量"计算样本量。
4.3 分位数
为了给出分位数的区间估计量,回顾一下在均值表示比例或概率 这一特殊情形下均值的区间估计量是有帮助的。在本书中,我们选择把比例或概率当作均值的一个特例来处理。然而,在许多统计学教材中,概率是被分开处理的。
当独立重复实验的次数 大到足以使 时,概率 的置信区间通常写作
其中 是样本比例(代数推导表明,在用于估计比例时,这一半宽公式与式 (10) 完全等价)。
正如第 3 节所述,分位数估计问题是概率估计问题的逆问题:找出 θ,使得 。因此,为了估计 分位数,我们要找出这样一个值 , 使得 Y 的直方图中 100p% 的数据位于 , 的左侧,或者换一种说法,即 中第 np 小的值。把这一思想加以推广,可以找到 θ 的一个近似的 置信区间,方法是找出两个值:,它截去直方图的 %;以及 ,它截去直方图的 ,其中
(回想一下, 是已知的。)用排序后的值来表示, 是第 小的值(向下取整), 是第 小的值(向上取整),均取自 。
例 12
假设我们想要估计 SMP 等待队列中日平均等待时间的 0.75 分位数,并基于 次重复实验构造它的 95% 置信区间。数据可见 www.bcnn.net 上的电子表格 Quantile.xls。点估计量为 分钟,因为它是排序后数据的第 - 小的值。其解释是:从长期看,在 75% 的日子里,顾客平均等待时间将小于或等于 3.39 分钟。
为了得到置信区间,我们首先计算
置信区间的下界是 分钟(第 10 小的值,向下取整);置信区间的上界是 .98 分钟(第 -240 小的值,向上取整)。因此,以 95% 的置信度,3.39 分钟这一点的估计与真实的 0.75 分位数相差不超过 分钟。
重要的是要理解:3.39 分钟是日平均顾客延误的 0.75 分位数(第 75 百分位数)的估计值,而不是单个顾客延误的估计值。由于呼叫中心在一天开始时是空且空闲的,并且系统上的顾客负载在一天当中不断变化,单个顾客等待时间的 0.75 分位数在一天当中也是变化的,不可能用一个单一的数字给出。
4.4 由汇总数据估计概率与分位数
如果仿真软件所提供的全部信息只是 Y¯ 和 H,而你需要推算出达到预先指定精度所需的重复实验次数,或者你需要估计一个概率或分位数,那么了解置信区间半宽的公式就很重要。你知道重复实验的次数,因此可以利用下式由 H 提取出样本标准差:
有了这一信息,就可以采用第 4.2 节中的方法。
更困难的问题是由汇总数据估计概率或分位数。当我们手头只有样本均值和置信区间半宽(由此得到样本标准差)时,一种做法是对所要求的概率或分位数使用正态理论近似,具体地
以及
下面的例子说明如何做到这一点。
例 13
由某制造仿真的 25 次重复实验得到日平均在制品的 90% 置信区间为 218 32。日平均在制品小于 350 的概率是多少?日平均在制品的第 85 百分位数是多少?
首先,我们提取标准差:
然后,利用正态近似和表 A.3 得到
以及
用这种方式获得概率和分位数是有缺陷的。该近似在很大程度上取决于所关注的输出变量是否服从正态分布。如果输出变量本身不是一个平均值,那么这一近似就值得怀疑。因此,我们预期该近似对关于日平均周期时间的论断效果良好,但对单个零件周期时间的论断效果很差。
5 稳态仿真的输出分析
考虑仿真模型的一次运行,其目的是估计系统的一个稳态即长期特征。假设这一次运行产生观察值 ,一般地,它们是一个自相关时间序列的样本。稳态(或长期)性能度量 θ 由下式定义:
以概率 1 成立,其中 θ 的值与初始条件无关。(“以概率 ” 这一说法是指:对该模型所作的、使用不同随机数的几乎所有仿真,都会产生一个序列 . 其样本平均收敛到 θ。)例如,如果 是顾客 i 与话务员通话所花的时间,那么 θ 就是顾客与话务员通话的长期平均时间;并且由于 θ 被定义为一个极限,它不依赖于呼叫中心在时间 0 的状态。类似地,对于连续时间输出度量 ,例如呼叫中心等待队列中等待的顾客数,其稳态性能定义为
以概率 1 成立。
当然,仿真分析人员可以决定在收集了若干个(比如说 n 个)观察值之后停止仿真;也可以决定仿真一段时间长度 ,由它决定 n(不过 n 可能随运行而不同)。样本量 n(或 是一个设计选择;它并不是由问题的性质内在地决定的。仿真分析人员在选择仿真运行长度(n 或 时,头脑中会有以下几方面的考虑:
点估计量中由人为或任意的初始条件所造成的偏差。(如果运行长度太短,偏差可能很严重,但一般地它随运行长度的增加而减小。)
点估计量所期望的精度,用标准误或置信区间半宽度量。
执行仿真可用时间上的预算约束。
下一小节讨论初始化偏差,随后的几个小节概述估计点估计量变异性的两种方法。为叙述清晰,我们只讨论由离散时间输出过程估计 θ 的问题。因此,在讨论一次重复实验(或一次运行)时,将使用记号
;如果作了若干次重复实验,则第 r 次重复实验的输出数据记为
5.1 稳态仿真中的初始化偏差
有几种方法可以减小稳态仿真中因使用人为且不现实的初始条件而造成的点估计量偏差。第一种方法是把仿真初始化在一个更能代表长期条件的状态。这种方法有时称为智能初始化(intelligent initialization)。例子包括
在库存仿真中设定库存水平、缺货数量,以及已订购物品的数量及其到货日期;
在排队仿真中把顾客放入队列并置于服务之中;
在可靠性仿真中让某些部件已经发生故障或已经退化。
智能地规定初始条件至少有两种途径。如果系统确实存在,就收集关于它的数据,并用这些数据来规定更接近典型的初始条件。这种方法有时需要大量的数据收集工作。此外,如果被建模的系统并不存在——例如,它是现有系统的一个变体——那么这种方法就无法实施。尽管如此,仍建议仿真分析人员利用现有系统的任何可用数据来帮助初始化仿真,因为这通常优于假定系统在时间 0 是"完全备货”、“空且空闲"或"全新"的。
一个相关的想法是:从系统的第二个模型获得初始条件,该模型被简化到足以能用数学方法求解。排队模型对此非常有用。可以对简化后的模型求解,找出长期期望的或最可能的条件——例如队列中的期望顾客数——然后用这些条件来初始化仿真。
减小初始条件影响的第二种方法(可以与第一种方法结合使用)是:把每次仿真运行划分为两个阶段——首先是从时间 0 到时间 的初始化阶段,随后是从时间 到停止时刻 的数据收集阶段;也就是说,仿真在时间 0 于规定的初始条件 下启动,并运行一段规定的时间 。对感兴趣的响应变量的数据收集直到时间 才开始,并一直持续到时间 。 的选择相当重要,因为在时间 的系统状态(记为 )应当比时间 0 的原始初始条件 更接近稳态行为。此外,数据收集阶段的长度 应当足够长,以保证对稳态行为的估计具有足够的精度。注意,时间 时的系统状态 I 是一个随机变量;说系统已经达到近似稳态,就是说时间 时系统状态的概率分布与稳态概率分布足够接近,从而使得响应变量点估计中的偏差可以忽略不计。图 5 说明了稳态仿真运行的两个阶段。下面的例子给出了以"空且空闲"状态启动一个排队系统仿真运行所产生的影响,以及一种有助于仿真分析人员为 , 选择恰当取值的有用图形。
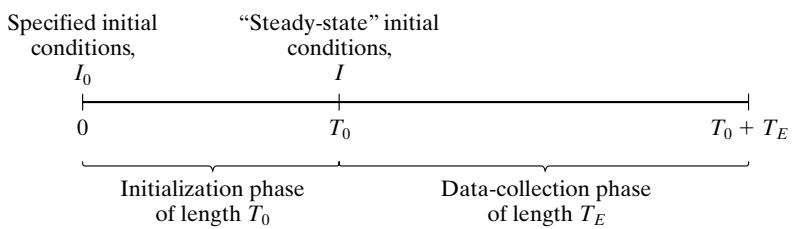
图 5 稳态仿真运行的初始化阶段与数据收集阶段。
例 14
考虑例 8 中所讨论的 FastChip 晶圆制造问题。假设共作了 次独立重复实验,每次运行的时间足够长,使得对 C 芯片和 D 芯片各收集到 250 个周期时间。我们将聚焦于 C 芯片。
通常,我们把每次重复实验内的所有数据加以平均,得到一个重复实验平均值。然而,我们当前阶段的目标是识别数据中由初始化偏差造成的趋势,并弄清该趋势何时消散。为此,我们将对各个相应的周期时间在重复实验之间求平均并绘图(这一思想通常归功于 Welch [1983])。这类平均值称为总体平均(ensemble average)。具体地,令 为第 r 次重复实验中按完工顺序排列的 250 个 C 芯片周期时间。对第 j 个周期时间,定义在所有 R 次重复实验上的总体平均为
(此处 R 10)。这些总体平均被绘为图 6 中的实线(虚线将在下面讨论)。该图由 SimulationTools.xls 电子表格生成,我们将称之为均值图(mean plot)。
注意开头处逐渐上升的趋势。仿真分析人员可能会怀疑,这是由于这些估计量中的向下偏差所致,而该偏差又源于晶圆厂在时间 0 处于空且空闲状态。随着时间变长(从而记录的周期时间个数增加),初始条件对后续观察值的影响减弱,观察值似乎围绕一个共同的均值上下波动。当仿真分析人员认为已经到达这一点时,数据收集阶段就开始了。这里大约 120 个 C 芯片周期时间可能就足够了。
尽管我们已经确定了 120 个周期时间这一删除量,但初始化阶段几乎总是以仿真时间 来规定的,因为我们需要针对每个性能度量分别考虑初始化阶段,而它们可能各不相同。在 FastChip 的例子中,我们还需要考察 D 芯片的周期时间。如果我们把初始化阶段规定为每个输出的计数,那么就必须跟踪这些计数。另一方面,当初始化阶段按时间规定时,则可以在时间 , 安排一个单一事件,并且只保留该时点之后的数据。
为了按时间规定 ,我们必须把相应的计数换算为近似的时间,并取其中最大的一个。例如,对于 FastChip 仿真,120 个 C 芯片周期时间大约对应 200 小时的仿真时间,因为片盒以每小时 1 个的速率投料,并且投料中 60% 是 C 芯片:120 个周期时间 / 0.6 次投料每小时 200 小时(我们也可以把它略微增大一些,以计入第 120 个 C 芯片投料穿越晶圆厂所需的时间)。结果这比 D 芯片的初始化阶段更长,于是我们设定 小时。
绘制总体平均是额外的工作(尽管 SimulationTools.xls 使之变得容易),因此人们可能会想走捷径。例如,有人可能只绘制第 1 次重复实验的输出 ,或者第 1 次重复实验的累积平均
其中 。图 7 同时给出了这两者。注意,来自单次重复实验的原始数据可能变异性过大,以致无法察觉趋势;而累积图则明显向下偏倚,因为它保留了运行开始以来的全部数据。因此,应当避免这些捷径,而改用均值图。
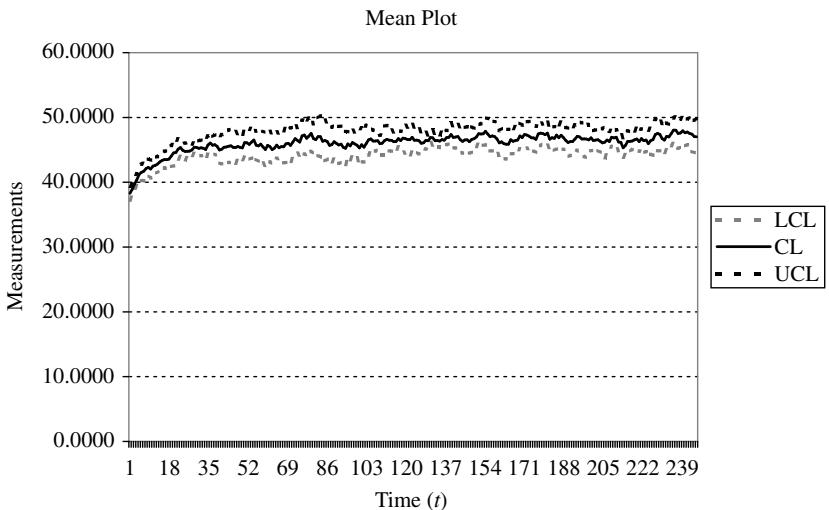
图 6 250 个 C 芯片周期时间在 10 次重复实验上的均值图。
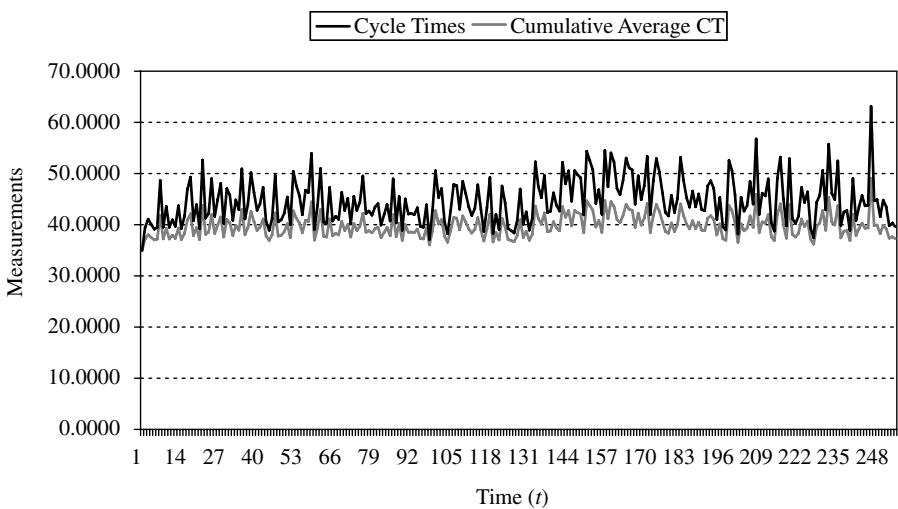
图 7 来自 1 次重复实验的 250 个 C 芯片周期时间图,原始值与累积平均。
在使用均值图确定初始化阶段时,还需牢记以下几个附加因素:
在开始考察初始化阶段时,运行长度和重复实验次数都只能靠猜测。诸如(图 6 那样的)总体平均会随着重复实验次数 R 的增加而呈现出更平滑、更精确的趋势,并且可能需要多次增加 R,直到趋势变得清晰。也有可能所猜测的运行长度不足以越过初始化阶段(如果均值图中的趋势没有消失,就表明了这一点),因此运行长度可能也必须增加。
总体平均还可以通过绘制移动平均而非原始总体平均来加以平滑。在移动平均中,每个绘制点实际上是若干个相邻总体平均的平均值。具体地,第 j 个绘制点将是
其中 ,而不是原始总体平均 。m 的取值通常用试错法选定,直到得到平滑的图形为止。图 6 中的均值图是用 得到的。
由于每个总体平均(或移动平均)都是在 R 次重复实验上独立同分布观察值的样本均值,因此可以围绕每个点放置一个基于 t 分布的置信区间,如图 中的虚线所示,并可利用这些区间判断该图是否已足够精确、足以判定偏差已经消失。这是确定删除点的首选方法。
累积平均(如图 7 中那样)随着被平均的数据增多而变异性变小。因此,可以预期曲线的左侧总是比右侧更不平滑。请记住,累积平均收敛到长期性能的速度往往比总体平均更慢,因为累积平均包含了所有观察值,其中包括运行开始时偏差最大的那些。由于这个原因,只有在无法计算总体平均时才应使用累积平均,例如当只能作一次重复实验时。
关于初始化偏差问题,从来不缺少解决方案。遗憾的是,对于每一个在某些情形下效果良好的"解决方案”,都存在另一些情形,在其中它要么不适用,要么表现很差。重要的思想包括:对偏差作检验(例如 Kelton 与 Law [1983]、Schruben [1980]、Goldsman、Schruben 与 Swain [1994]);对偏差建模(例如 Snell 与 Schruben [1985]);以及在多次重复实验上对初始条件随机抽样(例如 Kelton [1989])。
5.2 稳态仿真的误差估计
如果 在统计上不独立,那么由式 , 给出的 就是真实方差 的一个有偏估计量。当 是来自单次重复实验内部的一个输出观察值序列时,情况几乎总是如此。在这种情形下,. 是一个自相关序列,有时被称为时间序列(time series)。
假设我们对 θ 的点估计量是样本均值 。数理统计中的一个一般结果^2 是: 的方差为
其中 cov 。为了构造 θ 的置信区间,需要对 作出估计。但要对式 (22) 作出估计是徒劳的,因为一般地每一项 cov 都可能不同。幸运的是,具有稳态的系统,如果仿真得足够长以越过暂态阶段,所产生的输出过程将是近似协方差平稳的。直观地说,平稳性意味着 依赖于 的方式,与 依赖于 的方式相同。特别地,时间序列中两个随机变量之间的协方差只取决于它们之间相隔的观察值个数,这个个数称为滞后(lag)。对于一个协方差平稳时间序列 ,定义滞后 k 自协方差为
由协方差平稳性的定义,它不是 i 的函数。当 , γ 变为总体方差 即,
滞后 k 自相关是相隔 k 的任意两个观察值之间的相关。它定义为
并具有以下性质:
$$
- 1 \leq \rho_{k} \leq 1, \quad k = 1, 2, \dots $$
如果一个时间序列是协方差平稳的,那么式 (22) 就可以大大简化。代数推导表明
其中 是式 (25) 给出的滞后 k 自相关。
当对所有 k(或大多数 k)都有 时,称该时间序列为正自相关(positively autocorrelated)。在这种情况下,大的观察值往往跟着大的观察值,小的观察值跟着小的观察值。这样的序列往往会缓慢地漂移到其均值之上,然后又漂移到均值之下。图 8(a) 是一个表现出正自相关的平稳时间序列的例子。大多数排队仿真的输出数据都是正自相关的。
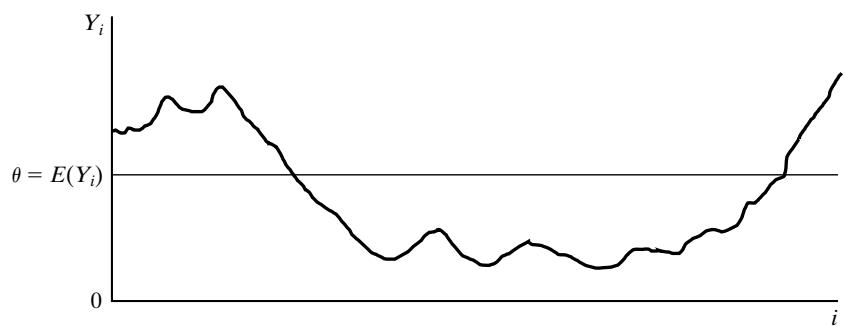
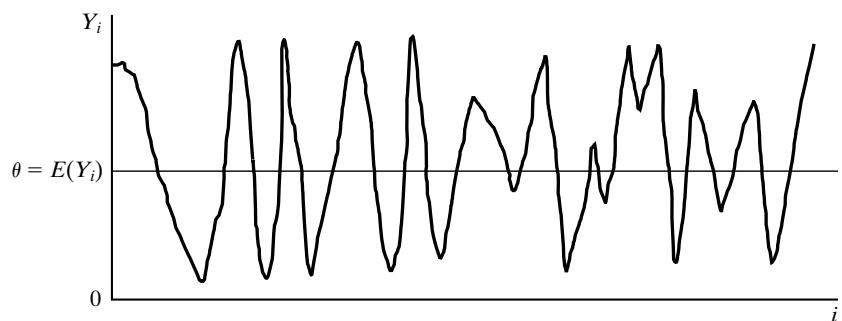
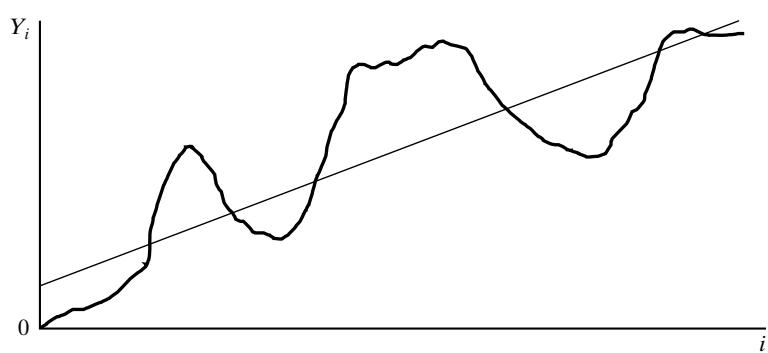
图 8 (a) 表现出正自相关的平稳时间序列 ;(b) 表现出负自相关的平稳时间序列 ;(c) 具有上升趋势的非平稳时间序列。
另一方面,如果某些 ,则序列 . 将表现出负自相关的特征。在这种情况下,大的观察值往往跟着小的观察值,反之亦然。图 8(b) 是一个表现出负自相关的平稳时间序列的例子。某些库存仿真的输出可能是负自相关的。
图 8(c) 还给出了一个具有上升趋势的时间序列的例子。这样的时间序列不是平稳的; 的概率分布随指标 i 而变化。
为什么自相关会使 的估计变得困难?回顾一下,样本均值方差的标准估计量是 。利用式 (26) 可以证明 [Law, 1977],方差估计量 的期望值为
其中
而 c 是式 (26) 中方括号内的那个量。自相关对估计量 的影响,可以通过考察式 (26) 和式 (28) 得出。本质上存在三种可能:
情形 1
如果 是独立的,那么对 . 有 。因此,,而式 (26) 退化为熟悉的 。还要注意 ,所以 是 V(Y¯ ) 的无偏估计量。当 取自不同的重复实验时,它们总是独立的;这种独立性正是我们偏好要求进行多次重复实验的实验设计的主要原因。
情形 2
如果自相关 主要是正的,那么 ,于是 , 从而 。因此, 作为 的估计量是向下偏的。如果忽略这种相关性,由式 (10) 给出的名义 置信区间就会过短,其真实置信系数将小于 。实际后果是:由于置信区间过短,仿真分析人员会对点估计量表面上的精度产生毫无根据的信心。如果相关 很大,B 可能相当小,这意味着严重的低估。
情形 3
如果自相关 显著为负,那么 ,于是 ,并且 对 是向上偏的。换言之,点估计量 的真实精度将高于其方差估计量 所显示的精度,因为
结果是,由式 (10) 给出的名义 置信区间的真实置信系数将大于 。这一错误不如情形 2 严重,因为如果我们的估计实际上比我们以为的更精确,我们就不大可能作出错误的决策。
一个简单的例子说明了我们为什么特别关注正相关:假设你想知道一所大学校园里的学生在即将到来的选举中会如何投票。为了估计他们的偏好,你计划征集 100 个回答。标准实验是随机选取 100 名学生进行民意调查;称之为实验 A。另一种做法是随机选取 20 名学生,让每个人在同一天把他们的偏好陈述 5 次;称之为实验 B。两个实验都获得 100 个回答,但显然基于实验 B 的估计不如基于实验 A 的估计精确(具有更大的方差)。实验 A 获得 100 个独立的回答,而实验 B 只获得 20 个独立的回答和 80 个相依的回答。来自任一学生的 5 个意见是完全正相关的(假定该学生 5 次都报出同一位候选人)。尽管这是一个极端的例子,它说明了基于正相关数据的估计比基于独立数据的估计具有更大的变异性。因此,置信区间或其他误差度量应当正确地考虑相依数据,而 却没有做到这一点。
下面两节给出两种消除或减小自相关对均值估计的有害影响的方法。遗憾的是,某些仿真语言在所有情形下都使用 作为 )(样本均值的方差)的估计量,或者促使其被这样使用。如果在输出数据正自相关的仿真中不加鉴别地使用它,那么 中的向下偏倚以及由此造成的 θ 的置信区间过短,会传达出一种远好于实际存在的精度印象。当输出数据中存在这种正自相关时,点估计量 的真实方差可能比 所显示的要大许多倍。
5.3 稳态仿真的重复实验法
如果点估计量中的初始化偏差已经通过智能初始化与数据删除的某种组合被减小到可以忽略的水平,那么就可以用独立重复实验法来估计点估计量的变异性并构造置信区间。其基本思想很简单:作 R 次重复实验,每一次都以相同的方式初始化并删除数据。
然而,如果点估计量中仍存在显著偏差,并且用大量重复实验来减小点估计量的变异性,那么所得到的置信区间就可能是误导性的。之所以如此,是因为偏差不受重复实验次数 R 的影响;它只受删除更多数据(即增大 或延长每次运行的长度(即增大 的影响。因此,增加重复实验次数 R 可能得到围绕"错误点"的更短置信区间。所以,彻底地考察初始条件偏差是很重要的。
如果仿真分析人员决定在重复实验的 n 个观察值中删除 d 个观察值,那么 θ 的点估计量为
也就是说,点估计量是剩余数据的平均值。基本的原始输出数据 如表 4 所示。例如, 可以是第 r 次重复实验中顾客 j 在队列中的延误,或者作业车间中作业 j 的响应时间。被删除的观察值个数 d 和观察值总数 n 在不同重复实验之间可能不同,此时把 d 替换为 、把 n 替换为 。为简单起见,假定 d 和 n 在各次重复实验上保持不变。
表 4 稳态仿真的原始输出数据
| 重复实验 | 观察值 | 重复实验平均值 | |||||
|---|---|---|---|---|---|---|---|
| 1 | d | n | |||||
| 1 | |||||||
| 2 | |||||||
| . | . | . | . | . | . | ||
| . | . | . | . | . | . | ||
| . | . | . | . | . | . | ||
| R | |||||||
在使用重复实验法时,为了估计 θ,每次重复实验都被视为一个单独的样本。对于重复实验 ,定义
为重复实验 r 中所有(未删除)观察值的样本均值。由于所有重复实验使用不同的随机数流,并且都通过在时间 0 的同一组初始条件 , 进行初始化,因此各重复实验的平均值
是独立同分布的随机变量;也就是说,它们构成来自某个具有未知均值
的潜在总体的一个随机样本。由式 (29) 给出的总点估计量也可以写成
这可以从表 4 看出,也可以由式 (21) 得到。于是同样有
如果 d 和 n 选得足够大,那么 ,并且 是 θ 的一个近似无偏估计量。 中的偏差是 。为方便起见,当 n 和 d 的取值已经明确时,把 (第 r 次重复实验中未删除观察值的均值)和 [即 的均值] 分别简记为 和 。为了估计 的标准误,首先计算样本方差:
的标准误由下式给出:
基于 t 分布的 , 的 置信区间为
其中 是自由度为 的 t 分布的 百分位点。该置信区间只有在 的偏差近似为零时才是有效的。
作为一个粗略的规则,每次重复实验在删除点之后的长度,至少应为所删除数据量的十倍。换言之, 至少应为 10d(或者更一般地, 至少应为 。在这一运行长度下,重复实验的次数应在时间允许的前提下尽可能多,最多约 25 次。Kelton [1986] 指出,把可用时间划分为超过 25 次重复实验几乎没有价值,因此,如果时间允许作多于 25 次长度为 的重复实验,那么就改作 25 次长度超过 , 的重复实验。同样,这些都是粗略的规则,不必机械地照搬。
在本节中,我们把结果表述为运行长度是 n 个观察值、其中删除 d 个。正如前面所讨论的,在实践中我们作一次长度为 时间单位的运行,并删除前 个时间单位。在这种情形下, 变为直到时间 为止所获得的观察值个数,而 是在时间 与 , 之间所记录的观察值个数,两者都是随机变量,并且通常在不同重复实验之间各不相同。在下面的例子中,我们将在记号中使用 而不是 ,以明确这一点。
例 15
再次考虑例 8 和例 14 中的 FastChip 晶圆厂仿真。假设仿真分析人员决定作 次重复实验,每次长度为 小时,在数据收集开始之前删除前 小时,如例 14 中所确定的那样。请记住,原始输出数据由 C 芯片片盒的周期时间组成,每次重复实验的输出是在时间 小时与 小时之间完工的所有 C 芯片片盒的平均值(每次重复实验大约有 个周期时间)。仿真的目的是估计长期平均周期时间(记为 ),并用 95% 置信区间度量估计的误差。
表 5 FastChip 仿真按重复实验汇总的数据
| 重复实验 r | 重复实验 r 的样本均值 |
|---|---|
| 1 | 46.86 |
| 2 | 46.09 |
| 3 | 47.64 |
| 4 | 47.43 |
| 5 | 46.94 |
| 6 | 46.43 |
| 7 | 47.11 |
| 8 | 46.56 |
| 9 | 46.73 |
| 10 | 46.80 |
| 46.86 | |
| S | 0.46 |
各重复实验的平均值 , 如表 5 所示。由式 (32) 计算点估计量为
其标准误由式 (34) 给出:
取 和 , 长期平均队长(queue length)的 95% 置信区间由不等式 (35) 给出:
即
仿真分析人员可以有很高的把握断定:C 芯片的长期平均周期时间在 46.52 小时与 47.20 小时之间。这里由不等式 (35) 计算得到的置信区间应当谨慎使用,因为其有效性背后的一个关键假设是:已经删除了足够多的数据,从而消除了由初始条件造成的任何显著偏差——也就是说, 和 足够大,使得偏差 可以忽略不计。
5.4 稳态仿真中的样本量
假设希望以 的置信度把某个长期性能度量 θ 估计到 以内。在稳态仿真中,达到指定精度既可以靠增加重复实验次数 R,也可以靠增加运行长度 。第一种解法——控制 R——按第 4.2 节中对终止型仿真所给出的方式实施。
例 16
把表 5 中 FastChip 晶圆厂仿真的数据看作一个规模为 的初始样本。标准差初始估计为 小时。假设希望以 95% 的置信度把 C 芯片的长期平均周期时间 w 估计到 1 小时(6 分钟)以内。在不等式 (16) 中取 ,得到 R 的初始估计为
因此,至少将需要 82 次重复实验。
增加 R 之外的另一种选择,是增加每次重复实验内的总运行长度 。如果第 4.2 节中的计算(如例 16 所示)表明在初始的 , 次之外还需要 次追加重复实验,那么一种替代做法是按同样的比例 把运行长度 增加到新的运行长度 。于是,将有更多数据被删除,即从时间 0 到时间 , 的数据,同时将有更多数据被用于计算点估计,如图 9 所示。然而,总的仿真工作量与简单地增加重复实验次数而保持运行长度不变时是相同的。增加每次重复实验的总运行长度、并删除总运行长度中固定比例 的数据,其优点是:点估计量中任何残余偏差都会因在运行开始处额外删除数据而进一步减小。该方法的一个可能缺点是,为了把全部 R 次重复实验继续运行下去(从时间 到时间 ),就必须保存模型在时间 的状态,并且能够重新启动模型并让它运行所需的额外时间。否则,这些仿真就必须从时间 0 重新运行,而对于一个复杂的模型来说,这可能是很耗时的。某些仿真语言具有保存足够信息的能力,使一次重复实验能够从时间 往后继续,而不必从时间 0 重新开始。
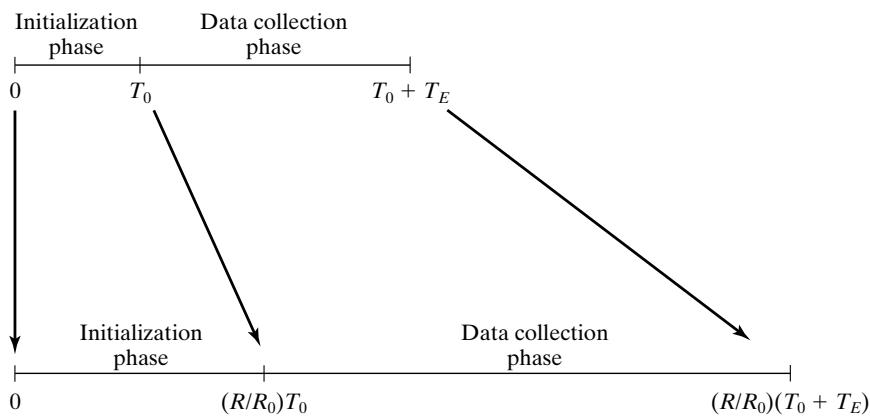
图 9 通过增加运行长度达到指定精度。
例 17
在例 中,假设要通过增加运行长度来达到所期望的 0.1 小时误差。由于 , 运行长度应为 小时。从时间 0 到时间 小时所收集的数据将被删除,而时间 1640 到时间 18,040 之间的数据将用于计算新的点估计和置信区间。
5.5 稳态仿真的批均值法
重复实验法的一个缺点是:每次重复实验都必须删除数据,并且在某种意义上,被删除的数据是被浪费的数据,或者至少是丢失的信息。这提示我们,采用基于单次长时间重复实验的实验设计或许有其可取之处。单次重复实验设计的缺点在我们试图计算样本均值的标准误时显现出来:由于我们只有来自一次重复实验内部的数据,这些数据是相依的,而通常的估计量是有偏的。
批均值(batch means)法试图解决这一问题:把一次重复实验的输出数据(经过恰当删除之后)划分为少数几个大批,然后把这些批的均值当作独立的观察值来处理。当删除后的原始输出数据构成一个连续时间过程 时(例如队列长度或库存水平),我们构造 k 个规模为 的批,并计算批均值为
。换言之,第 j 个批均值就是该过程在时间区间 上的时间加权平均。
当删除后的原始输出数据构成一个离散时间过程 时(例如队列中的顾客延误或库存系统每个周期的成本),我们构造 k 个规模为 的批,并计算批均值为
其中 (假定 k 能整除 ,否则向下取整到最接近的整数)。也就是说,批均值按下所示的方式构成:
无论从连续时间数据还是离散时间数据出发,样本均值的方差都由下式估计:
其中 是删除后数据的总样本均值。各批均值 并不独立;不过,如果批的规模足够大,相继的批均值将近似独立,而方差估计量也将近似无偏。
遗憾的是,并不存在被广泛接受且相对简单的方法来选择一个可接受的批规模 m(或等价地,选择批数 。不过,从研究文献中还是可以梳理出一些一般性的指导原则:
a. Schmeiser [1982] 发现,在总样本量固定的情况下,把它划分为超过 k 30 个批几乎没有什么收益,即便我们能够做到这一点并且仍能保持批均值之间的独立性。因此,无论有多少原始数据可用,都没有理由考虑远大于 30 的批数。他还发现,就置信区间的宽度及其宽度的变异性而言,当批数少于 10 时其表现很差。因此,在大多数应用中应当使用介于 10 与 30 之间的批数。
b. 尽管通常在所有滞后上批均值之间都存在自相关,但人们一般考察滞后 1 自相关 ,以评估批均值之间的相依性。当滞后 1 自相关接近于 0 时,就把批均值当作独立的来处理。这一做法基于如下观察:许多随机过程中的自相关随滞后的增大而减小。因此,所有滞后自相关的绝对值都应当小于滞后 1 自相关。
c. 批均值之间的滞后 1 自相关可以被估计(见下文)。然而,不应依据少量的批均值(例如上面推荐的 )来估计自相关;自相关估计量中存在偏差。Law 与 Carson [1979] 建议:先基于较小的批规模、用大量的批均值(或许 )来估计滞后 1 自相关。当这些批均值之间的自相关近似为 0 时,如果我们把数据重新分批为基于更大批规模的 10 到 30 个批均值,那么自相关将更小。检验自相关为 0 的假设检验方法是有的,如下所述。
d. 如果总样本量要序贯地确定(比如说为了达到指定精度),那么让批规模和批数随运行长度的增加而增长是有帮助的。可以证明,一个好的策略是:先找到一个使滞后 1 自相关近似为 0 的批规模,然后让批数随样本量的平方根而增加。尽管我们不打算进一步讨论这一点,但基于它的一个算法可见 Fishman 与 Yarberry [1997];另见 Steiger 与 Wilson [2002] 以及 Lada、Steiger 与 Wilson [2006]。
鉴于上述认识,我们推荐下面的一般策略:
从一次重复实验获得输出数据,并作恰当的删除。回顾我们的指导原则:所收集的数据至少应为所删除数据的 10 倍。
用保留下来的数据构造至多 个批(但至少 100 个批),并计算批均值。把批均值的样本滞后 1 自相关估计为
检查该相关是否足够小。
(a) 如果 , 则把数据重新分批为 个批,并用 个自由度的 t 分布以及式 (36) 估计 的方差,从而构造置信区间。
(b) 如果 , 则把该次重复实验延长 50% 到 100%,并回到步骤 2。如果无法延长该次重复实验,则把数据重新分批为大约 个批,并用 个自由度的 t 分布以及式 (36) 估计 的方差,从而构造置信区间。
作为对置信区间的一项附加检查,用下述检验考察批均值(在较大或较小的批规模下)的独立性。例如见 Alexopoulos 与 Seila [1998]。计算检验统计量
如果 ,则接受批均值相互独立,其中 是该检验的第 I 类错误水平,如 0.1、0.05、0.01。否则,把该次重复实验延长 50% 到 100%,并回到步骤 2。如果无法延长该次重复实验,则把数据重新分批为大约 个批,并用 个自由度的 t 分布以及式 (36) 估计 Y 的方差,从而构造置信区间。
这一流程(包括最后的检查)在若干方面是保守的。首先,如果滞后 1 自相关显著为负,我们仍然继续构造置信区间。占主导地位的负相关倾向于使置信区间比必要的更宽,这是一个错误,但不是会导致我们作出错误决策的那种错误。在 - 个批时要求 是相当严格的,只要存在一点正相依的迹象,它就会迫使我们获取更多数据(从而形成更大的批)。最后,末尾的假设检验有 的概率迫使我们在其实并不需要更多数据时去获取更多数据。但这种保守性是有意设计的;作出错误决策的代价,通常远高于增加一些计算机运行时间的代价。
下面用一个例子说明用批均值法估计置信区间。
例 18
重新考虑例 8 中的 FastChip 晶圆厂仿真。假设我们希望用 95% 置信区间估计 C 芯片的稳态平均周期时间 w。为了说明批均值法,假定已经作了一次模型运行,在删除点之后仿真了 5000 个周期时间。然后我们用 个规模为 的批构造批均值,并估计滞后 1 自相关为 。于是我们决定把仿真延长到删除点之后的 10,000 个顾客,并再次估计滞后 1 自相关。这一基于 个规模为 的批的估计值为 。通过了相关性检查之后,我们把数据重新分批为 个规模为 的批。点估计是总均值
的方差由这 40 个批均值计算得到:
于是,95% 置信区间为
即
因此,我们以 95% 的置信度断言:真实平均周期时间 w 介于 46.55 小时与 47.45 小时之间。如果这些结果的精度不够,那么就应该增加运行长度以获得更高的精度。
作为对置信区间有效性的一项进一步检查,我们可以应用相关性假设检验。为此,我们用构造置信区间所用的那 个规模为 的批来计算检验统计量。这给出
这证实了在 0.05 显著性水平上不存在相关性。注意,在批数这么少的情况下,滞后 1 自相关的估计值看起来略微为负,这正印证了我们前面关于用少量观察值估计相关性的困难所在的论点。
5.6 稳态分位数
在稳态仿真中构造分位数估计的置信区间可能很棘手,特别是当所关注的输出过程是一个连续时间过程时,例如 ), 即时刻 t 队列中等待的顾客数。在本节中,我们概述其中的主要问题。
先考虑较容易的情形。假设一次重复实验的输出过程(在恰当删除初始数据之后)是 。具体地说, 可以是第 i 位顾客在队列中的延误。那么 p 分位数的点估计可以像前面那样得到,既可以由数据的直方图得到,也可以由排序后的值得到。当然,只使用删除点之后的数据。假设我们作了 次重复实验,并令 为第 r 次的分位数估计。那么这 R 个分位数估计 -, 是独立同分布的。它们的平均值为
它可以用作 的点估计量,而一个近似的置信区间为
其中 是 - - 的通常样本方差。如果只作了单次重复实验呢?那么同样的推理仍然适用,只要令 为第 i 批数据内部的分位数估计。这需要在每一批内部对数据进行排序或作出直方图。如果批足够大,那么这些批内分位数估计也将近似独立同分布。
当我们面对一个连续时间输出过程时,原则上同样的方法也是适用的。然而,我们必须注意不要以改变问题的方式对数据进行变换。特别地,我们不能像本章通篇所做的那样先构造批均值,然后再由这些批均值估计分位数。 的批均值的 p 分位数,并不等于 本身的 p 分位数。因此,分位数点估计必须由原始数据的直方图构成,如果我们作了重复实验,就由每次运行构成;如果我们只作单次重复实验,则在每一批内部构成。
6 小结
本章强调这样一个思想:一次随机离散事件仿真就是一次统计实验。因此,在能够基于仿真所生成的输出数据得出可靠的结论之前,必须先作恰当的统计分析。仿真实验的目的是获得对所研究系统性能度量的估计。统计分析的目的是获得某种保证,即这些估计对于模型的预期用途而言具有足够的精度。
本章区分了终止型仿真与稳态仿真。稳态仿真的输出数据分析起来更困难,因为仿真分析人员必须处理初始条件问题和运行长度的选择问题。关于这些问题已经给出了一些建议,但遗憾的是,并不存在简单、完备且令人满意的解决方案。尽管如此,仿真分析人员应当意识到这些潜在的问题,以及可能的解决办法——即删除数据和增加运行长度。更高级的统计技术(本书不予讨论)见 Alexopoulos 与 Seila [1998]、Bratley、Fox 与 Schrage [1996] 以及 Law [2007]。
点估计量的统计精度可以用标准误估计来度量,也可以用置信区间来度量。本章着重讨论了独立重复实验法。用这种方法,仿真分析人员生成统计上独立的观察值,从而可以采用标准的统计方法。对于稳态仿真,本章还讨论了批均值法。
要点在于:仿真输出数据含有一定量的随机变异性;如果不对其大小作出某种评估,那么点估计就无法被有把握地使用。
参考文献
ALEXOPOULOS, C.,ANDA. F. SEILA [1998], “Output DataAnalysis,” Chapter 7 in Handbook ofSimulation, J. Banks, ed., Wiley, New York.
BRATLEY, P., B. L. FOX, AND L. E. SCHRAGE [1996], A Guide to Simulation, 2d ed., Springer-Verlag, New York.
FISHMAN, G. S.,AND L. S.YARBERRY [1997], “An Implementation ofthe Batch Means Method,” INFORMS Journal on Computing, Vol. 9, pp. 296–310.
GOLDSMAN, D., L. SCHRUBEN, AND J. J. SWAIN [1994], “Tests for Transient Means in Simulated Time Series,” Naval Research Logistics, Vol. 41, pp. 171–187.
KELTON, W. D. [1986], “Replication Splitting and Variance for Simulating Discrete-Parameter Stochastic Processes,” Operations Research Letters, Vol. 4, pp. 275–279.
KELTON, W. D. [1989], “Random Initialization Methods in Simulation,” IIETransactions,Vol. 21, pp. 355–367.
KELTON, W. D., AND A. M. LAW [1983], “A New Approach for Dealing with the Startup Problem in Discrete Event Simulation,” Naval Research Logistics Quarterly, Vol. 30, pp. 641–658.
KLEIJNEN, J. P. C. [1987], Statistical Toolsfor Simulation Practitioners, Dekker, New York.
LADA, E. K., N. M. Steiger, AND J. R. WILSON [2006], “Performance Evaluation of Recent Procedures for Steady-state Simulation Analysis,” IIE Transactions, Vol. 38, pp. 711-–727.
LAW, A. M. [1977], “Confidence Intervals in Discrete Event Simulation: A Comparison of Replication and Batch Means,” Naval Research Logistics Quarterly, Vol. 24, pp. 667–78.
LAW, A. M. [1980], “Statistical Analysis of the Output Data from Terminating Simulations,” Naval Research Logistics Quarterly, Vol. 27, pp. 131–43.
LAW, A. M. [2007], Simulation Modeling and Analysis, 4th ed., McGraw-Hill, New York.
LAW,A. M.,AND J. S. CARSON [1979], “A Sequential Procedure for Determining the Length of a Steady-State Simulation,” Operations Research, Vol. 27, pp. 1011–1025.
NELSON, B. L. [2001], “Statistical Analysis of Simulation Results,” Chapter 94 in Handbook of Industrial Engineering, 3d ed., G. Salvendy, ed., Wiley, New York.
SCHMEISER, B. [1982], “Batch Size Effects in the Analysis of Simulation Output,” Operations Research, Vol. 30, pp. 556–568.
SCHRUBEN, L. [1982], “Detecting Initialization Bias in Simulation Output,” Operations Research, Vol. 30, pp. 569–590.
SNELL, M., AND L. SCHRUBEN [1985], “Weighting Simulation Data to Reduce Initialization Effects,” IIE Transactions, Vol. 17, pp. 354–363
STEIGER, N. M., AND J. R. Wilson [2002], “An Improved Batch Means Procedure for Simulation Output Analysis,” Management Science, Vol. 48, pp. 1569–1586.
WELCH, P. D. [1983], “The StatisticalAnalysis ofSimulation Results,” in The Computer Performance Modeling Handbook, S. Lavenberg, ed., Academic Press, New York, pp. 268–328.
习题
对下述每一个系统,在什么情况下适于用终止型仿真来分析它,又在什么情况下适于用稳态仿真来分析它?
(a) 一家免预约诊所(walk-in medical clinic),仿真目的是确定人员配备水平。
(b) 一个由股票、债券和衍生证券构成的投资组合,仿真目的是估计长期收益。
(c) 一家每天运行两个班的喷油器装配厂,仿真目的是估计吞吐量。
(d) 美国空中交通管制系统,仿真目的是评估安全性。
假设某排队仿真的输出过程是 , 即时刻 t 队列中的总人数。一个连续时间输出过程可以被转换为本章所描述的那种离散时间过程 , 方法是先构造 个长度为 m 个时间单位的批均值:
其中 。可以绘制这些批均值的总体平均,以检查是否存在初始条件偏差。
(a) 用代数方法证明:2m 个时间单位上的批均值,可以通过对两个相邻的 m 时间单位上的批均值求平均而得到。(提示:这意味着我们可以从相当短的时间区间 m 上的批均值出发,逐步构建更长时间区间上的批均值,而无须重新分析全部数据。)

(b) 仿真一个 \(\lambda = 1\)、\(\mu = 1 . 25\) 的 \(M / M / 1\) 队列,运行长度为 4000 个时间单位,计算队列中总人数的批均值,批规模为 \(m = 4\) 个时间单位。作重复实验并用一个均值图确定应当删除多少个批。把这个要删除的批数换算为一个删除时间。
利用上面习题 2 的结果,设计并实施一个实验,以 95% 的置信度把这个 队列的稳态期望队长 L 估计到 名顾客以内。把你的估计与真实值 ) 作对照检查。
在例 7 中,假设管理层希望对平均周期时间的估计给出一个 95% 置信区间,且允许的误差为 小时(3 分钟)。利用表 5 中给出的同一组初始数据,估计所需的总样本量。尽管我们把误差减小了一半,所需样本量增加了多少?
再次仿真一个 、 的 队列,但这次把顾客在系统中的时间(从到达到离开)记录为性能度量,共记录 4000 名顾客。作重复实验并用一个均值图确定:当系统从空启动、系统中初始有 4 名顾客、以及系统中初始有 8 名顾客时,分别应当删除多少名顾客。预热期(warm-up period)随这些不同初始条件如何变化?这提示我们应当如何初始化仿真?
考虑一个 (M, L) 库存系统,其中采购量 Q 由下式定义:
其中 I 是一个月末在手加上已订购的库存水平,M 是最大库存水平,L 是再订货点。M 和 L 受管理层控制,因此数对 (M, L) 被称为库存策略。在某些条件下,这类模型有可能求得解析解,但并不总是如此。用仿真研究具有以下性质的 库存系统:每月末检查库存状态。允许缺货(backordering),每月每件缺货的成本为 4 美元。当订单到达时,将首先用于缓解缺货。提前期服从区间 [0.25, 1.25] 个月上的均匀分布。设期初库存水平为 50 件,且没有未到货的订单。设持有成本为每月每件在库库存 1 美元。假定每月盘点库存状况。如果下达订单,其成本为 $60 + $5Q,其中 60 美元是订货成本,5 美元是每件物品的成本。需求间隔时间服从指数分布,均值为 1/15 个月。需求量服从如下分布:
需求量的分布
| 需求量 | 概率 |
|---|---|
| 1 | 1/2 |
| 2 | 1/4 |
| 3 | 1/8 |
| 4 | 1/8 |
(a) 对 (M, L) (50, 30) 策略作十次独立重复实验,每次运行长度为 100 个月,并在其前加一段 12 个月的初始化期。用 90% 置信区间估计长期月平均成本。

(b) 利用 (a) 的结果,估计把月平均成本估计到 5 美元以内所需的重复实验总次数。
重新考虑习题 6,但增加一点:如果在每月盘点时库存水平为零或负,则下达一个 单位的紧急订单。紧急订单的成本为 ,其中 120 美元是订货成本,12 美元是每件物品的成本。紧急订单的提前期服从区间 [0.10, 0.25] 个月上的均匀分布。
(a) 对该 (M, L) 策略作十次独立重复实验,并用 90% 置信区间估计长期月平均成本。
(b) 利用 (a) 的结果,估计把月平均成本估计到 5 美元以内所需的重复实验总次数。
假设习题 6 中的物品是易腐的,其售价由下列数据给出:
在架时长与售价
| 在架时间(月) | 售价 |
|---|---|
| 0-1 | $10 |
| 1-2 | 5 |
| >2 | 0 |
因此,任何在架上超过 2 个月的物品都无法售出。货龄在需求发生时度量。如果某件物品已过期,就将其丢弃,并取用下一件物品。对该系统仿真 100 个月。
(a) 对 (M, L) (50, 30) 策略作十次独立重复实验,并用 90% 置信区间估计长期月平均成本。

(b) 利用 (a) 的结果,估计把月平均成本估计到 5 美元以内所需的重复实验总次数。
首先假定期初库存中的所有物品都是新鲜的。这是一个好的假定吗?这一"全部新鲜"的假定对长期月平均成本的估计有什么影响?可以做些什么来改进这些估计?请完成一份完整的分析。
考虑如下库存系统:
(a) 每当库存水平降到或低于 10 件时,就下达一份订单。任一时刻只能有一份订单未到货。
(b) 每份订单的规模为 Q。持有库存的成本为每天每件在库库存 0.50 美元。下达一份订单发生 10.00 美元的固定成本。
(c) 提前期服从 0 到 5 天之间的离散均匀分布。
(d) 如果在库存水平为零的期间发生需求,则该笔销售损失,每件损失 2.00 美元。
(e) 每天顾客人数服从如下分布:
每天顾客人数的分布
| 每天顾客人数 | 概率 |
|---|---|
| 1 | 0.23 |
| 2 | 0.41 |
| 3 | 0.22 |
| 4 | 0.14 |
(f) 每位顾客的需求量服从泊松分布,均值为 3 件。

(g) 为简单起见,假定所有需求都在正午发生,且所有订单都在此后立即下达。
进一步假定订单在下午 5:00 收到,或者晚于当天发生的需求之后收到。考虑 的策略。作十次独立重复实验,每次长度为 100 天,并计算长期日平均成本的 90% 置信区间。考察初始库存水平以及是否存在未到货订单对日平均成本估计的影响。开始时取初始库存为 ,且没有未到货订单。
- 一家销售母亲节贺卡的商店必须提前 6 个月决定要进多少张贺卡。不允许再订货。贺卡进价 0.45 美元,售价 1.25 美元。到母亲节仍未售出的贺卡以 0.50 美元的价格促销 2 周。然而,剩余贺卡的销售在性质上是概率性的,服从如下分布:
32% 的情况下,剩余的所有贺卡都售出。
40% 的情况下,剩余的贺卡售出 80%。
28% 的情况下,剩余的贺卡售出 60%。
2 周之后剩下的贺卡以 0.25 美元售出。贺卡店老板不确定能卖出多少张贺卡,但认为在 200 与 400 之间(即均匀分布)。假设贺卡店老板决定订购 300 张贺卡。估计期望总利润,误差至多 5.00 美元。(提示:先作十次初始重复实验。用这些数据估计所需的总样本量。每次重复实验由一个母亲节构成。)
一家非常大的采矿企业决定用"定期检查、订货至 M"的策略来控制高压管道的库存,其中 M 是目标水平。这种管道的年需求服从正态分布,均值为 600,方差为 800。这一需求在一年当中相当均匀地发生。补货提前期服从 阶厄兰分布,其均值为 2 个月。每件物品的成本为 400 美元。库存持有费用(按年、以物品成本的比例计)预计围绕均值 0.25(单利)正态波动,标准差为 0.01。作一次盘点并下达一份订单的成本为 200 美元,一件缺货的成本估计为每缺货一件 100 美元。假设每 2 个月盘点一次库存水平,并令 。
(a) 作十次独立重复实验,每次运行长度为 100 个月,用 90% 置信区间估计长期月平均成本。
(b) 考察初始条件的影响。计算一个恰当的、应予以删除的月度观察值个数,以把初始化偏差减小到可以忽略的水平。
考虑若干个(设为 N 个)串联的 M/M/1 队列。M/M/1 队列具有速率为每小时 λ 名顾客的泊松到达、均值为 1/µ 的指数分布服务时间,以及单个服务台。(回想一下,“泊松到达"是指到达间隔时间服从指数分布。)所谓串联的 M/M/1 队列,是指在某个服务台完成服务之后,顾客就加入下一个服务台的排队线。该系统可以表示如下:
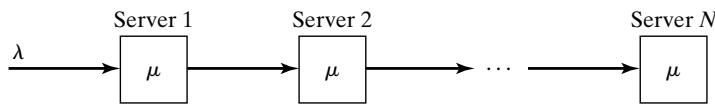
所有服务时间都服从指数分布,均值为 , 并且假定每条排队线的容量为无限。假设 名顾客每小时,且 1 小时。性能度量是响应时间,其定义为一名顾客在系统中的总时间。
(a) 通过作恰当的仿真运行,比较 \(N = 1\)(即一个 M/M/1 队列)与 \(N = 2 ( {\mathrm{i . e .}}\), 两个串联的 M/M/1 队列)的初始化偏差。启动每个系统时各服务台均空闲且没有顾客在场。仿真的目的是估计平均响应时间。

(b) 考察初始化偏差作为 \(N ,\) 的函数的行为,取 \(N = 1 , 2 , 3 , 4 ,\), 和 5。

(c) 就"大型"排队系统在时间 0 被假定为空且空闲时的初始化偏差,得出一些一般性结论。
- 作业以随机方式按泊松过程进入一个作业车间,总体速率是平稳的,每 8 小时工作日两个作业。作业有四种类型。它们按类型决定的固定顺序从一个工作站流向另一个工作站,如下所示。每种类型的比例也一并给出。
作业类型及其流经工作站的顺序与比例
| 类型 | 流经的工作站 | 比例 |
|---|---|---|
| 1 | 1, 2, 3, 4 | 0.4 |
| 2 | 1, 3, 4 | 0.3 |
| 3 | 2, 4, 3 | 0.2 |
| 4 | 1, 4 | 0.1 |
每个作业在每个工作站上的加工时间取决于类型,但所有时间都近似服从正态分布,其均值与标准差(以小时计)如下:
各类型在各工作站的加工时间(均值, 标准差)
| 类型 | 工作站 | |||
|---|---|---|---|---|
| 1 | 2 | 3 | 4 | |
| 1 | (20, 3) | (30, 5) | (75, 4) | (20, 3) |
| 2 | (18, 2) | (60, 5) | (10, 1) | |
| 3 | (20, 2) | (50, 8) | (10, 1) | |
| 4 | (30, 5) | (15, 2) |
工作站 i 有 名工人,4。每个作业在加工时间内占用一个工作站的一名工人。所有作业都按先进先出(first-in–first-out)方式加工,并且假定所有等待作业的队列容量为无限。对系统仿真 800 小时,其前加一段 200 小时的初始化期。假定 。基于 次重复实验,计算四个工作站中每一个的平均工人利用率的 95% 置信区间。另外,计算每种作业类型的平均总响应时间的 95% 置信区间,其中总响应时间就是一个作业在车间中度过的总时间。
修改习题 13,在每个工作站按作业类型赋予优先级。I 型作业优先于 II 型,II 型优先于 III 型,III 型优先于 IV 型。使用 800 小时作为运行长度,200 小时作为初始化期, 次重复实验。计算按类型分组的四个平均总响应时间的 95% 置信区间。另外,在不设优先级的情况下运行模型,并计算同样的置信区间。讨论采用先进先出与采用优先级系统之间的权衡。
考虑一个单服务台队列,泊松到达速率为每分钟 ,服务时间服从正态分布,均值为 5.1 秒,方差为 0.98 秒^2。希望估计这样一位顾客在系统中的平均时间:该顾客到达时发现系统中另有 i 位顾客;也就是说,要估计
其中 W 是一个典型的系统时间,N 是到达者所发现的顾客数。例如, 是那些发现系统为空的顾客的平均系统时间, 是那些到达时发现另有 1 位顾客在场的顾客的平均系统时间,依此类推。 的估计 将是所有发现系统中有 i 人的到达者的系统时间的样本均值。绘制 对 i 的图形。提出一个关于 与 i 之间关系的假设,并尝试加以验证。
(a) 以空且空闲为初始条件,仿真 10 小时。

(b) 经过 1 小时的初始化之后,仿真 10 小时。(a) 与 \((\mathrm {b} )\) 的结果是否存在可观察到的差异?

(c) 用均值为 5.1 秒的指数分布服务时间重复 (a) 和 (b)。

(d) 用等于 5.1 秒的确定性服务时间重复 (a) 和 (b)。

(e) 求出估计 w_0、\(w_{1} , \ldots , w_{6}\)(每个的标准误至多为 3 秒)所需的重复实验次数。重复 (a)–(d),但使用这一重复实验次数。
在 Smalltown 大学,有一台供学生使用的专用图形工作站,位于校园另一侧、远离计算机中心的地方。某天凌晨 2:00,六名学生来到该工作站完成一份作业。每名学生使用工作站 108 分钟,然后离开去计算机中心取他们的图形输出。有 25% 的可能性这次运行没问题,学生就去睡觉。如果不行,该学生就返回工作站并等待,直到工作站空闲。从工作站到计算机中心再返回的往返路程耗时 分钟。计算机在凌晨 5:00 变得不可用。估计六名学生中至少有五名在这 3 小时内完成作业的概率 p。首先作 次重复实验,并计算 的 95% 置信区间。接着,求出把 估计到 0.02 以内所需的重复实验次数,并作这么多次重复实验。重新计算 的 95% 置信区间。
四名工人沿一条输送带均匀间隔地排开。需要加工的物品按速率为每分钟 2 件的泊松过程到达。加工时间服从指数分布,均值为 1.6 分钟。如果某名工人变为空闲,他或她就取走输送带上过来的第一件物品。如果某名工人在物品过来时正忙,该物品就沿输送带向下移动到下一名工人,在相继两名工人之间耗时 20 秒。当一名工人加工完一件物品时,该物品离开系统。如果一件物品经过了最后一名工人,它就在一条环形输送带上被再循环,并在 5 分钟后回到第一名工人处。
管理层希望有均衡的工作负载——也就是说,管理层希望各工人的利用率相等。令 为工人 i 的长期利用率,令 为所有工人的平均利用率。于是,。根据排队论,ρ 可以由 , 估计,其中 次到达每分钟, 个服务台, 分钟是平均服务时间。于是, 因此,平均而言,一名工人有 80% 的时间是忙碌的。
(a) 作 10 次独立重复实验,每次运行长度为 40 小时,其前加一段 1 小时的初始化期。计算 \(\rho_{1}\) 和 \(\rho_{4}\) 的 95% 置信区间。就工作负载的均衡性得出结论。

(b) 基于同样的 10 次重复实验,在显著性水平 \(\alpha = 0 . 05\) 下检验假设 \(H_{0} {:} \rho_{1} = 0 . 8\)。如果检出 0.05 的差异很重要,确定这样的偏差被检出的概率。此外,如果希望以至少 0.9 的概率检出这样的偏差,求出所需的样本量。(提示:关于假设检验的指导,可参见任何一本基础统计学教材。)

(c) 对 \(H_{0} ; \rho_{4} = 0 . 8\) 重复 (b)。

(d) 根据 (a)–(c) 的结果,就工作负载的均衡性为管理层得出结论。
- 在一个小型采石场,一台单斗电铲大约每 10 分钟往装料区倾倒一铲斗石块,两铲之间的实际时间用均值为 10 分钟的指数分布建模很合适。三铲斗石块堆成一堆;每当一堆石块完成,电铲就开始堆新的一堆。
采石场有一辆卡车,一次能运一堆(3 铲斗)。把一堆石块装上车、开到加工厂、卸料并返回装料区,大约需要 27 分钟。做完这些事的合计实际时间用均值为 27 分钟、标准差为 12 分钟的正态分布建模很合适。
当卡车返回装料区时,如果有等待装车的一堆,它就装载并运输另一堆;否则它就保持空闲,直到另一堆准备好。出于安全原因,在完整的一堆等待之前,不发生装车作业。
采石场按这种方式运行一个 8 小时工作日。我们感兴趣的是:如果再购买一辆卡车,估计卡车的利用率以及等待运输的石堆的期望数量。
- Big Bruin 公司计划在北卡罗来纳州 Juneberry 开一家小型杂货店。他们预计会有两条结账通道,其中一条留给用现金付款的顾客。他们想回答的问题是:需要多少辆购物车?
在营业时间(上午 6 点至晚上 8 点),预计付现金的顾客以每小时 8 人的速率到达。所有其他顾客预计以每小时 9 人的速率到达。每种类型的到达间隔时间可以建模为指数分布的随机变量。
购物所花的时间用正态分布建模,均值为 40 分钟,标准差为 10 分钟。购物后结账所需时间可以用对数正态分布建模:(a) 对付现金的顾客,均值为 4 分钟,标准差为 1 分钟;(b) 对所有其他顾客,均值为 6 分钟,标准差为 1 分钟。
我们假定每位顾客都使用一辆购物车,并且一位购物完毕的顾客把购物车留在店内,使它立即可供另一位顾客使用。我们还假定任何无法立即取得购物车的顾客会恼怒地离开商店。
Big Bruin 关心的首要性能度量是使用中的购物车的期望数量,以及每天损失的顾客的期望数量。请为该店推荐一个购物车数量,记住购物车很贵,但失去顾客同样代价高昂。
建立一个 M/M/1 队列中系统总时间的仿真模型,服务速率为 因此流量强度为 , 即到达率。用该仿真结合绘制总体平均的技术,研究当队列从空启动时的流量强度对初始化偏差的影响。具体地,观察初始化阶段 对 如何变化。
许多仿真软件工具都带有对输出分析的内置支持。利用网络调研其中某一个产品的功能。
www.bcnn.net 上可用材料清单
SimulationTools.xls